

Collegare un CRM, un ERP, un e-commerce e applicazioni proprietarie pone una domanda apparentemente semplice: come sappiamo che due record rappresentano la stessa entità? La risposta non può basarsi automaticamente su un nome, un indirizzo e-mail o un riferimento visibile. Questi valori cambiano, possono ripetersi e spesso seguono regole diverse in ogni sistema.
Una scelta inadeguata degli identificatori provoca duplicati, aggiornamenti applicati al record sbagliato, ordini senza un cliente associato e riconciliazioni manuali che diventano croniche. Una scelta solida non consiste nel trovare un identificatore universale e magico, ma nel definire quale sistema riconosce quale entità, con quale chiave, per quanto tempo e secondo quali regole di modifica.
Questo quadro aiuta a scegliere tra ID interni, riferimenti di business, ID esterni e tabelle di corrispondenza, senza esporre informazioni non necessarie né accoppiare i sistemi in modo fragile.
Perché i campi visibili non risolvono l'identità
Il nome di un'azienda può essere scritto in vari modi, cambiare dopo una fusione o essere condiviso da organizzazioni diverse. Il nome di una persona presenta ancora più collisioni. L'indirizzo e-mail può essere modificato, riutilizzato, appartenere a un account condiviso o mancare in determinati flussi. Persino un riferimento commerciale può essere univoco solo all'interno di una filiale, di un canale o di un periodo.
Questi campi restano utili per cercare, visualizzare e proporre corrispondenze, ma raramente dovrebbero essere la chiave tecnica di un'integrazione. La distinzione importante è la seguente:
- Identità: il record specifico che un sistema considera un'entità.
- Attributi: dati che descrivono tale entità, come nome, e-mail, telefono o indirizzo.
- Riferimento di business: un codice con significato operativo, come un numero d'ordine o un codice cliente.
Confondere questi livelli è una causa frequente di errori. Per esempio, un indirizzo non identifica necessariamente un cliente: la stessa persona può avere più indirizzi e più persone possono condividerne uno. Allo stesso modo, un ordine identifica una transazione, non l'acquirente in modo permanente.
Tipi di identificatore e funzione di ciascuno
Prima di progettare messaggi o endpoint, è opportuno classificare le chiavi disponibili. Ogni tipo presenta vantaggi e limiti.
- ID interno: chiave generata e controllata da un sistema, di norma stabile e priva di significato di business. È la scelta migliore per operare nel proprio dominio.
- Riferimento di business: codice leggibile o operativo, come un riferimento d'ordine. Agevola assistenza e riconciliazione, ma può cambiare formato, ricominciare per serie o essere riutilizzato.
- ID esterno: identificatore che un sistema ricevente conserva per ricordare il record di un sistema emittente. È utile quando esiste una chiara relazione di provenienza.
- Identificatore composto: combinazione di valori, per esempio
origine + tipo di entità + id. È indispensabile quando un ID è univoco solo all'interno di un sistema. - Identificatore temporaneo: chiave di correlazione per un processo non ancora consolidato. Deve scadere e non diventare accidentalmente un'identità permanente.
Una regola pratica consiste nel mantenere l'ID interno di ogni applicazione come autorità locale. Quando si scambiano dati, l'identificatore minimo sicuro è solitamente un valore con uno spazio dei nomi esplicito. Per esempio:
{
  "entity_type": "customer",
  "source_system": "ecommerce",
  "source_id": "C-48291"
}
Il valore C-48291, da solo, non è necessariamente univoco a livello globale. Il contesto di origine impedisce che un altro sistema interpreti una coincidenza testuale come un'identità condivisa.
Domande a cui rispondere prima di condividere un ID
Non scegliete una chiave per comodità di implementazione. Decidete prima il modello di proprietà e il ciclo di vita. Queste domande rivelano se un identificatore è adatto a transitare tra sistemi:
- Quale sistema crea l'entità e quale è la fonte di verità per ciascun attributo?
- Il valore è univoco in tutta l'organizzazione oppure solo in un'applicazione, un Paese, un canale o un tipo di entità?
- Può cambiare? Se cambia, il valore precedente viene conservato e l'evento viene pubblicato?
- Può essere riutilizzato dopo una disattivazione, un annullamento o un periodo di conservazione?
- Contiene dati personali, informazioni commerciali sensibili o schemi facili da indovinare?
- Un record può essere unito a un altro o suddiviso in più record?
- Quale comportamento deve adottare il destinatario quando non trova una corrispondenza?
Un ID condiviso deve essere stabile, univoco nel proprio contesto, non riutilizzabile e sufficientemente opaco per l'uso previsto. Se un riferimento di business non soddisfa queste condizioni, usatelo come attributo verificabile, non come chiave di aggiornamento.
Occorre inoltre separare l'identità tecnica dall'autorizzazione. Conoscere un identificatore non deve consentire di leggere o modificare un'entità. Le API devono verificare che il chiamante disponga dell'autorizzazione per operare su quella risorsa ed evitare ID prevedibili come unico meccanismo di protezione.
Quando propagare l'ID di origine e quando usare una tabella di corrispondenza
Propagare l'ID di origine è ragionevole quando un'entità nasce in un sistema chiaramente autorevole e gli altri sistemi devono soltanto riconoscerla. Per esempio, l'e-commerce può creare un ordine e l'ERP può memorizzare l'identificatore dell'ordine e-commerce come riferimento esterno. Questo modello riduce l'ambiguità e permette di tracciare la provenienza.
Tuttavia, non tutti i domini hanno un'unica autorità. Un cliente può arrivare da vendite, e-commerce, assistenza o importazioni storiche. In tali casi, imporre l'ID di uno dei sistemi come chiave universale crea dipendenza e può trasformare una futura migrazione in un progetto ad alto rischio.
Una tabella di corrispondenza è preferibile quando esistono più sistemi master, un consolidamento graduale, fusioni di record o regole di identità complesse. Dovrebbe conservare almeno il tipo di entità, il sistema, l'ID locale, l'ID canonico se esiste, lo stato del collegamento, la data di creazione e l'evidenza o la regola che giustifica la relazione.
Evitate una tabella che metta in relazione soltanto due colonne senza contesto. Lo stesso valore può esistere per tipi diversi e un collegamento può essere confermato, provvisorio, rifiutato o sostituito dopo una fusione. Trattate questa mappatura come un dato operativo soggetto a audit, non come una configurazione invisibile nel codice.
Nuove registrazioni, duplicati e fusioni: progettare per i casi scomodi
Quando arriva una nuova registrazione senza un identificatore comune, il destinatario non dovrebbe presumere né che si tratti di una nuova entità né che una corrispondenza basata sull'e-mail sia definitiva. Deve applicare una politica esplicita:
- Creare un nuovo record e lasciarlo non collegato quando non esistono prove sufficienti.
- Proporre una corrispondenza quando più attributi coerenti superano una soglia definita dal business.
- Richiedere una revisione umana per unire record con conseguenze finanziarie, contrattuali o di assistenza clienti.
- Registrare la decisione, la regola applicata e gli ID coinvolti.
La deduplicazione automatica è particolarmente rischiosa quando il costo di un'unione errata supera quello di mantenere due record in sospeso. Unire per errore due clienti può mescolare fatture, consensi o comunicazioni. Al contrario, un duplicato rilevato può essere risolto mediante una coda di revisione.
Le fusioni richiedono una semantica specifica. Definite un record superstite, conservate gli ID storici come alias o reindirizzamenti e pubblicate la modifica affinché i sistemi consumatori aggiornino i loro collegamenti. Non eliminate immediatamente l'ID assorbito: processi asincroni, tentativi ripetuti e record storici possono continuare a farvi riferimento.
Modifiche, disattivazioni e riattivazioni senza interrompere la tracciabilità
Idealmente, un identificatore tecnico non cambia. Se un riferimento di business deve cambiare, l'evento deve comunicare sia il valore precedente sia quello nuovo e spiegarne la causa. Non interpretate mai il silenzio come una disattivazione: possono verificarsi ritardi, errori di consegna o filtri di sincronizzazione.
Per le disattivazioni, utilizzate stati espliciti come attivo, inattivo, annullato, eliminato o fuso, a seconda del dominio. L'eliminazione fisica può essere necessaria per requisiti di privacy, ma deve essere progettata insieme alla tracciabilità: potrebbe essere possibile conservare un marcatore tecnico non identificabile o la prova che un collegamento non deve più essere ricreato.
Non riutilizzate riferimenti già emessi, anche se il record è inattivo. Il riutilizzo trasforma dati storici corretti in ambiguità futura. Se una riattivazione rappresenta la stessa entità, mantenete l'ID; se rappresenta una nuova entità, assegnatene uno nuovo e documentate la relazione solo se apporta valore operativo.
Progettazione di API, messaggi e controlli operativi
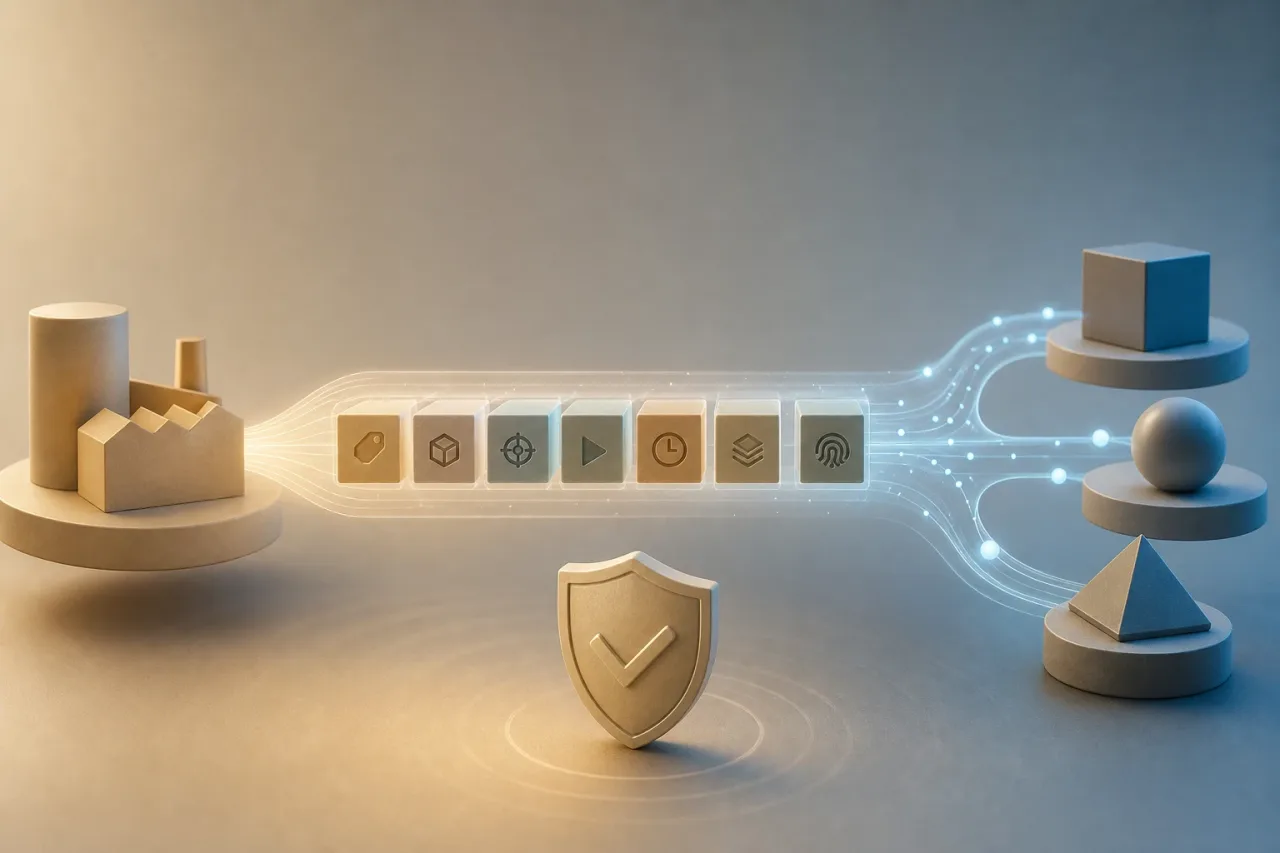
Un contratto di integrazione deve trasportare un contesto sufficiente, ma non più dati del necessario. Includete tipo di entità, sistema di origine, ID di origine, operazione, marca temporale, versione o sequenza quando applicabile e un identificatore dell'evento per gestire i tentativi ripetuti. L'idempotenza evita di creare più volte la stessa entità quando una consegna viene ripetuta.
Per gli aggiornamenti, date priorità a un'operazione che indichi chiaramente la chiave utilizzata. Se è consentita la ricerca per riferimento di business, trattate un risultato multiplo come un errore controllato, non come un invito a scegliere il primo record.
I controlli operativi devono trasformare i problemi di identità in segnali visibili:
- avvisi per corrispondenze ambigue e messaggi senza corrispondenza;
- code per collegamenti in sospeso e revisioni delle fusioni;
- metriche sui duplicati creati, sui collegamenti interrotti e sugli errori ricorrenti per sistema;
- riconciliazioni periodiche tra conteggi, stati e collegamenti attesi;
- log che includano ID tecnici e di correlazione, senza esporre attributi personali non necessari.
Prima di sviluppare, documentate per ogni entità il sistema autorevole, l'ID locale, le chiavi esterne accettate, le regole di univocità, la politica delle modifiche, gli stati di disattivazione e la strategia di deduplicazione. Questa decisione riduce l'accoppiamento oggi e rende gestibili una futura migrazione, un audit o l'introduzione di un nuovo canale.