

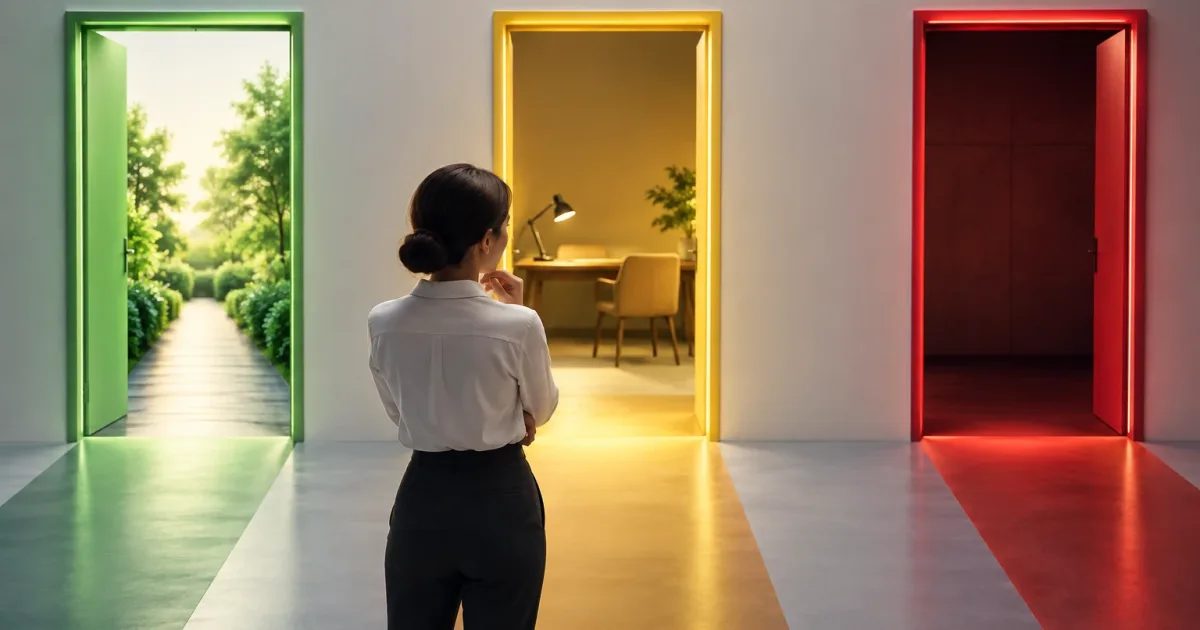
Una classificazione automatica non dovrebbe essere accettata solo perché il modello assegna un punteggio elevato. Quel punteggio esprime una stima del sistema, non garantisce che la categoria sia corretta né che la decisione sia appropriata per il processo. Per decidere come gestire ogni risultato, occorre combinare la qualità della previsione con il costo di un errore, la possibilità di revisione e le conseguenze operative.
Un quadro pratico distingue tre percorsi: accettazione automatica, revisione umana e rifiuto della previsione o invio a un processo alternativo. I confini tra questi percorsi possono variare in base alla categoria e cambiare nel tempo. L’obiettivo non è massimizzare l’automazione a ogni costo, ma automatizzare i casi sufficientemente sicuri e rendere visibili quelli che richiedono attenzione.
Un punteggio di confidenza non è una decisione
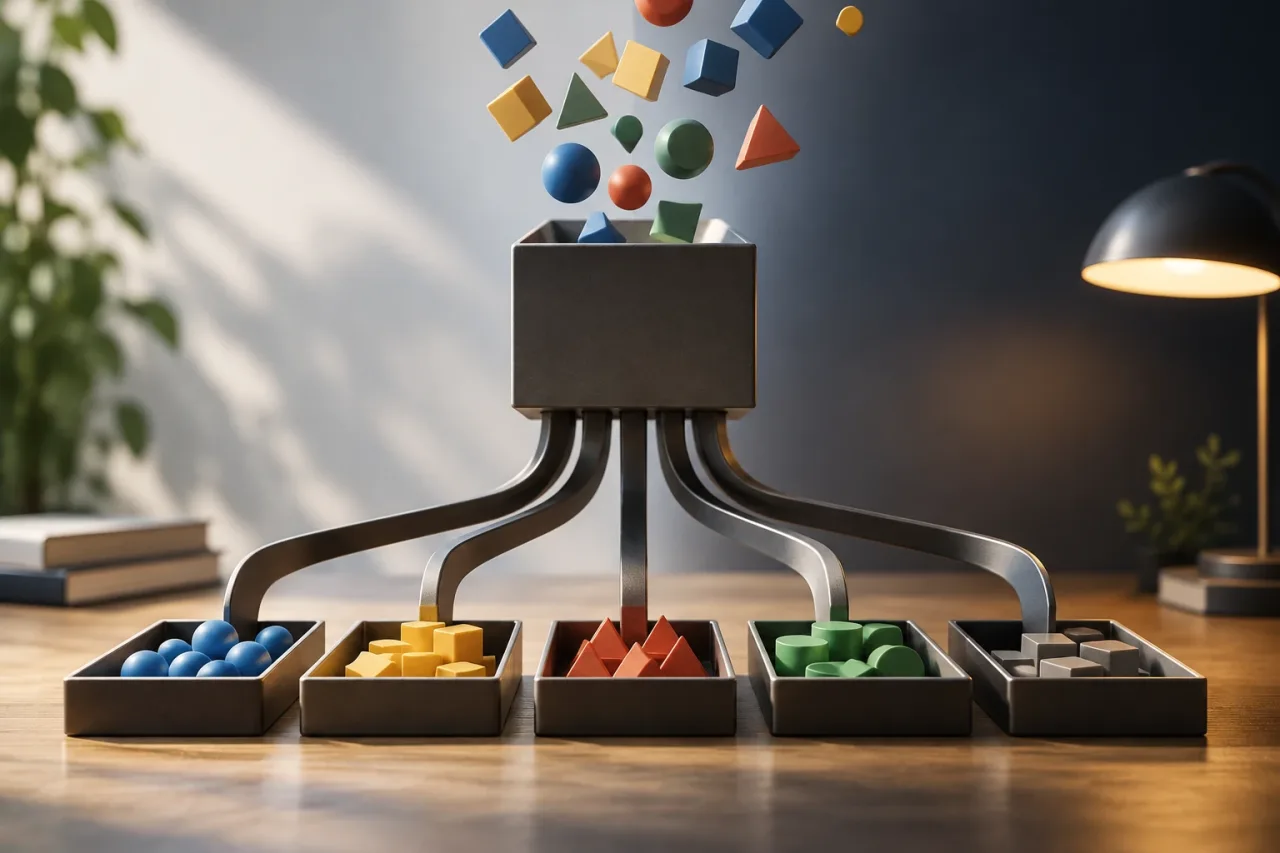
I classificatori possono restituire una categoria e il relativo punteggio. Tuttavia, un punteggio pari a 0,9 non significa necessariamente che il risultato abbia il 90% di probabilità di essere corretto nello specifico contesto d’uso. L’interpretazione dipende da come il modello è stato addestrato e valutato, dalla rappresentatività dei dati e dalla calibrazione dei punteggi.
Inoltre, lo stesso punteggio può comportare rischi diversi. Classificare una richiesta di informazioni come “generale” invece che “fatturazione” può causare un ritardo limitato; classificare una richiesta urgente come ordinaria può avere conseguenze più importanti. Perciò, non è opportuno fissare un’unica soglia per tutte le classi senza prima analizzare il costo di ciascun tipo di errore.
Prima di automatizzare, verifica che cosa rappresenta il punteggio disponibile, come si comporta su dati rappresentativi e se il modello può astenersi quando non trova una risposta sufficientemente chiara. Se il punteggio non è calibrato, usalo come indicatore per ordinare o dare priorità ai casi, non come probabilità esatta.
Calcola il costo degli errori per categoria
Per ogni classe, confronta due tipi di errore: il falso positivo, quando il sistema assegna una categoria non pertinente, e il falso negativo, quando non rileva una categoria che invece era pertinente. In una classificazione multiclasse, è utile specificare quali confusioni siano davvero dannose: non tutte le categorie errate hanno lo stesso impatto.
Una matrice di confusione per categoria aiuta a individuare gli errori frequenti, ma le metriche non sostituiscono l’analisi del flusso di lavoro. Chiedi al team operativo che cosa succede dopo l’assegnazione di ogni etichetta: viene inviata una comunicazione? Un caso viene assegnato a un team? Si attiva una priorità? Un documento viene archiviato? Registra l’impatto in termini pratici, come rilavorazioni, ritardi, mancato rispetto di una procedura o rischi per le persone coinvolte, senza presumere che ogni errore abbia un costo monetario noto.
- Errori reversibili e a basso impatto: può essere ragionevole automatizzare una quota maggiore dei casi, se è disponibile un modo semplice per correggerli.
- Errori difficili da rilevare o correggere: richiedono soglie più prudenti e controlli aggiuntivi.
- Categorie con conseguenze rilevanti: in base alla policy del processo, possono richiedere una revisione umana anche in presenza di punteggi elevati.
Il risultato è una policy per classe: quali errori sono tollerabili, quali richiedono una revisione e quali impongono di interrompere o reindirizzare l’automazione.
Suddividi i risultati tra accettazione, revisione e rifiuto
Definisci due soglie di punteggio anziché una. Al di sopra della soglia superiore, il sistema può proporre l’accettazione automatica; tra le due soglie, il caso passa alla revisione; al di sotto della soglia inferiore, la previsione automatica viene rifiutata oppure il caso viene inviato a un percorso alternativo. In questo contesto, “rifiutare” significa non usare la classificazione come decisione finale, non respingere la richiesta della persona.
Le soglie non devono necessariamente essere uguali per tutte le classi. Se confondere due categorie produce effetti diversi, possono servire soglie distinte o regole specifiche per quelle confusioni. Si può anche richiedere una condizione aggiuntiva, per esempio che la categoria più probabile superi la seconda di un margine minimo. Questa differenza può aiutare a individuare risultati ambigui, ma va valutata con dati del flusso di lavoro effettivo.
Documenta chiaramente ogni percorso: chi può correggere un risultato, che cosa accade quando il sistema non risponde e come viene registrata la decisione finale. Un risultato con bassa confidenza deve avere una destinazione operativa definita; altrimenti, il team finirà per inventare eccezioni caso per caso.
Calibra il modello con esempi rappresentativi e verificati
Raccogli esempi che riflettano l’uso reale: categorie comuni e poco frequenti, testi brevi e lunghi, formati diversi, casi ambigui ed errori di input prevedibili. Includi campioni dei canali e dei gruppi che alimenteranno il sistema. Un insieme composto solo da casi facili può far apparire le prestazioni migliori di quelle che si otterranno in produzione.
Per ogni esempio, registra l’etichetta corretta secondo un criterio concordato e stabilisci come risolvere eventuali disaccordi. Separa i dati usati per regolare la policy da quelli riservati alla sua verifica. Per ogni soglia candidata, misura almeno quanti casi verrebbero accettati automaticamente, quale proporzione di tali casi sarebbe corretta per ciascuna classe e quanti passerebbero alla revisione. Aggiungi una valutazione degli errori in base al loro impatto operativo.
- Definisci le classi e le conseguenze di ogni errore insieme alle persone responsabili del processo.
- Costruisci un campione rappresentativo e verifica le etichette, risolvendo gli eventuali disaccordi.
- Prova più soglie e calcola precisione, copertura automatica e carico di revisione per classe.
- Scegli la policy che soddisfa i requisiti di rischio e capacità operativa, non solo una metrica aggregata.
- Convalida la decisione su dati separati prima di applicarla in produzione.
Il quadro di gestione dei rischi dell’IA del NIST offre un riferimento per organizzare l’identificazione, la valutazione e la gestione dei rischi. Non fornisce una soglia universale da copiare: la decisione deve rispondere al contesto, ai dati e all’impatto del sistema specifico.
Progetta la revisione umana come parte del prodotto
La revisione non è un’eccezione tecnica da risolvere inviando i casi a una casella. Definisci chi revisiona, quali informazioni gli servono, quanto tempo può dedicare e quali azioni può intraprendere. Mostra la categoria suggerita e il contesto pertinente, ma consenti di correggerla, chiedere informazioni o inoltrare il caso quando lo prevede la policy.
Registra l’etichetta finale e, se possibile, il motivo della correzione. Questi dati servono a individuare confusioni ricorrenti e a preparare miglioramenti; non vanno incorporati automaticamente nell’addestramento senza controlli di qualità. Se le persone che revisionano non condividono gli stessi criteri, le loro decisioni possono aggiungere rumore invece di ridurlo.
Monitora anche il carico di lavoro: una quota di revisione molto elevata può trasformare l’automazione in un collo di bottiglia. Se il volume supera la capacità prevista, assegna le priorità in base all’impatto, all’urgenza o all’anzianità del caso e valuta se modificare il modello, le categorie o le soglie. Non allentare le soglie improvvisando per ridurre la coda.
Monitora e rivedi la policy decisionale
Misura i risultati per classe e per segmenti rilevanti del processo. Come minimo, monitora la precisione delle accettazioni automatiche, il tasso di revisione, la percentuale di rifiuti o reindirizzamenti, gli errori rilevanti e il tempo necessario per risolvere i casi. Una metrica complessiva può nascondere il fatto che una categoria minoritaria fallisca sistematicamente.
Confronta le previsioni con risultati verificati e stabilisci una frequenza di revisione adeguata al rischio e al volume. Rivaluta la policy se cambiano le categorie, i moduli, i canali, il modello o le regole operative. Esamina anche segnali come l’aumento delle correzioni umane, un cambiamento nella distribuzione delle classi o un maggior numero di casi al di fuori degli schemi noti. Sono indizi da analizzare, non la prova automatica che il modello sia peggiorato.
Conserva le versioni delle soglie, le evidenze usate per approvarle e la data della revisione. Anche la gestione dei dati e la loro qualità sono importanti: definizioni incoerenti o etichette non aggiornate indeboliscono qualsiasi calibrazione. Il corpus di conoscenze di DAMA International può servire come riferimento generale per strutturare le pratiche di gestione dei dati.
Lista di controllo per iniziare
- Ogni categoria ha una definizione operativa e alcuni esempi limite?
- Sono stati confrontati i falsi positivi e i falsi negativi in base alle loro conseguenze?
- Le soglie distinguono tra accettazione, revisione e reindirizzamento e possono variare per classe?
- La valutazione usa dati rappresentativi ed etichette verificate?
- Sono disponibili personale, istruzioni per la revisione e un percorso di escalation?
- Gli errori, la copertura e il carico di revisione vengono misurati per classe?
- Sono stati definiti responsabili, registrazioni e criteri espliciti per rivalutare la policy?
In sintesi, definire soglie di confidenza significa progettare una policy decisionale, non scegliere un numero isolato. Parti dal costo degli errori, convalida le soglie con casi reali e mantieni un percorso sicuro per i casi incerti. In questo modo, l’automazione può crescere senza confondere un punteggio del modello con una decisione affidabile.