

Distribuire un’applicazione in più regioni può sembrare un modo diretto per ridurre le interruzioni o avvicinare il servizio agli utenti. Ma distribuire l’infrastruttura introduce anche nuove decisioni: come replicare i dati, cosa accade se una regione resta isolata e chi è in grado di gestire l’insieme. La domanda non è quante regioni siano possibili, ma quale problema concreto risolverebbe la seconda regione e se il team è in grado di sostenere la soluzione.
La decisione dipende dagli obiettivi del servizio, dalle sue dipendenze e dalle conseguenze di un’interruzione. Un’architettura semplice, monitorata con attenzione e con procedure di ripristino collaudate può essere più adatta di una configurazione multiregionale che nessuno ha mai verificato. Questa guida propone criteri per confrontare le alternative e procedere gradualmente.
Cosa significa distribuire in una o più regioni
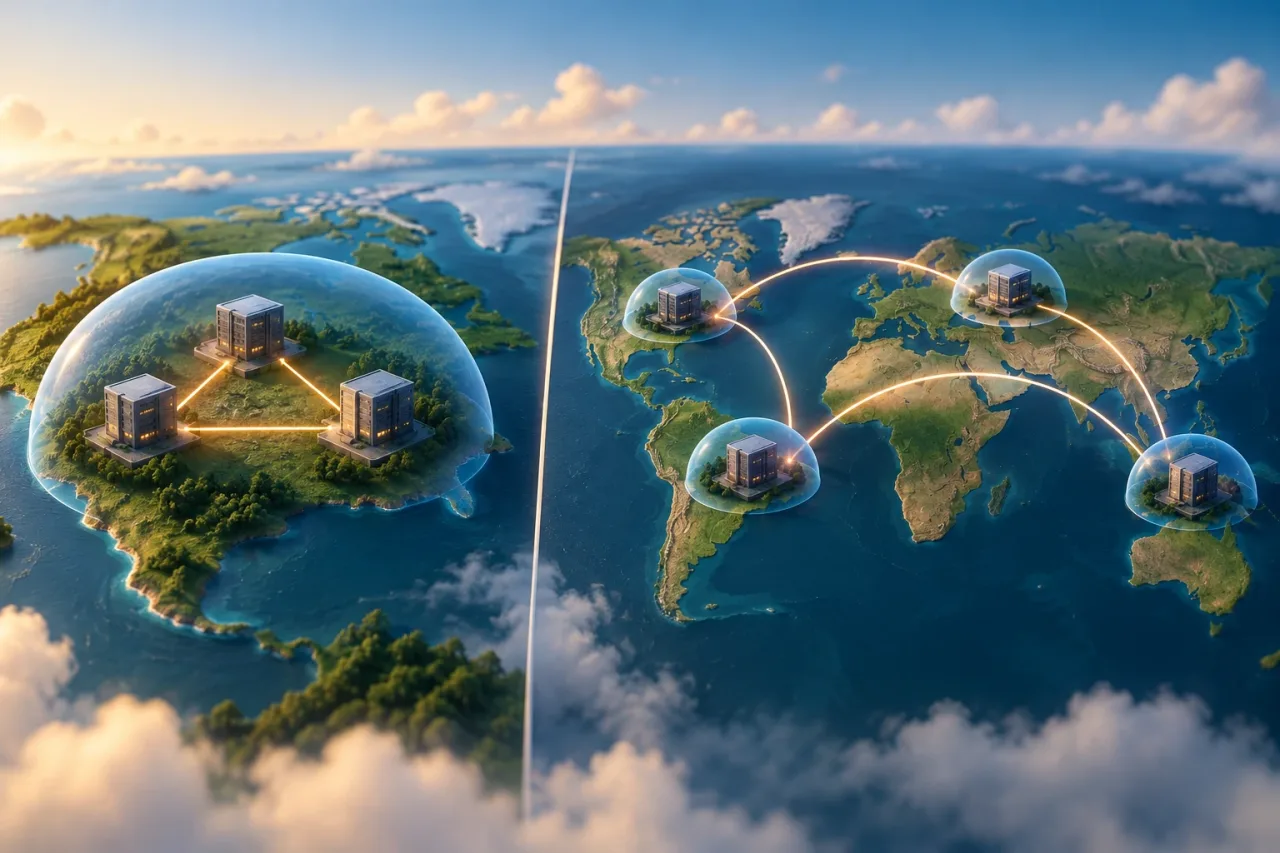
Una regione è una località geografica all’interno dell’infrastruttura cloud. Un’applicazione distribuita in una sola regione concentra lì i suoi componenti principali, anche se questi possono essere distribuiti in diverse zone di disponibilità. Più zone all’interno di una regione aiutano a fronteggiare alcuni guasti locali, ma non equivalgono a una seconda regione pronta all’uso.
In un deployment multiregionale, i componenti dell’applicazione operano, o possono operare, da località geografiche diverse. La configurazione può variare: una regione può gestire il traffico abituale e un’altra restare pronta per il ripristino; oppure entrambe possono essere attive e ricevere richieste. Queste opzioni comportano requisiti diversi per dati, instradamento e gestione operativa.
È utile definire innanzitutto l’ambito. Un’applicazione può avere server in più regioni e dipendere comunque da un database, un sistema di identità o un’integrazione che funziona in una sola. In questo caso, distribuire il livello applicativo non significa che l’intero servizio possa continuare a funzionare in caso di perdita di una regione.
Individua il problema prima di scegliere l’architettura
Le ragioni più comuni per valutare più regioni rientrano in tre obiettivi. Ognuno richiede verifiche e decisioni diverse:
- Continuità: mantenere o ripristinare il servizio se una regione non è disponibile. Occorre precisare quanto può durare l’interruzione e quanti dati potrebbero andare persi o dover essere ricostruiti.
- Latenza: ridurre i tempi di risposta per utenti distribuiti geograficamente. Il beneficio dipende dalla posizione degli utenti e dalla possibilità di gestire localmente le operazioni critiche, inclusi dati e dipendenze.
- Localizzazione dei dati: rispettare requisiti di residenza, trattamento o accesso alle informazioni. Conservare copie in luoghi diversi può complicare, anziché risolvere, gli obblighi applicabili; occorre verificarli per ogni tipo di dato.
Definire l’obiettivo in modo misurabile evita di adottare una soluzione basata sull’intuizione. Per la continuità, concorda gli obiettivi di ripristino per il servizio e i suoi dati. Per la latenza, misura i percorsi reali degli utenti. Per la residenza, individua quali dati devono rimanere in quali località e quali componenti li elaborano.
Quando può bastare una regione gestita bene
Una sola regione può essere sufficiente quando l’impatto di un’interruzione è accettabile, gli utenti sono concentrati in un’area o la latenza attuale soddisfa le esigenze del prodotto. Può anche essere la scelta più sensata se il team non dispone ancora dei processi necessari per testare e gestire una seconda località.
Prima di aggiungere regioni, verifica le misure di resilienza disponibili nell’architettura attuale. Tra queste possono esserci la ridondanza tra zone, i backup, procedure di ripristino documentate, il monitoraggio delle dipendenze e una strategia di deployment reversibile. Un backup protegge solo se è possibile ripristinarlo e si è verificato che il risultato consenta di recuperare il servizio.
Analizza gli incidenti e le interruzioni precedenti: sono stati causati da un guasto regionale, da una modifica software, da una dipendenza esterna o da un problema di configurazione? Se il rischio principale non è regionale, aggiungere un’altra località potrebbe aumentare il lavoro senza correggere la causa. Registra anche quanto tempo richiederebbe un ripristino manuale e quali attività dipendono ancora da una persona specifica.
Costi e rischi della distribuzione del servizio
La complessità multiregionale non si limita alla gestione di un maggior numero di risorse. L’applicazione può richiedere decisioni sulla replica, la risoluzione dei conflitti, l’ordine delle operazioni e il comportamento in caso di perdita di connettività. Se due località accettano modifiche alle stesse informazioni, il progetto deve specificare qual è la fonte autorevole e come gestire le scritture simultanee.
La coerenza è una decisione di prodotto e di architettura. Un ritardo nella replica può indurre un utente a leggere uno stato precedente o causare conflitti tra due operazioni. In alcuni casi può essere accettabile, ma non è opportuno presumere che tutte le funzioni tollerino questo comportamento. Definisci quali azioni richiedono una risposta coerente immediata e quali potrebbero funzionare temporaneamente con dati non aggiornati.
Occorre inoltre verificare le dipendenze esterne, la gestione delle identità, le code, lo storage, il DNS o l’instradamento, l’osservabilità e i processi di deployment. Ogni elemento può diventare un punto singolo di guasto oppure richiedere una configurazione specifica per regione. I costi operativi comprendono test, turni di reperibilità, analisi degli incidenti e manutenzione delle procedure, oltre all’infrastruttura.
Valuta se i percorsi critici possono funzionare in ogni regione
Mappa le azioni essenziali degli utenti, dalla richiesta iniziale alla conferma finale. Per ciascun percorso, annota i servizi e i dati coinvolti, dove si trovano e cosa accade se la regione principale smette di rispondere. L’unità di analisi è il percorso completo, non un singolo server.
- Classifica le funzioni: distingui quelle indispensabili per operare da quelle che possono degradarsi o restare temporaneamente indisponibili.
- Traccia le dipendenze: includi servizi interni, sistemi esterni e processi operativi che non compaiono nel diagramma dell’infrastruttura.
- Descrivi il guasto: analizza la perdita totale, i problemi di connettività parziale e il ripristino. Chiarisci chi rileva il problema e come viene deciso il cambio del traffico.
- Convalida i dati: determina quali scritture devono essere disponibili, quale ritardo è accettabile e come risolvere duplicati o conflitti.
- Verifica il risultato: assicurati che le operazioni visibili agli utenti vengano completate, non soltanto che i componenti rispondano.
Questa analisi rivela se le regioni sono davvero indipendenti o se la seconda località dipende da risorse che si trovano ancora nella prima. Permette inoltre di dare priorità a un miglioramento mirato, come rendere ripristinabile una dipendenza critica, invece di replicare l’intera piattaforma.
Regione secondaria o servizio attivo in più regioni
Una regione secondaria destinata al ripristino si concentra in genere sul ristabilire il servizio se la regione principale si guasta. Il team deve decidere quali componenti mantenere pronti, come attivarli e quali dati saranno disponibili al ripristino. Il passaggio può richiedere un intervento: i tempi effettivi vanno quindi verificati con test, non dedotti dal progetto.
Un servizio attivo in più regioni può gestire abitualmente il traffico da più località. Questo può favorire la latenza o la continuità, ma richiede di risolvere questioni di instradamento, distribuzione del carico e gestione dei dati tra regioni. Non significa necessariamente che tutte le operazioni siano indipendenti o che il passaggio in caso di guasto sia automatico e corretto.
La scelta dipende dagli obiettivi concordati e dalla capacità operativa. Se il servizio può tollerare un ripristino pianificato, può bastare una regione secondaria. Se deve funzionare in parallelo per soddisfare esigenze di disponibilità o reattività, una configurazione attiva può essere appropriata, purché le regole sui dati e i test siano sostenibili.
Decidi sulla base di evidenze e procedi per gradi
Coinvolgi i team di prodotto, tecnologia e operations per rispondere a quattro domande: quale sarebbe l’impatto di un’interruzione? Dove si trovano gli utenti e i dati? Quale livello di ripristino è accettabile? Chi è in grado di gestire e testare l’architettura? Registra ipotesi e incertezze. Se manca una risposta a una domanda critica, questa lacuna informativa costituisce un rischio da affrontare prima di ampliare il deployment.
In seguito, convalida l’alternativa più semplice che consenta di imparare. Può trattarsi di misurare la latenza per località, ripristinare una copia in un ambiente separato o provare il recupero di una dipendenza. Se testi il passaggio, definisci ambito, responsabili, condizioni di avvio e criteri di successo; verifica anche come tornare allo stato abituale e riconciliare i dati.
Riconsidera la decisione quando cambiano la distribuzione degli utenti, i requisiti relativi ai dati, l’impatto di un’interruzione o la composizione del servizio. L’architettura adeguata è quella che soddisfa obiettivi espliciti e di cui il team sa dimostrare la capacità di ripristino. Più regioni possono essere la risposta, ma non sono un obiettivo in sé: il valore consiste in un miglioramento verificabile rispetto a un’alternativa più semplice.