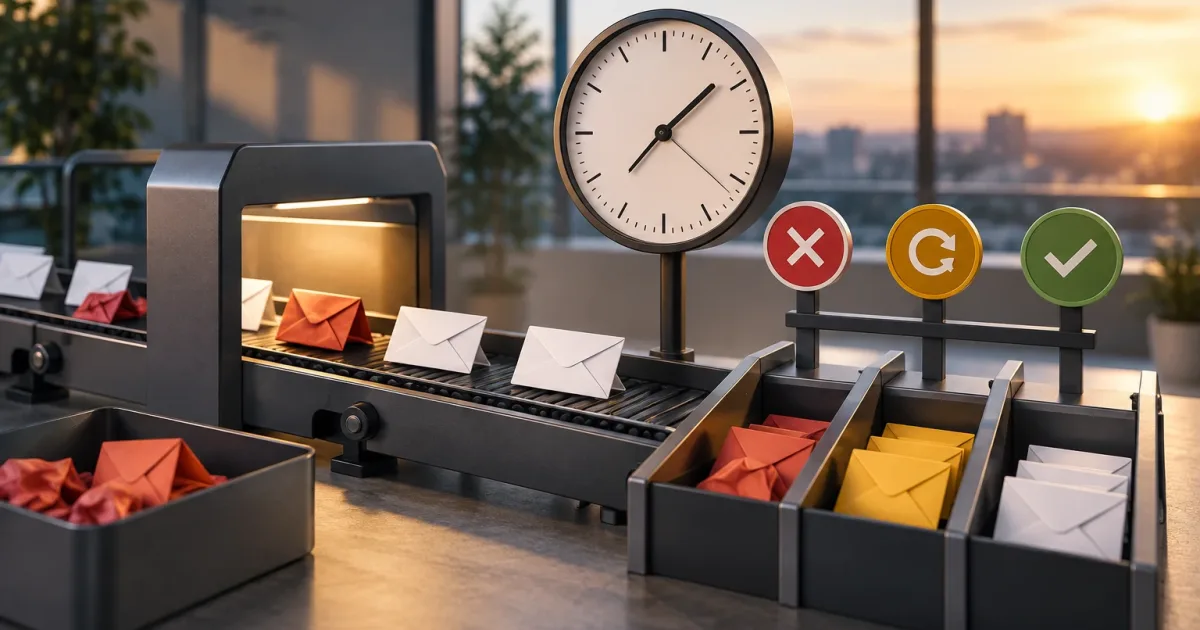
Un messaggio che non va a buon fine non deve sempre essere ritentato subito, né conservato a tempo indeterminato. Una notifica di pagamento in sospeso, un aggiornamento dell’inventario e un promemoria di appuntamento hanno urgenza diversa e un valore differente quando arrivano in ritardo. Per questo, decidere per quanto tempo ritentare i messaggi non riusciti è una scelta aziendale e operativa, oltre che una configurazione tecnica.
La policy deve rispondere a tre domande: quali tipi di errore possono essere recuperati, per quanto tempo è ancora utile eseguire l’evento e cosa accade quando la scadenza viene superata. Concordare queste risposte riduce sia gli abbandoni silenziosi sia le esecuzioni tardive che confondono i clienti o lasciano i sistemi in stati incoerenti.
Perché un messaggio ritentato a lungo può diventare un problema
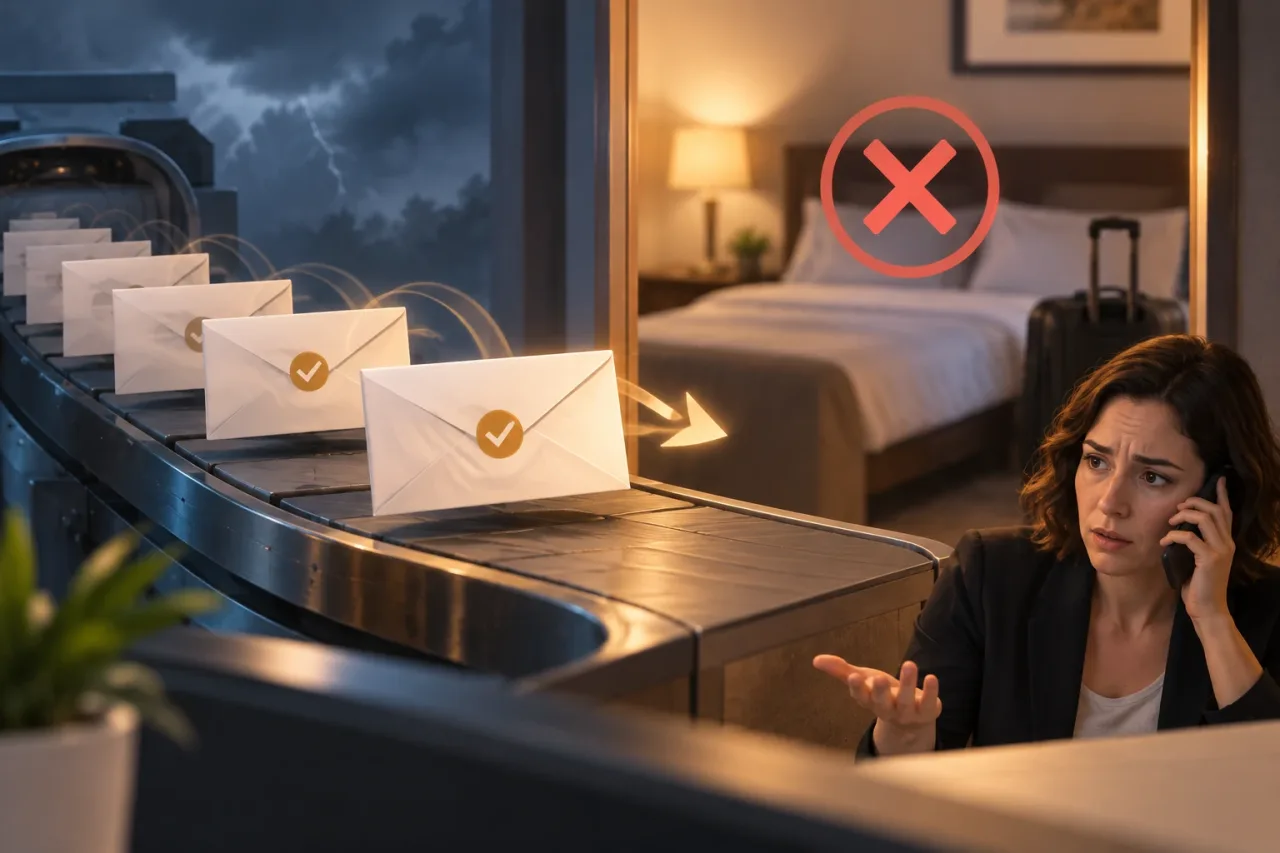
Un nuovo tentativo può recuperare un’operazione dopo un’interruzione breve. Tuttavia, ogni tentativo consuma risorse e può produrre effetti indesiderati se l’azione viene eseguita quando ormai non è più valida. Per esempio, inviare una conferma dopo la cancellazione di una prenotazione può generare richieste di chiarimento e lavoro per l’assistenza, anche se il messaggio è stato infine consegnato.
Il rischio non riguarda solo il ritardo. Una coda di eventi vecchi può rendere più difficile gestire i messaggi recenti, mentre ritentare una richiesta dall’esito incerto può duplicare un’operazione. La policy, quindi, non dovrebbe puntare a massimizzare il numero di tentativi: dovrebbe aumentare la probabilità di completare le azioni che hanno ancora valore, limitando i danni di quelle che arrivano tardi.
È utile distinguere la conservazione tecnica — per quanto tempo il sistema conserva l’evento — dalla finestra di validità — fino a quando è consentito eseguirlo. I due periodi possono coincidere, ma non è necessario. Un evento può essere conservato anche dopo la scadenza per analizzare quanto è accaduto, senza che ciò autorizzi a elaborarlo di nuovo automaticamente.
Classificare gli errori prima di definire la finestra
Il codice di errore, la risposta dell’integrazione e lo stato del processo aiutano a decidere se un errore merita un altro tentativo. Come quadro operativo, suddividi i casi in tre gruppi e stabilisci l’azione corrispondente:
- Transienti: interruzioni di rete, limiti temporanei del servizio o indisponibilità momentanee. Possono giustificare un nuovo tentativo, purché l’azione sia ancora valida.
- Permanenti: dati non validi, destinatario inesistente o richiesta rifiutata per una condizione che non cambierà nel giro di pochi minuti. Ripetere senza correggere la causa raramente è utile; di norma conviene fermarsi e richiedere una correzione o un intervento.
- Ambigui: la connessione si è interrotta e il sistema non sa se il servizio destinatario abbia completato l’operazione. Prima di riprovare, occorre verificare lo stato quando possibile o adottare misure per evitare effetti duplicati.
Non tutte le risposte di un servizio hanno un’interpretazione universale. Una risposta temporanea può dipendere da un problema persistente, mentre un errore che sembra definitivo può essere risolto correggendo i dati. Documenta la classificazione per ogni integrazione e rivedi i casi ricorrenti. Se non riesci a determinare la causa in modo affidabile, evita di considerare tutti gli errori transitori per impostazione predefinita.
Definire la scadenza in base a urgenza, validità e conseguenze
La finestra dei tentativi inizia quando si verifica l’errore e termina quando l’evento non deve più essere eseguito automaticamente. Per stabilirla, concorda con le funzioni aziendali e operative tre criteri:
- Urgenza: quanto ritardo può tollerare il processo prima di compromettere una decisione, una promessa o l’assistenza al cliente?
- Validità: fino a quando il contenuto o l’azione restano corretti? Considera i cambiamenti di stato successivi, come una cancellazione, un pagamento già risolto o un appuntamento trascorso.
- Conseguenze del ritardo: quale costo comporta l’esecuzione dopo quel momento? Potrebbe trattarsi di un messaggio confuso, un aggiornamento errato o un intervento manuale; potrebbe anche essere accettabile completare un’attività interna senza effetti visibili.
Confronta la finestra con il ciclo di vita reale del processo. Un avviso legato a una data imminente può perdere utilità rapidamente; una sincronizzazione del catalogo può invece tollerare un ritardo maggiore. Non adottare un’unica scadenza per tutti gli eventi solo perché semplifica la configurazione. Raggruppa gli eventi per classe di servizio quando le conseguenze sono simili e prevedi eccezioni solo in presenza di una ragione chiara.
Se la validità dipende da uno stato mutevole, non basta contare le ore dal primo errore. Prima di un’esecuzione tardiva, verifica che l’azione sia ancora consentita. Se non è possibile effettuare questo controllo, riduci la finestra o invia il caso a revisione, invece di presumere che l’evento sia ancora valido.
Scegliere intervalli e limiti senza generare picchi
Un intervallo costante e breve può far sì che molti eventi vengano ritentati contemporaneamente durante un’interruzione. Valuta invece intervalli crescenti tra un tentativo e l’altro e un limite massimo di durata o di tentativi. Una separazione progressiva riduce la pressione sul servizio interessato e gli lascia il tempo di riprendersi. Aggiungere una componente casuale agli intervalli può impedire che gruppi di processi sincronizzati effettuino nuove chiamate nello stesso momento.
I parametri dovrebbero basarsi sul comportamento osservato, non su una cifra arbitraria. Verifica quanto durano le interruzioni più comuni, con quale frequenza i tentativi vanno a buon fine e quanto tempo impiega un evento a perdere utilità. Imposta limiti che impediscano tentativi infiniti, ma assicurati che un errore breve abbia una possibilità ragionevole di essere recuperato. Se il servizio segnala che non è ancora il momento di riprovare, rispetta tale indicazione quando l’integrazione lo consente.
È inoltre opportuno separare il limite dei tentativi dalla concorrenza. In caso di un’interruzione estesa, aumentare indiscriminatamente i tentativi può aggravare il problema. Un segnale d’allarme è l’aumento dell’età degli eventi in sospeso insieme al volume degli errori: in tale situazione, controlla lo stato del servizio e limita la pressione, invece di accelerare i tentativi.
Cosa fare quando scade la finestra
La scadenza deve produrre un esito esplicito. Smettere di ritentare senza registrare il risultato equivale a perdere visibilità. Definisci quale delle seguenti opzioni si applica a ciascun tipo di evento:
- Scartare: per gli eventi scaduti e a basso impatto, quando eseguirli non è più valido. Conserva informazioni sufficienti per spiegare lo scarto e individuare eventuali schemi ricorrenti.
- Inviare a revisione manuale: per i casi di impatto rilevante, con causa irrisolta o esito ambiguo. La revisione richiede un responsabile, un contesto e un’azione disponibile: correggere, ritentare in modo controllato o chiudere.
- Avviare una compensazione: quando il processo deve correggere un effetto parziale o ripristinare uno stato concordato. Anche la compensazione deve prevedere condizioni, un responsabile e una registrazione; non è semplicemente un altro tentativo.
Non trasformare la revisione manuale in una coda senza un responsabile. Stabilisci chi se ne occupa, come si definiscono le priorità in base all’età e all’impatto e cosa succede se nessuno interviene entro i tempi concordati. Se gli operatori non possono distinguere un evento recuperabile da uno obsoleto con i dati disponibili, il problema riguarda la progettazione della revisione, non la velocità del team.
Registrare ciò che serve per diagnosticare e intervenire
Per ogni evento conserva un identificativo che consenta di seguirlo, il tipo, lo stato, l’età, il numero e l’ora dei tentativi, la causa registrata, l’azione successiva e la decisione presa alla scadenza. Indica il sistema destinatario quando sono presenti più integrazioni. Evita di memorizzare dati personali o segreti non necessari alla diagnosi e applica le regole pertinenti in materia di accesso e conservazione.
Questi indicatori aiutano a distinguere una policy troppo breve da un problema esterno: percentuale di messaggi recuperati, tempo necessario per il recupero, volume degli eventi in scadenza, cause più frequenti e dimensione ed età della coda di revisione. Interpreta gli indicatori per tipo di evento. Un’elevata percentuale di tentativi riusciti non giustifica l’ampliamento della finestra se i casi recuperati arrivano quando hanno già perso valore.
Lista di controllo per concordare la policy
- Quale effetto aziendale produce l’evento e quando cessa di essere valido?
- Quali errori sono transitori, permanenti o ambigui per ciascuna integrazione?
- Qual è la finestra massima e come si verifica che l’evento sia ancora valido?
- Quali intervalli e limiti evitano pressioni eccessive e tentativi senza fine?
- Alla scadenza, l’evento viene scartato, sottoposto a revisione o compensato? Chi ne è responsabile?
- Quali dati e metriche consentono di spiegare l’esito e migliorare la policy?
In definitiva, per quanto tempo ritentare i messaggi non riusciti dipende da quanto occorre perché la causa scompaia e da quanto valore conserva l’azione nel frattempo. Definisci le finestre in base all’impatto, limita i tentativi, tratta diversamente gli errori permanenti e concorda un esito operativo. Poi rivedi gli eventi che più spesso scadono o richiedono interventi: è lì che si trovano spesso le migliori opportunità per migliorare la classificazione, l’integrazione o il processo stesso.