

Modificare una tabella può sembrare un cambiamento interno, ma raramente un’applicazione in produzione è l’unico componente che usa il database. Durante una distribuzione possono coesistere versioni diverse del servizio; inoltre, query per i report, integrazioni o attività pianificate possono dipendere dallo schema attuale. Se una modifica smette di essere compatibile con uno di questi componenti, può verificarsi un errore visibile o un’interruzione.
La strategia più sicura non consiste nel modificare schema e codice contemporaneamente, ma nel suddividere il lavoro in passaggi compatibili. In questo modo, ogni versione può continuare a funzionare mentre viene distribuita quella successiva e se ne verifica il comportamento. Questo approccio non elimina ogni rischio: richiede di conoscere le dipendenze, monitorare il sistema e decidere in anticipo come reagire in caso di problemi.
Perché una piccola modifica può interrompere il servizio
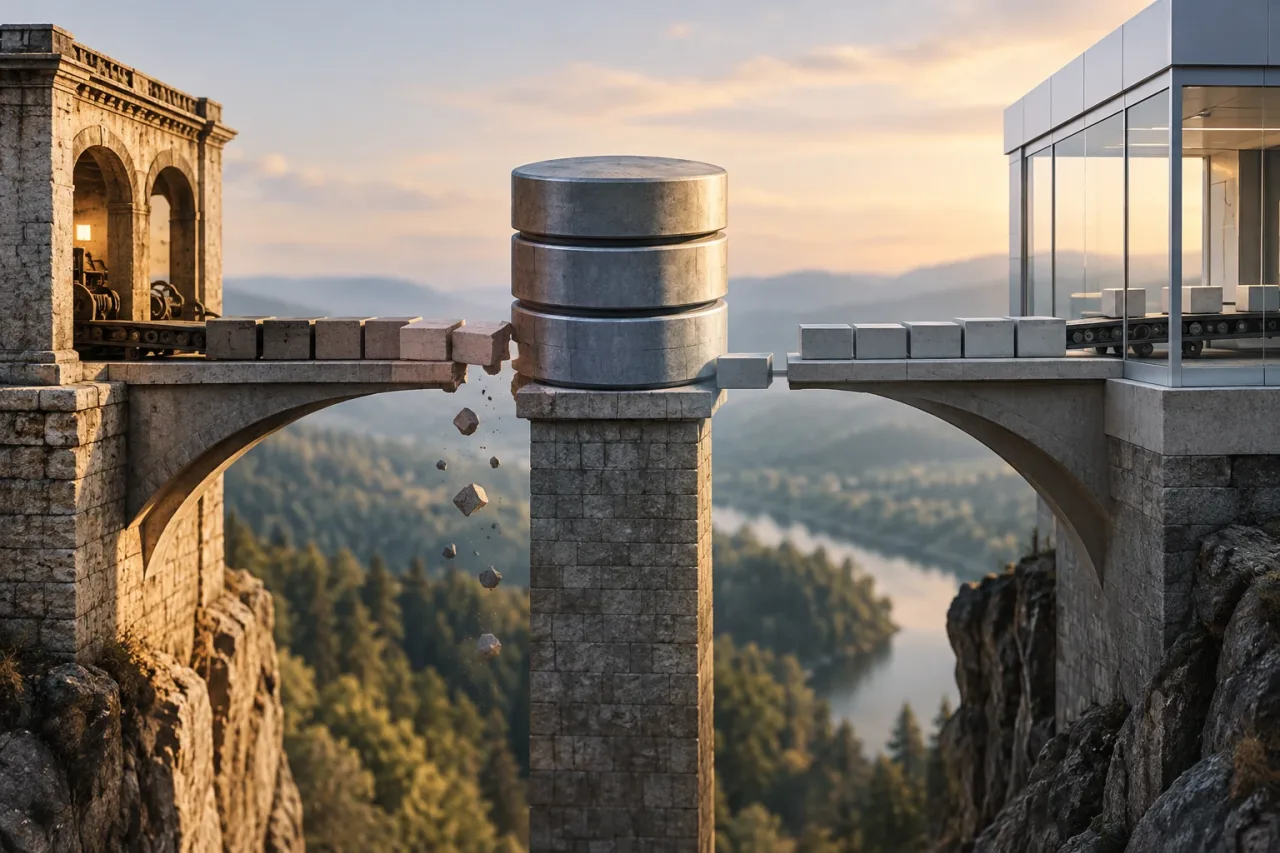
Lo schema è un contratto tra il database e tutto il software che lo interroga. Una vecchia versione dell’applicazione può aspettarsi una colonna che una migrazione elimina; una nuova versione può presupporre che una colonna sia già presente, quando invece non è ancora stata creata. Sono situazioni frequenti quando la distribuzione dell’applicazione e quella del database non avvengono esattamente nello stesso momento.
Conta anche il modo in cui viene eseguita l’operazione. A seconda del motore e della modifica, un cambiamento può bloccare le scritture, richiedere molto tempo o competere con il carico abituale per le risorse. Non dare per scontato che un’operazione sia istantanea o abbia lo stesso impatto in tutti gli ambienti. Verifica il comportamento in base al motore e alla sua versione, alle dimensioni e all’utilizzo delle tabelle e al meccanismo di migrazione specifico.
Prima di pianificare, individua chi legge e scrive i dati: versioni dell’applicazione, servizi connessi, query di analisi, processi batch, script e operazioni manuali. Esamina anche le dipendenze meno visibili, come procedure memorizzate, viste e vincoli. Se non puoi verificare quali componenti usano un campo, non rimuoverlo ancora.
Applicare il modello expand and contract
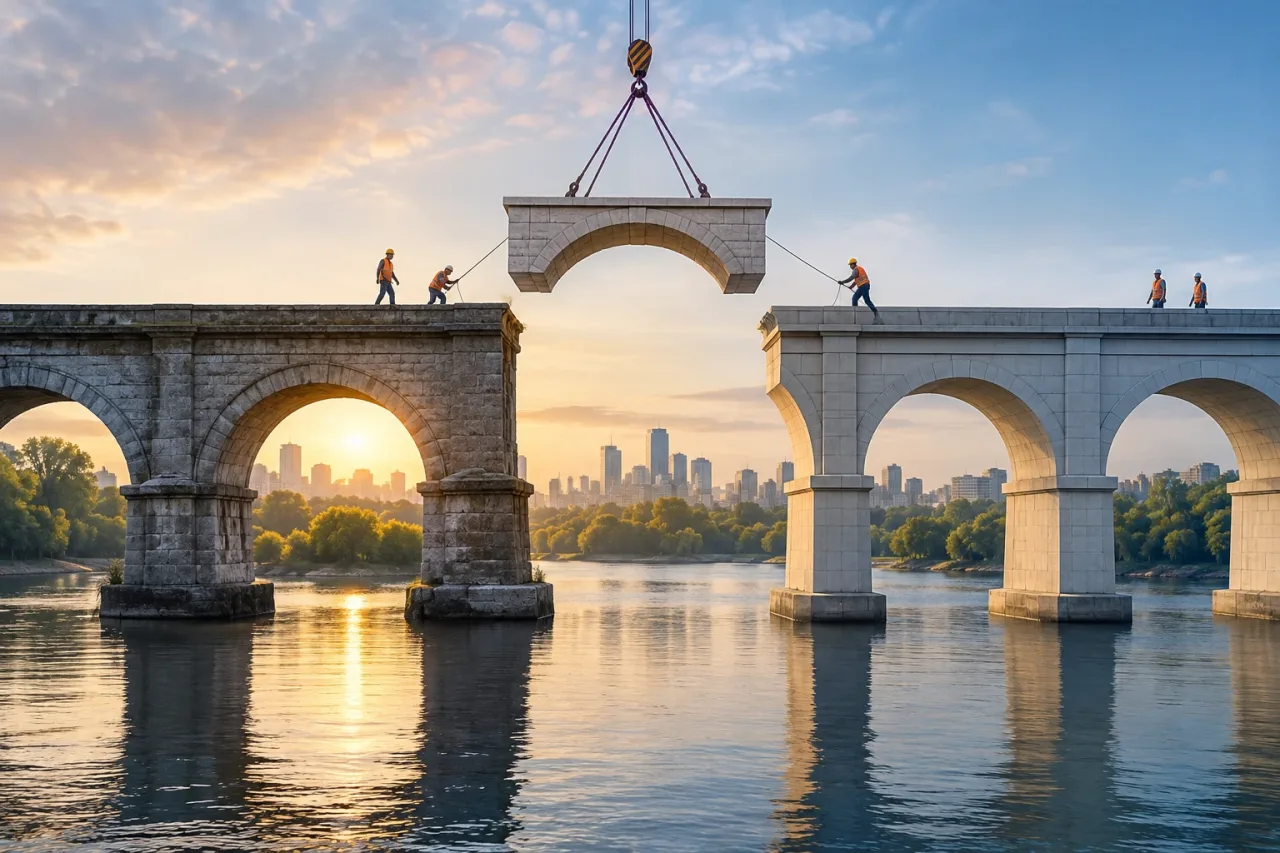
Il modello expand and contract (ampliamento e contrazione) suddivide una modifica incompatibile in più fasi. Per prima cosa si amplia lo schema in modo additivo; poi si distribuisce codice in grado di coesistere con quello precedente; infine si elimina il componente obsoleto, quando nessun utilizzatore ne ha più bisogno. La compatibilità tra le fasi è il principio centrale: durante la transizione, ogni versione attiva deve poter lavorare con lo schema disponibile.
- Ampliare: aggiungi la nuova colonna, tabella o struttura senza eliminare né modificare quella precedente. Evita di introdurre subito un vincolo che i dati esistenti o la vecchia applicazione non possono rispettare.
- Preparare l’applicazione: distribuisci una versione in grado di gestire, secondo necessità, sia il vecchio schema sia quello nuovo. Procedi gradualmente e conferma che le vecchie istanze non siano più attive prima di supporre che non vi siano più letture o scritture nel formato precedente.
- Transizione: sposta le letture o le scritture verso la nuova rappresentazione. Se occorre mantenere entrambe le colonne, stabilisci quale sia la fonte autorevole e come sincronizzarle durante l’intervallo.
- Contrarre: dopo aver verificato che il codice e i processi non usino più il componente obsoleto, rimuovilo con una modifica successiva. Questa fase deve essere indipendente dalla distribuzione che ha avviato la transizione.
Separare le fasi evita che un’applicazione distribuita gradualmente si trovi all’improvviso davanti a uno schema che non sa ancora gestire. Inoltre, rende più chiara la risposta ai problemi: spesso è possibile fermare le modifiche al codice senza annullare subito un ampliamento compatibile.
Come gestire colonne, rinominazioni e modifiche di tipo
Nuove colonne: aggiungi prima la colonna e distribuisci codice che funzioni anche se non contiene ancora il valore previsto. Inizia poi a scrivere il nuovo campo e verifica che le nuove scritture vadano a buon fine. Se occorre aggiornare i record esistenti, considera questa attività separatamente: può richiedere tempo e risorse, quindi è opportuno monitorarne l’avanzamento. Solo quando i dati sono pronti e il codice legge il nuovo campo si può valutare la rimozione del precedente.
Rinominazioni: una rinominazione diretta è spesso incompatibile con le versioni che continuano a interrogare il vecchio nome. È più sicuro aggiungere una colonna con il nuovo nome, coordinare temporaneamente le scritture e spostare gradualmente le letture. Rimuovi il vecchio nome solo dopo aver verificato che nessuna versione attiva o processo dipendente lo utilizzi.
Modifiche di tipo: non dare per scontato che una conversione conservi tutti i valori. Definisci cosa accade ai dati non compatibili, controlla alcuni campioni e pianifica una conversione che possa essere monitorata e verificata. Se il nuovo tipo richiede regole più rigorose, convalida i dati esistenti prima di applicarle.
Vincoli e valori obbligatori: rendere obbligatoria una colonna può causare errori se esistono ancora righe senza valore o se alcuni sistemi di scrittura non lo forniscono. Prepara prima i dati e il codice; applica poi il vincolo quando puoi dimostrare che è rispettato. La sequenza esatta dipende dal motore di database e dal modo in cui gestisce la convalida e i blocchi.
Verifiche prima, durante e dopo la distribuzione
Una migrazione non è riuscita solo perché l’istruzione è stata completata. Verifica che il comportamento funzionale e operativo sia ancora corretto. Prima della modifica, registra lo stato utile per effettuare confronti e stabilisci quali segnali giustificherebbero l’interruzione della distribuzione.
- Compatibilità: verifica quali versioni dell’applicazione saranno attive in ogni fase e prova che possano lavorare con lo schema corrispondente.
- Dati: controlla conteggi, valori nulli e regole di business pertinenti prima e dopo la modifica. Per una trasformazione, confronta il risultato con criteri noti, non limitarti a verificare che non ci siano errori.
- Prestazioni: osserva la durata della migrazione, i blocchi, il carico e la latenza delle operazioni interessate. Se peggiorano, ferma la fase successiva e valuta l’impatto prima di procedere.
- Errori: controlla gli errori delle query, le eccezioni dell’applicazione e i problemi nelle integrazioni o nei processi pianificati. L’assenza di avvisi non dimostra, da sola, che siano stati considerati tutti i componenti interessati.
- Utilizzo del vecchio schema: cerca riferimenti nel codice e nelle query e verifica per un periodo adeguato se il campo da rimuovere viene ancora letto o scritto.
Quando possibile, prova la procedura in un ambiente rappresentativo, includendo le verifiche. Il test può rivelare dipendenze e operazioni lente, ma non garantisce che la produzione abbia lo stesso carico o la stessa distribuzione dei dati. Assicurati inoltre che la migrazione sia identificabile e che il team sappia chi decide se proseguire, sospendere o annullare.
Rollback, correzione in avanti e limiti
Un rollback della migrazione non è sempre sicuro. Spesso è più facile lasciare invariato un ampliamento additivo che annullarlo, soprattutto se l’applicazione ha già scritto dati nella nuova colonna. Eliminare questi dati per tornare allo stato precedente può causare una perdita di informazioni. Perciò, un piano di rollback deve chiarire cosa viene annullato — il codice, lo schema o entrambi — e quali dati verranno conservati.
Se le nuove scritture non possono essere convertite in modo affidabile per lo schema precedente, può essere più prudente fermare la distribuzione e preparare una correzione in avanti. Definisci prima i criteri per decidere, per esempio errori nelle operazioni critiche, peggioramento persistente o dati incoerenti. Non promettere un rollback immediato senza aver verificato che sia fattibile per quella modifica specifica.
Lista di controllo per pianificare la modifica
- Sono stati identificati tutti i lettori, gli scrittori e i processi che usano lo schema interessato?
- La modifica iniziale è compatibile con le versioni che resteranno attive durante la distribuzione?
- L’ampliamento, la transizione del codice e la rimozione del componente obsoleto sono stati separati?
- Se vengono mantenute temporaneamente due rappresentazioni, è stata definita la fonte autorevole?
- Sono stati stabiliti controlli su dati, errori e prestazioni, con responsabili e criteri per sospendere il processo?
- Il piano spiega cosa si può annullare e in quali casi sarà necessaria una correzione in avanti?
Per capire come modificare lo schema di un database senza interrompere il servizio, ragiona in termini di compatibilità tra fasi, non di cambiamento isolato. Aggiungi prima di rimuovere, mantieni operative le versioni che coesistono e verifica ogni transizione con segnali osservabili. Quando la modifica non può essere additiva, individua esplicitamente il rischio e prepara una finestra di manutenzione o una strategia di ripristino adeguata; non dare per scontato che ogni modifica possa essere distribuita senza interruzioni.