

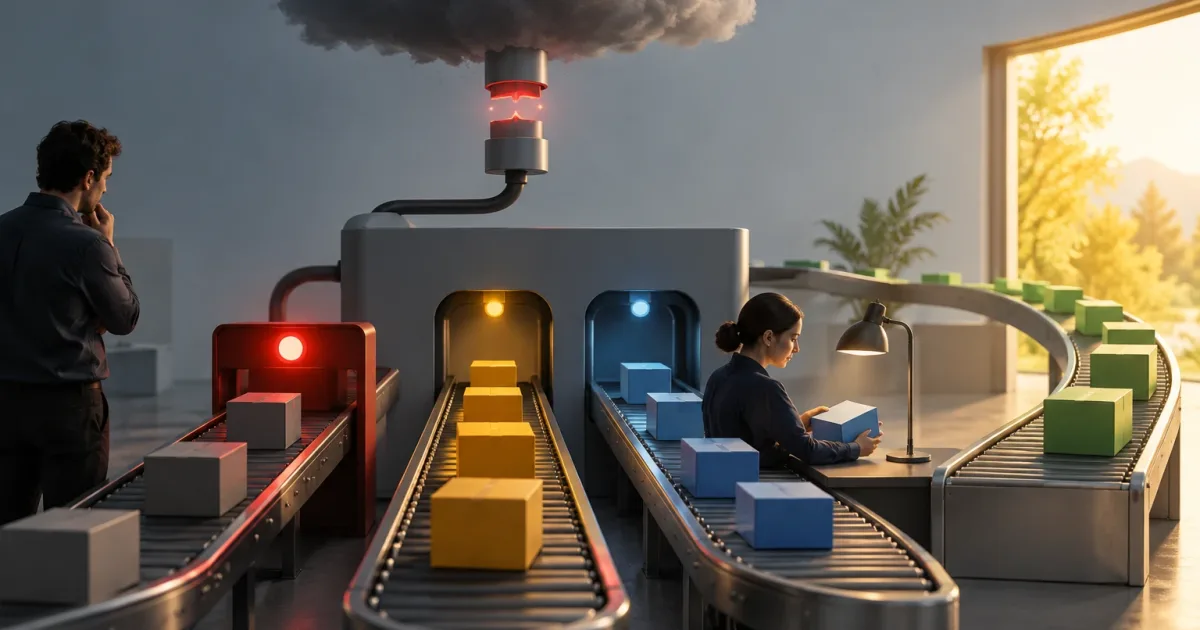
Un’automazione che dipende da un’API o da un altro servizio esterno può non funzionare anche se il processo interno opera correttamente. La domanda importante non è solo come rilevare il problema, ma che cosa deve accadere mentre la dipendenza non è disponibile. Una decisione uniforme — fermare tutto o continuare a ogni costo — spesso è inadeguata: l’impatto dipende dalla funzione interessata, dai dati necessari e dalle conseguenze di agire in ritardo o con informazioni incomplete.
Una politica di contingenza traduce questi fattori in decisioni operative. Stabilisce quando bloccare, quando proseguire con limitazioni e quando affidare il caso a una persona; inoltre, definisce come riprendere l’elaborazione delle attività in sospeso. In questo modo si riduce l’improvvisazione e si evita che un’interruzione tecnica si trasformi accidentalmente in una decisione aziendale.
Classifica l’impatto prima di scegliere una risposta
Inizia descrivendo che cosa offre la dipendenza a ciascun processo. Lo stesso fornitore può essere essenziale per un’operazione e trascurabile per un’altra. Per esempio, se un servizio arricchisce un record per agevolare un’analisi successiva, potrebbe essere accettabile salvare il record senza quel dato. Se invece verifica una condizione necessaria per autorizzare un’operazione, proseguire senza una risposta può essere rischioso o violare una regola interna.
Per ogni utilizzo, valuta che cosa accade se l’attività viene fermata, ritardata o completata con dati incompleti. Considera sia il danno potenziale sia la possibilità di correggerlo in seguito. Una classificazione utile distingue tra:
- Bloccante: proseguire senza la risposta esterna può causare un’azione non autorizzata, una perdita difficile da recuperare o un risultato errato ad alto impatto.
- Rinviabile: l’attività può aspettare senza provocare danni rilevanti, purché sia possibile identificarla e gestirla entro tempi operativi accettabili.
- Degradabile: è possibile offrire una parte del valore senza il servizio, con limiti chiari e senza presentare come completo un risultato che non lo è.
- Da sottoporre a revisione: il sistema non dispone di informazioni sufficienti per decidere in sicurezza, quindi deve conservare il caso e richiedere l’intervento umano.
Non classificare solo in base al componente. Registra il processo, il tipo di operazione, il dato interessato e le conseguenze di ciascuna alternativa. Se il risultato ha implicazioni contrattuali, economiche, di privacy o di sicurezza, coinvolgi nella decisione i team responsabili.
Scegli se bloccare, proseguire con funzionalità limitate o affidare il caso a una persona
Bloccare è la scelta appropriata quando la risposta esterna è una condizione necessaria e non esiste un’alternativa autorizzata. Il blocco deve essere esplicito: informa che l’operazione non è stata completata, conserva il contesto necessario per riprenderla ed evita stati ambigui che sembrino indicare un esito positivo. Definisci che cosa può fare l’utente nel frattempo, per esempio salvare una bozza o riprovare più tardi.
Proseguire in modalità degradata è opportuno quando si può rinunciare a una funzione secondaria senza compromettere il risultato essenziale. Limita le operazioni consentite dal sistema, indica quali dati mancano e comunica il limite all’utente o al team che riceverà il risultato. Non trasformare una mancata risposta in un valore predefinito che sembri valido, se questo può indurre in errore. È inoltre utile distinguere un dato sconosciuto da un dato confermato come negativo.
Affidare il caso a una persona è un’opzione quando serve una valutazione, ma l’attività può comunque essere risolta. L’assegnazione richiede una coda visibile, informazioni sufficienti per decidere e un’indicazione chiara di ciò che la persona deve verificare. Senza questi elementi, la “modalità manuale” si limita a spostare il problema in una casella di posta disordinata. Definisci anche chi è responsabile della gestione dei casi e che cosa accade se non vengono esaminati in tempo.
La risposta può variare a seconda dell’operazione. Non è necessario assegnare un’unica modalità all’intera integrazione: una consultazione informativa potrebbe proseguire con funzionalità limitate, mentre un’azione che modifica un record sensibile viene bloccata. Documenta le eccezioni ed evita che il comportamento dipenda da presupposti impliciti nel codice.
Stabilisci limiti sicuri per l’alternativa manuale
Una procedura manuale deve essere un’eccezione controllata, non un canale parallelo senza supervisione. Prima di abilitarla, definisci quali ruoli possono intervenire, quali azioni sono consentite e per quanto tempo. Le autorizzazioni devono essere proporzionate al rischio: non tutte le persone che esaminano un caso devono poterlo approvare o modificare.
Stabilisci anche quali evidenze registrare. Come minimo, conserva l’operazione interessata, le informazioni disponibili in quel momento, la decisione presa, chi l’ha presa e quando. Se una persona inserisce un dato provvisorio, indicane chiaramente l’origine e specifica se richiede una conferma successiva. Tieni separati i fatti ricevuti dal servizio e le decisioni umane: questa distinzione agevola la revisione e la correzione.
L’alternativa deve avere un limite temporale o una condizione di chiusura. Per esempio, potrebbe non essere più accettata quando la coda raggiunge la capacità definita dal team operativo, quando scade un’autorizzazione o quando la dipendenza torna disponibile. Non stabilire una soglia universale: sceglila in base ai volumi, al costo della revisione e al rischio di accumulare attività irrisolte. Se la capacità è insufficiente, bloccare nuove operazioni può essere più sicuro che creare un arretrato operativo invisibile.
Definisci quando riprendere e come riconciliare le attività in sospeso
Il fatto che un’API torni a rispondere non dimostra, da solo, che sia sicuro elaborare tutto ciò che si è accumulato. Definisci segnali di ripristino adeguati alla dipendenza e al processo: disponibilità mantenuta per un periodo stabilito dal team, risposte valide per le operazioni necessarie e assenza di discrepanze che impongano di sospendere la ripresa. Il criterio deve poter essere verificato e non basarsi su un’impressione.
Prima di riprendere, decidi che cosa fare per ogni stato in sospeso. Alcuni casi possono essere rielaborati automaticamente; per altri occorre verificare se l’operazione è stata completata solo in parte o se qualcuno l’ha risolta manualmente. Evita di duplicare le azioni: identifica le operazioni in modo che il sistema possa riconoscere quelle già eseguite e quelle ancora aperte. Se non puoi confermare lo stato finale, invia il caso alla revisione invece di presumere che ripetere l’operazione sia innocuo.
La riconciliazione deve confrontare ciò che era previsto con quanto è accaduto: attività ricevute, decisioni manuali, operazioni completate ed errori ancora aperti. Definisci chi convalida la chiusura e come correggere i dati discordanti. In questo modo, il ripristino non termina quando il fornitore torna disponibile, ma quando il processo interno ritorna a uno stato coerente.
Verifica gli scenari e rivedi la politica
Prova l’indisponibilità in un ambiente controllato e percorri il processo dal punto di vista dell’utente e del team operativo. Includi risposte tardive, dati incompleti, ripristino intermittente e un’interruzione durante un’azione in corso. L’obiettivo non è verificare un elenco generico di guasti, ma accertarsi che ogni decisione documentata venga applicata e che i responsabili sappiano che cosa devono fare.
Osserva i segnali che possono rivelare un problema di progettazione: casi indicati come completati senza una risposta valida, code manuali che crescono senza un responsabile, utenti che ripetono un’operazione perché non ne conoscono lo stato o attività in sospeso che non vengono riconciliate dopo il ripristino. Esamina anche gli effetti sui tempi di gestione, sulla qualità dei dati e sul lavoro aggiuntivo. Se un’alternativa comporta più rischi o costi rispetto all’attesa, modifica la politica.
Aggiorna la decisione quando cambiano il processo, il fornitore, le autorizzazioni o l’impatto di un’operazione. Una misura di contingenza valida per una funzione informativa può non esserlo più se quella funzione inizia a innescare un’azione con conseguenze maggiori. La revisione dovrebbe coinvolgere prodotto, tecnologia e operations, oltre agli altri team interessati quando il rischio lo richiede.
Lista di controllo per ogni dipendenza
- Quali processi e decisioni dipendono da questo servizio esterno?
- Quali sono le conseguenze di fermare, ritardare o completare ogni operazione senza tutti i dati?
- Quali condizioni determinano il blocco, la prosecuzione con funzionalità limitate o l’assegnazione a una persona?
- Quali autorizzazioni, limiti di durata e registrazioni richiede il canale manuale?
- Chi gestisce i casi in sospeso e quando si deve intervenire se il carico aumenta?
- Quali segnali verificabili autorizzano la ripresa dell’elaborazione?
- Come vengono identificati duplicati, stati parziali e decisioni manuali?
- Quali test e revisioni mantengono aggiornata la politica?
Rispondere a queste domande consente di trasformare una dipendenza esterna in una decisione esplicita di prodotto e di gestione operativa. La politica giusta non elimina i guasti: ne limita gli effetti, mantiene visibili le eccezioni e offre un percorso verificabile per tornare alla normalità.