

Un test può mostrare un aumento delle conversioni e, allo stesso tempo, un incremento degli errori, delle richieste di assistenza o del tempo necessario per completare un’attività. Il dato principale sembra favorevole, ma il costo per gli utenti o per l’operatività pone una domanda legittima: si lancia, si modifica o ci si ferma?
La decisione non consiste nello scegliere la metrica che sostiene meglio una preferenza già maturata. Consiste nel confrontare il risultato con un’ipotesi, valutare la qualità delle evidenze e stabilire quali rischi siano accettabili. Questo quadro aiuta a decidere come valutare l’esito di un esperimento di prodotto senza ridurlo a un solo numero né trasformare ogni discrepanza in un motivo per prolungare un test all’infinito.
Perché una metrica principale favorevole non basta
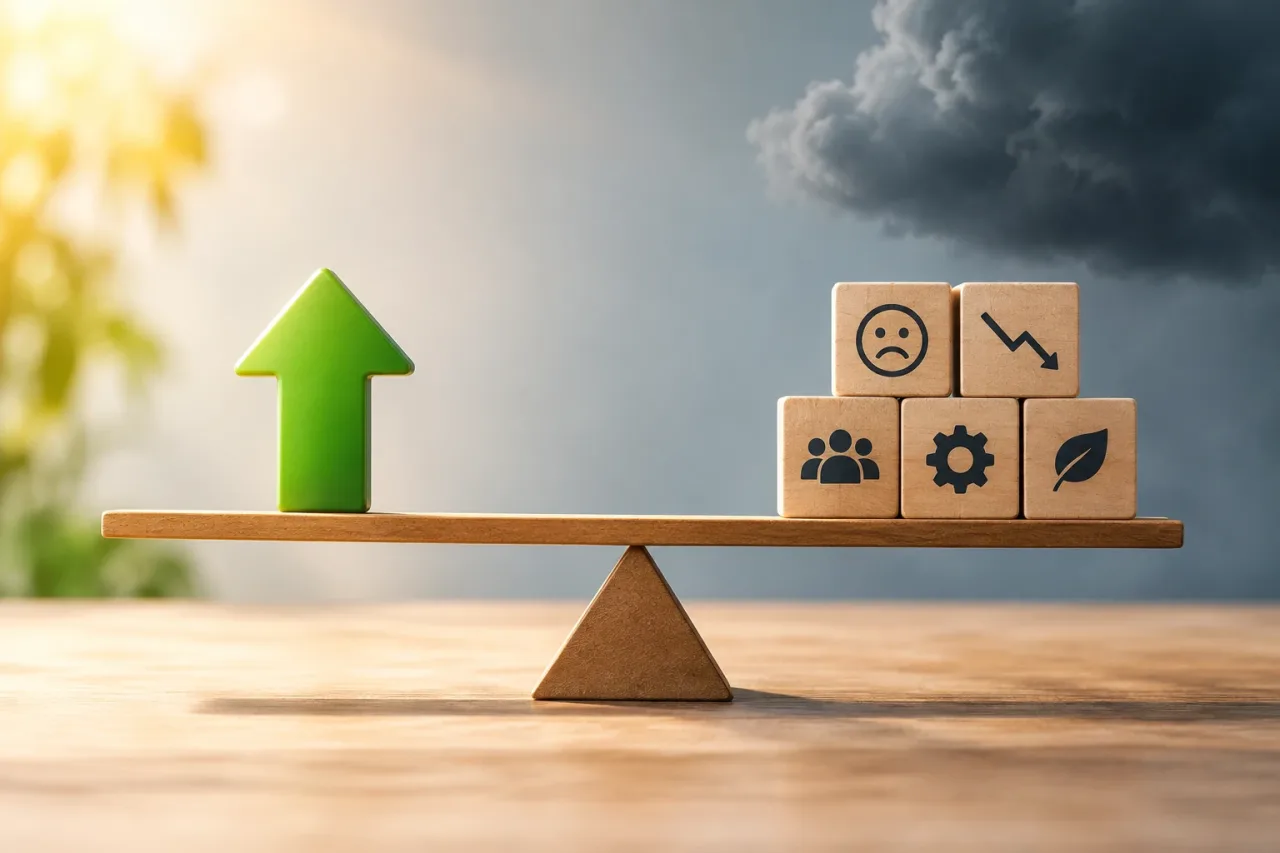
La metrica principale rappresenta il risultato che l’intervento mira a modificare: per esempio, completare un acquisto, attivare un account o prenotare un appuntamento. È importante perché rende esplicito l’obiettivo. Tuttavia, un aumento di quel risultato non dimostra, da solo, che il cambiamento sia complessivamente conveniente.
Un miglioramento apparente potrebbe accompagnarsi a più cancellazioni, errori di pagamento, contatti con il servizio clienti o abbandoni di un’attività successiva. Potrebbe anche spostare l’attività da una fase all’altra senza migliorare il risultato finale. Una nuova schermata, per esempio, potrebbe aumentare i clic su «Continua», ma non necessariamente gli acquisti completati.
Per questo è utile distinguere tre domande:
- Il risultato atteso è cambiato? La metrica principale risponde all’ipotesi immediata.
- Il cambiamento ha prodotto danni rilevanti? Le metriche di salvaguardia rivelano costi o peggioramenti importanti.
- Le evidenze consentono di attribuire il cambiamento all’intervento? La qualità della strumentazione, l’assegnazione e il periodo osservato condizionano l’interpretazione.
Un esito favorevole alla prima domanda non risolve automaticamente le altre due. Un cambiamento merita di proseguire solo se il beneficio è sufficientemente credibile e i costi restano entro limiti accettabili.
Prima del test: definire ipotesi e criteri decisionali
Prima di avviare il test, scrivi che cosa cambia, per chi e perché ti aspetti che produca un risultato. L’ipotesi deve descrivere una relazione verificabile, non una soluzione già considerata corretta. Per esempio: «Semplificare questo passaggio ridurrà l’abbandono tra i nuovi utenti perché elimina una richiesta di informazioni di cui non hanno bisogno in quel momento».
Definisci anche la popolazione idonea, il risultato principale e il periodo o il volume necessari per valutare il test. La durata non dovrebbe dipendere soltanto dalla comparsa di dati eclatanti nei primi giorni. Considera i cicli d’uso pertinenti, la stagionalità nota e il tempo necessario perché emergano effetti successivi, come resi o richieste di assistenza.
Prima di esaminare i risultati, concorda quali decisioni sono possibili e quali segnali le farebbero scattare. Non è necessario fingere che tutto possa essere riassunto in un’unica soglia statistica. È però importante distinguere tra:
- Condizioni per procedere: un beneficio sufficientemente convincente, senza peggioramenti inaccettabili nelle metriche di salvaguardia.
- Condizioni per fermarsi: un danno evidente, un problema operativo o un rischio non giustificato dal miglioramento.
- Condizioni per indagare o iterare: un risultato incerto, un problema correggibile o dati che non consentono una conclusione affidabile.
Stabilisci i limiti in base al contesto. Un lieve calo in una metrica secondaria può essere tollerabile se l’impatto è reversibile e il beneficio è rilevante; un aumento degli errori che impedisce di completare un’attività essenziale può richiedere di fermarsi, anche se le conversioni aumentano. I limiti devono riflettere le conseguenze per gli utenti e per l’attività, non soltanto la convenienza statistica.
Quali metriche di salvaguardia osservare e come impostare gli avvisi
Le metriche di salvaguardia, dette anche metriche di controllo, monitorano gli effetti che l’intervento non dovrebbe peggiorare in modo sostanziale. La selezione dipende dal cambiamento. Una modifica alla registrazione può richiedere il monitoraggio degli errori, dell’attivazione successiva e dei contatti con l’assistenza. Un cambiamento nel processo di acquisto può richiedere il controllo dei pagamenti non riusciti, delle cancellazioni, dei resi e dei tempi di assistenza.
Scegli poche metriche che rappresentino rischi concreti e siano misurabili in modo affidabile. Aggiungere decine di indicatori rende più difficile distinguere un segnale importante da una fluttuazione casuale. Per ciascuna metrica, documenta:
- quale danno o costo intende rilevare e a quale popolazione si applica;
- il livello abituale e il metodo di calcolo, compresi denominatore e finestra temporale;
- quale peggioramento sarebbe preoccupante e quale azione comporterebbe;
- se il dato arriva in ritardo o può risentire di errori di strumentazione.
Una soglia di allerta non equivale necessariamente a una prova statistica definitiva. Può essere una regola operativa per mettere in pausa e verificare, soprattutto quando il possibile danno è grave. Se scatta un avviso, controlla innanzitutto che la misurazione funzioni e che il confronto sia valido; non ignorare il rischio nell’attesa di una conclusione perfetta.
Interpretare segnali contraddittori senza scegliere il dato più conveniente
Quando le metriche sono discordanti, non farne una media e non scegliere a posteriori quella che favorisce l’opzione preferita. Esamina la catena causale prevista: il cambiamento ha modificato il passaggio atteso? L’effetto si mantiene sul risultato successivo? La metrica secondaria rappresenta un costo diretto, una conseguenza temporanea o un indicatore che non riflette un danno reale?
Verifica anche la qualità dei dati. Controlla che l’assegnazione alle varianti abbia funzionato, che gli eventi siano stati registrati in modo coerente e che le due popolazioni siano confrontabili. Accertati che non ci siano stati cambiamenti simultanei, interruzioni o campagne in grado di modificare il comportamento. Se la misurazione non funziona, il risultato non è «positivo» né «negativo»: resta inconcludente finché il problema non viene risolto.
Distingui l’entità dalla certezza. Un cambiamento piccolo ma costante può avere valore se riguarda molte interazioni; un cambiamento ampio basato su pochi dati può essere fragile. Non confondere l’assenza di prove di un danno con la prova che il danno non esista, soprattutto quando si tratta di conseguenze tardive o poco frequenti.
Se il risultato principale migliora e una metrica di salvaguardia peggiora, chiediti se il deterioramento supera il limite stabilito, se è significativo per le persone interessate e se esiste una spiegazione verificabile. Se il costo è accettabile e resta entro il limite, può essere ragionevole procedere monitorando la situazione. Se supera una soglia importante, il miglioramento principale non lo compensa automaticamente.
Lanciare, iterare, prolungare o fermarsi
Lanciare è ragionevole quando le evidenze sostengono l’obiettivo, non emergono segnali di danno oltre i limiti concordati e l’organizzazione è in grado di sostenere il cambiamento. Il lancio può essere graduale, con monitoraggio e possibilità di ripristino: non deve necessariamente estendersi subito a tutta la popolazione.
Iterare quando l’ipotesi resta plausibile, ma i risultati indicano un problema concreto e correggibile. Per esempio, il flusso semplificato può funzionare, mentre un’istruzione ambigua genera richieste di assistenza. Formula un’ipotesi aggiornata e, quando possibile, testa la nuova modifica separatamente, così da capire che cosa ha prodotto il risultato.
Prolungare soltanto se mancano informazioni rilevanti che un test valido può fornire. Prima, specifica quale incertezza verrà risolta, quale dato aggiuntivo cambierebbe la decisione e quando si tornerà a valutarla. Se nessun risultato possibile modificherebbe la scelta, prolungare aggiunge soltanto costi e occasioni di selezione distorta.
Fermarsi se emerge un danno che supera il limite, se il cambiamento compromette un’attività essenziale o se l’ipotesi perde plausibilità senza che vi sia una possibilità ragionevole di correzione. Fermare una variante non annulla ciò che si è imparato: può mettere in luce un vincolo di progettazione o un’esigenza operativa da affrontare in un altro modo.
Segmenti diversi e decisioni reversibili
Un risultato medio può nascondere differenze tra gruppi. Tuttavia, non trasformare ogni differenza osservata in una regola di segmentazione: esaminare molti gruppi rende più probabile trovare variazioni casuali. Dai maggiore peso ai segmenti definiti prima del test, motivati chiaramente e sostenuti da informazioni sufficienti per essere interpretati.
Prima di intervenire, verifica che la differenza sia coerente, rilevante e spiegabile. Se i nuovi utenti sembrano trarne beneficio e quelli abituali peggiorano, una possibilità può essere progettare esperienze diverse a seconda del contesto, ma solo se è possibile implementarle, misurarle e mantenerle senza creare confusione o costi sproporzionati. Quando le evidenze sono deboli, registra il segnale come ipotesi per un test successivo, non come conclusione.
Infine, documenta la decisione: ipotesi, popolazione, periodo, metriche, avvisi, risultato, incertezze e responsabile del monitoraggio. Specifica quale nuovo segnale giustificherebbe una revisione e come ripristinare la situazione precedente. Una decisione reversibile e documentata non elimina il rischio, ma consente di agire con criterio, imparare dagli effetti reali e correggere la rotta senza scambiare una metrica favorevole per un’approvazione automatica.