

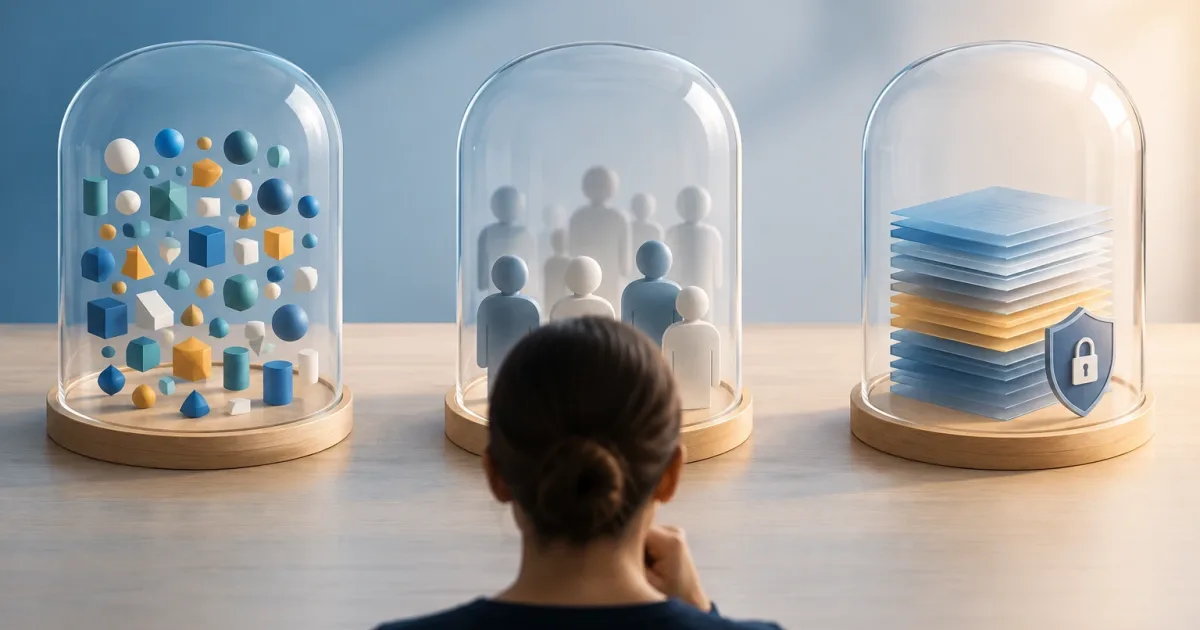
I dati di test influiscono sia sulla qualità del software sia sull’esposizione di informazioni sensibili. Un insieme troppo semplice può nascondere errori; una copia della produzione priva di controlli può divulgare dati personali o commerciali. La scelta non consiste soltanto nel decidere tra dati reali e fittizi: occorre trovare un equilibrio tra realismo, sensibilità, impegno di manutenzione e finalità di ciascun ambiente.
Questa guida confronta tre approcci — dati sintetici, dati anonimizzati e copie controllate — e propone criteri pratici per sviluppo, test e dimostrazioni. L’opzione più adatta può variare da un team all’altro e persino tra i diversi test dello stesso prodotto.
Perché i dati condizionano qualità e rischio
Un’applicazione si comporta in base ai dati che elabora. Volumi, combinazioni, valori mancanti, duplicati e relazioni tra record possono attivare percorsi che gli esempi minimi non raggiungono. Se i test coprono soltanto il caso ideale, possono sfuggire problemi di convalida, calcolo, autorizzazioni, integrazione o migrazione.
Allo stesso tempo, gli ambienti non produttivi spesso hanno più utenti con accesso, strumenti di debug e cicli di vita meno rigorosi rispetto alla produzione. Includere informazioni identificabili per comodità aumenta le conseguenze di un account compromesso, di un’esportazione accidentale o di un ambiente dimenticato. L’obiettivo è conservare le caratteristiche necessarie per i test, non copiare più informazioni del necessario.
Prima di scegliere un metodo, definisci cosa vuoi convalidare: una regola di business, una migrazione, le prestazioni, l’esperienza utente o una dimostrazione. Senza uno scopo preciso, “dati realistici” è un requisito vago e può spingere a raccogliere dettagli che non apportano valore.
Tre approcci, con diversi livelli di fedeltà
Dati sintetici
Si generano da zero mediante regole, modelli o strumenti interni. Possono includere nomi fittizi, date, stati e relazioni coerenti, oltre a casi limite creati intenzionalmente. Poiché non derivano da record reali, evitano di trasferire direttamente i dati di produzione. Tuttavia, non sono automaticamente sicuri se contengono valori reali, segreti o esempi copiati.
Sono adatti allo sviluppo, ai test automatizzati, alla formazione e alle dimostrazioni quando è possibile descrivere la struttura e il comportamento attesi. Il principale costo consiste nel creare e mantenere generatori che rappresentino regole di business, distribuzioni e combinazioni rilevanti. Un insieme sintetico troppo regolare non farà emergere problemi dovuti a dati storici irregolari.
Dati anonimizzati
Si ottengono trasformando dati di origine affinché le persone non possano essere identificate. Il risultato può conservare schemi utili per determinati test, ma il rischio dipende dal contesto, dai campi mantenuti e dalla possibilità di combinare le informazioni con altre fonti. Sostituire nomi o indirizzi e-mail non è necessariamente sufficiente: anche date, luoghi, identificatori indiretti e relazioni poco frequenti possono rivelare l’identità.
Questo approccio richiede di esaminare il risultato, non soltanto di applicare una trasformazione. Se il test richiede solo tendenze aggregate, può essere opportuno ridurre il livello di dettaglio. Se invece servono relazioni tra record, la trasformazione deve preservare la coerenza senza mantenere identificatori non necessari. L’anonimizzazione non va considerata una garanzia automatica che qualsiasi uso successivo sia innocuo.
Copie controllate della produzione
Una copia controllata conserva una parte selezionata dei dati reali oppure una versione trasformata e limitata. Può essere utile per indagare problemi difficili da riprodurre, convalidare migrazioni complesse o valutare il comportamento con distribuzioni autentiche. Comporta anche rischi specifici: può trasferire informazioni sensibili, includere segreti operativi e diventare rapidamente obsoleta.
Riservala ai casi in cui le alternative non garantiscono il realismo necessario. Definisci quali campi vengono estratti, chi autorizza la preparazione, dove si conserva la copia, chi vi accede e quando viene eliminata. Una copia non dovrebbe diventare la scelta predefinita solo perché è la più comoda.
Come scegliere in base al test e al rischio
Usa questi criteri per prendere una decisione esplicita:
- Sviluppo e test unitari: privilegia dati sintetici, ridotti, prevedibili e facili da ripristinare. Devono coprire valori validi, non validi e limiti delle regole.
- Test di integrazione: combina dati sintetici coerenti con i contratti dei sistemi collegati. Se una dipendenza richiede realismo storico, valuta un estratto trasformato e limitato.
- Test di carico o prestazioni: riproduci il volume, la distribuzione e le relazioni necessari. Non dare per scontato che servano identità reali: verifica se la generazione sintetica può ottenere lo stesso profilo operativo.
- Indagine sugli incidenti: inizia riproducendo il problema con dati sintetici. Se non basta, usa una copia controllata con ambito, accessi e scadenza definiti.
- Dimostrazioni: in genere sono preferibili dati sintetici selezionati con cura. Evita che una demo pubblica o condivisa includa record, commenti o allegati reali.
Conta anche la sensibilità dei dati. Quanto più delicate sono le informazioni e ampio è l’accesso, tanto più è opportuno preferire dati sintetici o una trasformazione che elimini i dettagli superflui. La decisione dovrebbe documentare perché il realismo aggiuntivo giustifica l’impegno e il rischio.
Rappresentatività, casi limite e reidentificazione
Essere rappresentativi non significa riprodurre ogni record. Significa conservare le proprietà che incidono sul test. Individua dimensioni come la frequenza degli stati, la distribuzione delle dimensioni, le relazioni tra entità, l’anzianità e i valori mancanti. Confronta poi l’insieme di test con queste dimensioni, senza includere campi inutilizzati.
Includi casi poco frequenti che potrebbero mettere in crisi le ipotesi: record duplicati, sequenze incomplete, formati inattesi, fusi orari o transizioni di stato insolite. I dati sintetici consentono di creare intenzionalmente questi casi, che potrebbero non comparire in un campione di produzione.
Per valutare il rischio di reidentificazione, chiediti che cosa si potrebbe dedurre combinando i campi conservati con informazioni disponibili altrove. Esamina identificatori diretti e indiretti, valori rari e collegamenti tra tabelle. Se non puoi giustificare la necessità di un attributo, eliminalo o rendilo più generico, quindi verifica che il test resti utile.
Controlli per il ciclo di vita dell’insieme di dati
La protezione non termina con la generazione dell’insieme. Definisci controlli semplici e verificabili per la preparazione e l’utilizzo:
- Inventaria: identifica gli insiemi, lo scopo, la provenienza, i campi e gli ambienti in cui saranno usati.
- Limita: estrai soltanto i record e gli attributi necessari; tieni separati i dati di test da credenziali, token e segreti operativi.
- Limita gli accessi: assegna autorizzazioni in base alle esigenze di lavoro e verifica chi può scaricare, copiare o esportare i dati.
- Gestisci gli aggiornamenti: documenta come viene generata ogni versione, chi la mantiene e quali modifiche allo schema o alle regole richiedono di rigenerarla.
- Definisci una scadenza: stabilisci quando eliminare l’insieme e le sue copie di lavoro, comprese le esportazioni note.
- Verifica il risultato: controlla che non contenga dati reali o campi sensibili inattesi e che i test coprano ancora gli scenari previsti.
Un insieme di test riutilizzabile dovrebbe avere un responsabile e uno scopo, come qualsiasi altro asset del team. Se nessuno sa da dove proviene o quando deve essere ritirato, è opportuno trattarlo come un debito operativo e deciderne la gestione prima di continuare a propagarlo.
Errori frequenti e lista di controllo
Due estremi tendono a fallire. Il primo consiste nell’usare dati reali per comodità: riduce il lavoro iniziale di preparazione, ma moltiplica le copie e rende più difficile controllare gli accessi e l’eliminazione. Il secondo consiste nell’usare dati artificiali troppo puliti: riduce l’esposizione, ma genera una falsa sicurezza se non riflette formati, relazioni e casi limite rilevanti. La soluzione non è scegliere in assoluto tra fedeltà e sicurezza, bensì adeguare l’insieme alla domanda a cui si vuole rispondere.
Prima di approvare i dati per un ambiente non produttivo, verifica quanto segue:
- L’obiettivo del test è definito? Sono chiare le caratteristiche dei dati necessarie?
- È possibile usare dati sintetici? Se no, quale aspetto del realismo manca?
- Campi, record e relazioni sono stati ridotti allo stretto necessario?
- Sono stati esaminati i valori rari e le combinazioni che potrebbero facilitare la reidentificazione?
- Sono definiti accessi, ubicazione, aggiornamento, responsabile e data di eliminazione?
- L’insieme copre i casi limite e può essere rigenerato quando cambiano il prodotto o lo schema?
La decisione più solida collega ogni tipo di dato a una necessità di test e a un controllo concreto. Inizia con dati sintetici e passa a una trasformazione o a una copia controllata solo quando esiste una lacuna dimostrabile di fedeltà. Riesamina la scelta quando cambiano lo scopo, i dati o gli accessi.