

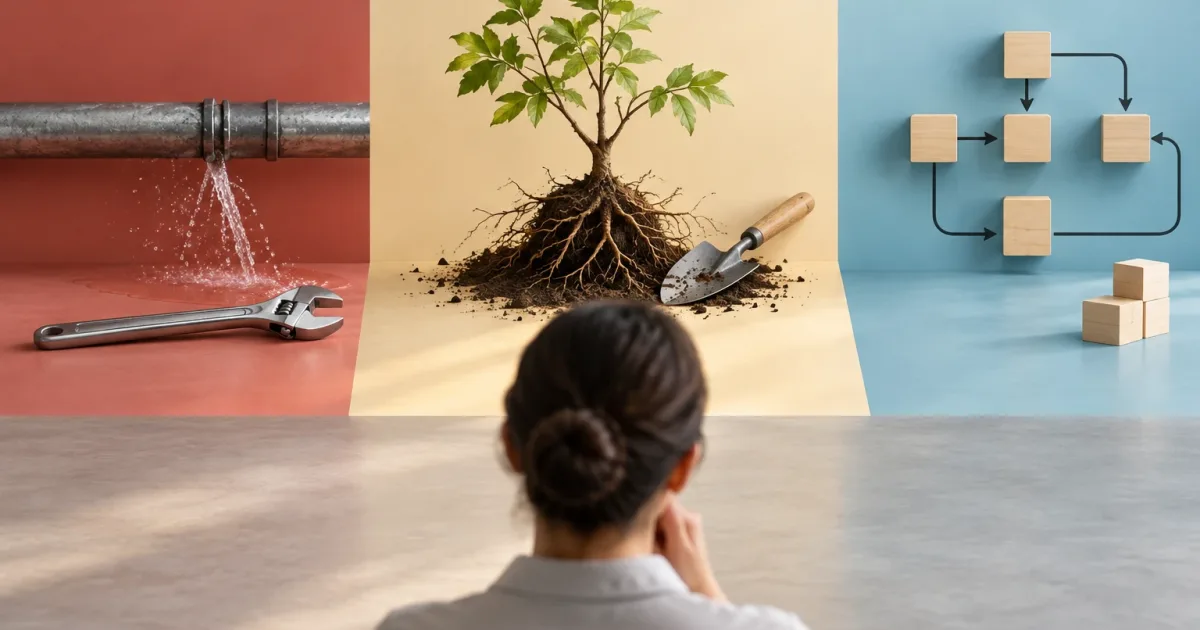
Quando un incidente si ripresenta, la risposta più rapida non è sempre quella più adatta. Correggere il singolo caso può ripristinare il servizio, ma lasciare intatta la causa che lo ha provocato. All’estremo opposto, riprogettare un intero processo per evitare un problema isolato consuma risorse e può generare nuovi rischi. La decisione più utile dipende dalla capacità di distinguere il sintomo, misurare la portata e scegliere un intervento proporzionato.
Questo quadro aiuta i responsabili di prodotto, tecnologia e operations a scegliere tra tre risposte: risolvere il singolo caso, eliminare una causa tecnica o modificare il modo di lavorare. Non è necessario aspettare di avere tutti i dati: è però opportuno registrare ciò che si sa, esplicitare le incertezze e stabilire come verificare il risultato.
Distinguere il sintomo dalla causa
Un incidente è l’evento visibile: un’operazione rimane incompleta, un dato non coincide oppure un’attività richiede un intervento manuale. La causa è il meccanismo che rende possibile quel risultato. Può risiedere in un difetto software, un’integrazione, una regola ambigua, un’eccezione gestita male o una combinazione di fattori.
Prima di scegliere una soluzione, descrivi il problema in termini osservabili:
- Che cosa è successo: qual è stato il risultato errato o il blocco.
- Dove e quando: quale passaggio, sistema o condizione era presente.
- Chi o che cosa è coinvolto: persone, operazioni, dati o servizi interessati.
- Quali prove sono disponibili: registri, messaggi, input o sequenze riproducibili.
- Che cosa non è ancora noto: ipotesi da verificare.
Evita di trasformare la prima spiegazione plausibile in una diagnosi. Per esempio, il fatto che una persona abbia inserito un dato errato non dimostra che la causa sia un errore individuale: potrebbero esserci un’etichetta poco chiara, una convalida mancante o istruzioni contraddittorie. Una buona indagine si chiede quali condizioni abbiano permesso quel risultato, non soltanto chi abbia eseguito l’ultimo passaggio.
Classificare prima di investire risorse
Valuta ogni incidente secondo quattro criteri. All’inizio non serve creare un sistema di punteggio sofisticato: è sufficiente documentare i criteri e confrontare i casi in modo coerente.
- Frequenza: è un caso isolato, si ripete in una condizione specifica o si presenta in diverse parti dell’operatività?
- Impatto: quali conseguenze ha su clienti, ricavi, conformità, qualità dei dati, carico di lavoro o continuità del servizio?
- Portata: interessa una persona o una transazione, un segmento, più team o l’intero flusso?
- Reversibilità: è possibile annullare la correzione in sicurezza se si rivela sbagliata? Ci sono effetti duraturi sui dati o sulle decisioni successive?
Considera anche quanto è affidabile la diagnosi. Un incidente di grande impatto, ma dalla causa incerta, può richiedere prima un contenimento e la raccolta di prove. Al contrario, un guasto riproducibile e circoscritto consente di valutare subito una correzione permanente. Separa l’urgenza dalla soluzione definitiva: contenere immediatamente un rischio non significa dichiarare risolto il problema alla radice.
Quando è sufficiente una correzione puntuale
Una correzione puntuale è in genere ragionevole se il caso è eccezionale, l’impatto è limitato, la causa sembra contingente e il risultato può essere riparato in sicurezza. Può consistere nel completare un’operazione, ripristinare un valore o applicare un’eccezione autorizzata. La condizione è che l’intervento non nasconda uno schema ricorrente né crei un debito operativo invisibile.
Registra ogni caso con una categoria condivisa, la data, il contesto, l’impatto, l’azione intrapresa e un riferimento alle prove disponibili. Annota anche se la causa è confermata o resta un’ipotesi. Se ogni team descrive lo stesso problema con parole diverse, sarà più difficile riconoscerne le ricorrenze; una tassonomia breve e condivisa aiuta a raggrupparle.
Quando intervieni, verifica le dipendenze: se altri processi utilizzano il dato o il risultato interessato, una riparazione locale può lasciare stati incoerenti. Mantieni un percorso di revisione e specifica chi può autorizzare le eccezioni. Se il caso si ripete, la correzione puntuale non è più una strategia sufficiente, anche se continua a essere necessaria per gestire ogni occorrenza.
Quando è necessario eliminare la causa principale
Cerca una soluzione permanente quando gli incidenti condividono lo stesso meccanismo, si riproducono in condizioni note, generano ripetutamente lavoro manuale o espongono a un rischio inaccettabile. Nel software, la risposta può consistere nel correggere una convalida, gestire correttamente una risposta imprevista o rafforzare un’integrazione. Nelle operations, può significare chiarire una regola o impedire una transizione che consenta la presenza di dati incompleti.
Un intervento permanente deve corrispondere a una causa verificata, non soltanto al sintomo più frequente. Prima di implementarlo, definisci:
- L’ipotesi causale e le prove che la sostengono.
- La modifica minima in grado di impedire o rilevare il guasto.
- I flussi, i dati e gli utenti potenzialmente interessati.
- Un test del caso originale e di scenari simili che non dovrebbero essere compromessi.
- Un meccanismo di ripristino o contenimento nel caso emergano effetti collaterali.
Se non riesci ancora a spiegare perché si verifica il problema, investi prima nella possibilità di osservarlo o riprodurlo. Aggiungere un avviso può aiutare a rilevare il problema, ma non equivale a eliminarlo. Allo stesso modo, una modifica al codice che impedisce un caso specifico potrebbe nascondere una regola di business definita male. La soluzione deve coprire il comportamento atteso, compresi i limiti e le eccezioni rilevanti.
Quando cambiare il processo, non solo il sistema
L’origine del problema può trovarsi nelle regole, nelle responsabilità o nella sequenza di lavoro. Sospetta un problema di processo se strumenti diversi mostrano lo stesso guasto, se ogni team applica un’interpretazione differente, se le eccezioni dipendono da conoscenze informali o se l’errore si verifica nel passaggio di consegne tra aree.
In tal caso, verifica chi decide, chi esegue e chi controlla ogni passaggio. Chiarisci le condizioni di ingresso e di uscita, elimina le duplicazioni e specifica che cosa fare quando una condizione non è soddisfatta. Non trasformare ogni variazione in un modulo o in un’ulteriore approvazione: anche ogni controllo ha un costo in termini di tempo e può spostare il problema altrove. Confrontati con le persone che svolgono il lavoro, perché spesso conoscono eccezioni che un diagramma formale non rappresenta.
I cambiamenti di processo richiedono comunicazione e monitoraggio, non soltanto documentazione. Quando possibile, prova il nuovo modo di lavorare su un flusso circoscritto, raccogli i dubbi e aggiorna le istruzioni prima di estenderlo. Se il processo richiede passaggi manuali per compensare un limite tecnico, registra questa dipendenza: può essere una decisione temporanea, ma deve avere un responsabile e un criterio di revisione.
Matrice decisionale e verifica dei risultati
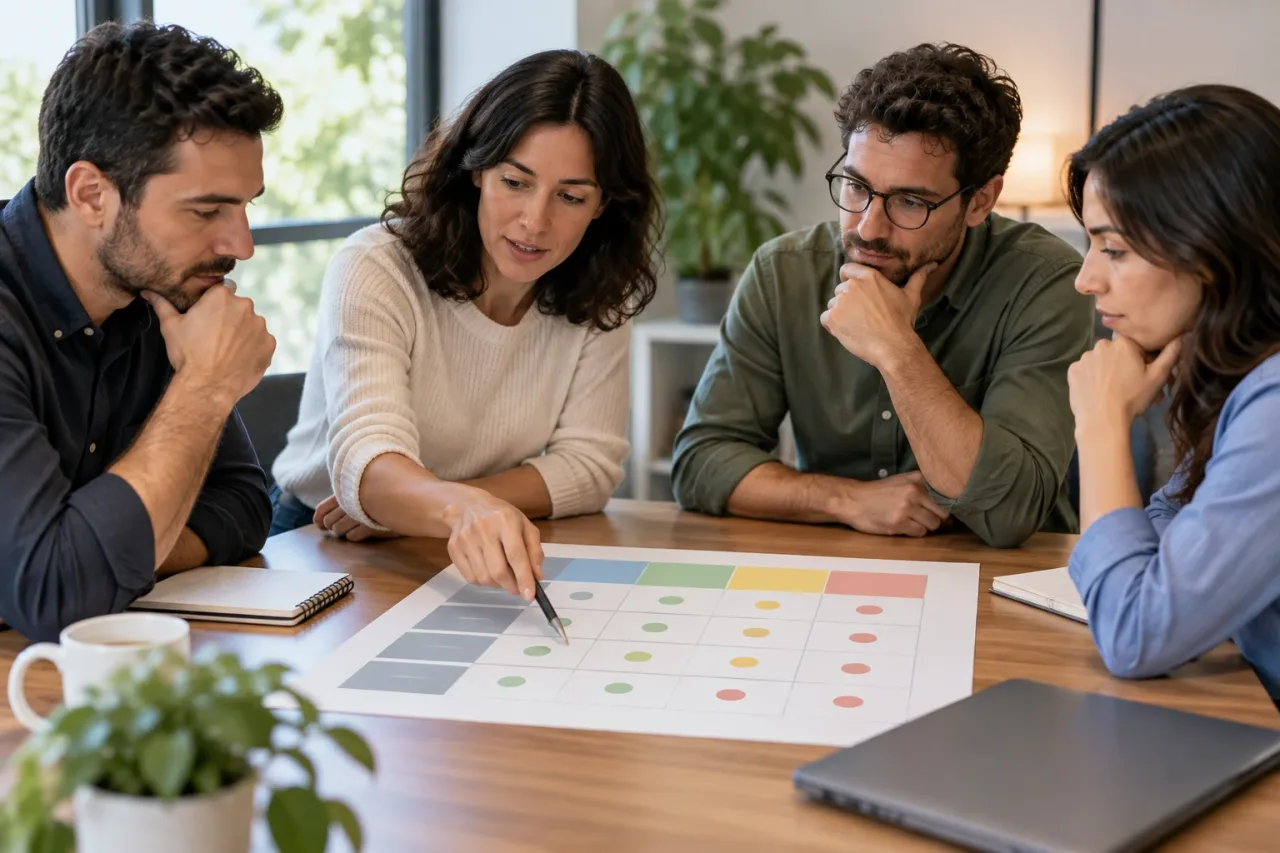
La matrice seguente è un punto di partenza, non sostituisce il giudizio del team. Gli esempi sono ipotetici e vanno verificati alla luce del contesto reale.
- Un caso isolato, impatto limitato e riparazione reversibile: correggi il caso e registra il contesto per individuare eventuali ripetizioni.
- Schema riproducibile in un sistema o in un’integrazione, con portata nota: contieni l’impatto e dai priorità all’eliminazione della causa tecnica, includendo test di regressione.
- Risultati diversi a seconda del team o passaggio ambiguo: rivedi la regola, le responsabilità e la sequenza prima di automatizzare la risposta.
- Impatto elevato o dati difficili da ripristinare, con causa incerta: limita l’esposizione, intensifica l’indagine ed evita modifiche irreversibili finché non hai compreso le dipendenze.
Prima della modifica, stabilisci quale segnale confermerà un miglioramento: meno casi della stessa categoria, meno correzioni manuali, tempi di risoluzione più brevi o meno operazioni interessate. Scegli un periodo di osservazione adeguato al ritmo del processo e confronta condizioni equivalenti: un calo temporaneo potrebbe dipendere da una minore attività, non dalla soluzione.
Controlla anche i segnali di effetti collaterali: rifiuti legittimi, nuovi errori, ritardi, passaggi di consegne aggiuntivi o un maggior numero di eccezioni. Se la ricorrenza diminuisce ma aumenta il lavoro manuale, la misura potrebbe aver spostato il costo invece di risolvere il problema. Decidi quindi se mantenerla, modificarla o ritirarla e documenta la decisione. Una revisione periodica degli incidenti raggruppati permette di capire quando una correzione puntuale è diventata uno schema ricorrente e richiede una risposta più ampia.
In sintesi, risolvi il singolo caso quando è eccezionale e gestibile, elimina la causa quando il meccanismo è identificato e cambia il processo quando l’origine è nelle regole o nei passaggi di consegne. Se la diagnosi è ancora debole, limita il rischio e raccogli prove prima di impegnarti in una soluzione difficile da annullare.