

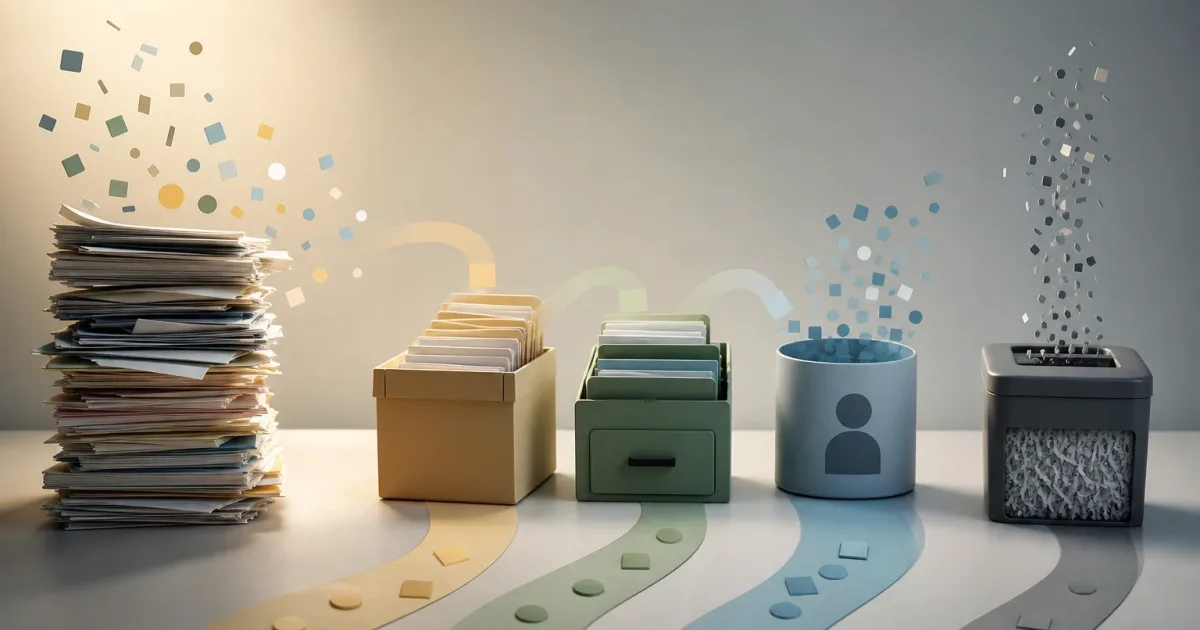
Conservare i dati per impostazione predefinita può sembrare una scelta prudente: potrebbero servire in seguito, aiutare a gestire un incidente o consentire di comprendere meglio gli utenti. Tuttavia, un accumulo privo di regole trasforma database, archivi analitici, registri tecnici e strumenti di assistenza in un onere operativo. Aumentano i costi di archiviazione e migrazione, si moltiplicano i possibili accessi e diventa più difficile distinguere una prova utile da informazioni obsolete.
Una politica di conservazione dei dati efficace non consiste nello stabilire un unico termine universale. È un insieme di decisioni verificabili su quali informazioni servono, per quale processo, chi ne è responsabile, per quanto tempo possono restare accessibili e come ritirarle senza compromettere il prodotto. L'obiettivo non è cancellare il prima possibile né conservare indefinitamente: è mantenere solo ciò che è necessario, con una tracciabilità sufficiente e una rimozione controllata.
Il problema di conservare i dati per inerzia
I dati vengono creati in molti punti del prodotto: moduli, eventi di utilizzo, ordini, conversazioni di assistenza, integrazioni, errori dell'applicazione, backup ed esportazioni manuali. Quando ogni team decide in modo isolato, compaiono repliche con cicli di vita incompatibili. Un record può essere stato eliminato dal sistema transazionale, ma restare disponibile in uno strumento di analisi, in un indice di ricerca o in una copia ripristinabile.
Questa situazione genera rischi concreti. I team di assistenza possono consultare informazioni che non rappresentano più la realtà. I report possono combinare periodi storici con definizioni cambiate nel tempo. Le migrazioni si allungano perché trasferiscono tabelle e file privi di valore attuale. E una richiesta di rimozione diventa difficile da eseguire perché nessuno conosce tutte le ubicazioni del dato.
Il primo segnale diagnostico è che nessuno sa rispondere con precisione dove risiede un dato, quale servizio lo utilizza o chi approva la sua eliminazione. Altri segnali frequenti sono:
- tabelle, campi o dashboard senza un responsabile identificato;
- copie di esportazioni condivise per risolvere esigenze puntuali;
- registri tecnici con identificatori personali conservati per periodi indefiniti;
- processi di eliminazione manuali, eccezionali o dipendenti da una sola persona;
- metriche storiche che non possono essere riprodotte perché non si conoscono la fonte né la trasformazione applicata.
Cosa significa davvero conservare un dato
Prima di assegnare dei termini, è utile separare categorie che spesso vengono confuse. Un dato attivo consente di gestire il servizio corrente: un indirizzo di consegna valido, lo stato di un ordine o una preferenza necessaria per fornire una funzionalità. Uno storico registra fatti passati rilevanti per analisi, assistenza o riconciliazione. Una prova documenta un'azione o una modifica e può essere necessaria per dimostrare come si è svolta un'operazione.
Esistono poi backup e registri tecnici. Un backup è progettato per ripristinare disponibilità o integrità dopo un incidente; non dovrebbe diventare un archivio da consultare ordinariamente. I registri tecnici aiutano a diagnosticare guasti, indagare comportamenti anomali e misurare lo stato di salute dei sistemi, ma possono contenere identificatori, parametri o messaggi che richiedono controlli specifici.
La distinzione è importante perché ogni categoria può richiedere una risposta diversa. Eliminare un dato dal prodotto non implica necessariamente che scompaia all'istante da tutti i backup, ma richiede che questo ritardo sia definito, limitato e non abiliti un normale accesso operativo. Allo stesso modo, conservare una metrica aggregata non richiede di mantenere il dettaglio individuale da cui deriva se quel dettaglio non è più necessario.
Le cinque domande per decidere il ciclo di vita
Per ciascun insieme di dati, ponete le stesse domande. Questo evita decisioni basate sull'intuizione e consente di confrontare sistemi diversi con un linguaggio comune.
- Qual è la finalità concreta? Descrivete il processo, non una formula generica come “nel caso possa servire”. Per esempio: risolvere incidenti relativi agli ordini, prevenire duplicati, calcolare una metrica mensile o ripristinare il servizio dopo un guasto.
- Quale dipendenza operativa esiste? Identificate servizi, report, integrazioni, automazioni e team che utilizzano il dato. Distinguete una dipendenza confermata da una possibilità non verificata.
- Quale livello di dettaglio è necessario? Forse il processo richiede un identificatore pseudonimizzato, uno stato aggregato o una data, ma non il contenuto completo di una conversazione né tutti gli attributi del profilo.
- Cosa accade se il dato viene conservato o eliminato? Valutate l'impatto su operazioni, sicurezza, esperienza utente, analisi e ripristino. Se l'eliminazione impedisce una funzione essenziale, la conservazione deve essere giustificata; se conservare offre soltanto una comodità ipotetica, il dato è candidato a una riduzione.
- Come verrà eseguita e verificata la rimozione? Definite il meccanismo tecnico, il trattamento delle repliche, il registro dell'esecuzione e la prova che conferma il risultato.
Se una finalità non ha un responsabile né un processo associato, non dovrebbe giustificare una conservazione indefinita. Qualora esistano requisiti contrattuali, legali o normativi applicabili, devono essere tradotti in regole concrete e riesaminati dalle persone responsabili della conformità o della consulenza legale. La politica operativa non sostituisce tale verifica; consente di attuarla in modo coerente.
Classificare in base a finalità, sensibilità e accesso
Una classificazione leggera è più sostenibile di una tassonomia eccessivamente dettagliata. Può combinare tre assi: finalità operativa, sensibilità e modello di accesso. La finalità stabilisce perché il dato esiste; la sensibilità determina quali controlli e misure di minimizzazione richiede; l'accesso indica se viene consultato ogni giorno, eccezionalmente o solo per il ripristino.
Per esempio, i dati dei clienti possono includere identità, recapiti, preferenze e attività. Gli ordini possono richiedere una traccia transazionale per un periodo definito. Le conversazioni di assistenza possono essere utili finché esiste un incidente o una relazione di supporto, ma il loro contenuto non deve necessariamente essere mantenuto quanto le metriche sul volume delle richieste. Nei registri dell'applicazione, sostituire gli identificatori diretti con riferimenti tecnici o applicare filtri ai campi può ridurre l'esposizione senza perdere la capacità diagnostica.
Quattro alternative di trattamento
- Conservare in attivo: usatelo se un processo corrente deve consultare e modificare spesso il dato.
- Archiviare: mantenete il dato con accesso limitato e fuori dal flusso abituale quando serve solo per consultazioni eccezionali o storici definiti.
- Anonimizzare o aggregare: eliminate o trasformate la possibilità di collegare l'informazione a una persona quando sono sufficienti tendenze, conteggi o analisi del comportamento collettivo. Verificate che la trasformazione non consenta una reidentificazione ragionevolmente prevedibile nel vostro contesto.
- Eliminare: rimuovete il dato quando non ha più una finalità attuale né una dipendenza giustificata. Includete nell'ambito della revisione indici, cache, esportazioni gestite e flussi derivati.
La pseudonimizzazione merita una distinzione: sostituire un identificatore con un altro riduce l'esposizione in alcuni flussi, ma non equivale necessariamente all'anonimizzazione se esiste ancora una modalità ragionevole di collegamento.
Dipendenze e rimozione sicura prima di eliminare
L'errore più costoso è eseguire un'eliminazione senza comprendere le dipendenze. Prima di attivare una regola automatica, esaminate query dei report, attività pianificate, API, code di eventi, strumenti di assistenza, motori di ricerca e modelli analitici. Non basta chiedere ai team: quando possibile, integrate questa consultazione con inventari tecnici, osservabilità e test in un ambiente controllato.
Una rimozione sicura segue di norma questa sequenza:
- Inventariare le ubicazioni primarie, le repliche e le destinazioni derivate.
- Etichettare i consumatori e confermare quale dato minimo serve a ciascuno.
- Definire una data o una condizione di scadenza leggibile da sistemi e persone.
- Testare la regola su un campione o in un ambiente non di produzione.
- Applicare l'eliminazione, l'archiviazione o la trasformazione in modo automatizzato e ripetibile.
- Verificare che i consumatori previsti continuino a funzionare e che il dato non compaia più nei percorsi previsti.
- Registrare l'esecuzione, le eccezioni approvate e la successiva revisione.
I backup richiedono una regola separata: documentate il loro periodo di rotazione, chi può ripristinarli e come evitare che un ripristino reintroduca dati rimossi nell'ambiente operativo senza controlli. Se viene ripristinata una copia, il team deve sapere quali attività di sincronizzazione o rimozione successiva sono necessarie.
Costruire una matrice di conservazione operativa
La matrice di conservazione è il ponte tra la decisione aziendale e l'implementazione. Deve essere semplice da mantenere e sufficientemente concreta affinché prodotto, dati, infrastruttura e operazioni interpretino la stessa regola. Assegnate un responsabile della finalità e uno dell'implementazione; possono coincidere, ma le loro responsabilità sono diverse.
insieme di dati | finalità | responsabile | ubicazione | consumatori
livello di accesso | condizione di scadenza | trattamento | metodo | revisione
In un servizio connesso, una matrice ipotetica potrebbe separare tre casi. I dati dei clienti attivi vengono conservati finché necessari per gestire l'account e riesaminati quando cambia il loro stato. Gli ordini sono mantenuti in base alla finalità transazionale definita, con accesso limitato ai team che risolvono incidenti e riconciliazioni. Le conversazioni di assistenza hanno una regola propria: il contenuto viene rimosso o trasformato dopo il periodo concordato, mentre gli indicatori aggregati di volume e tempi possono restare disponibili per analizzare le operazioni.
La qualità di una politica si misura dalla sua esecuzione: regole automatiche, eccezioni con scadenza, evidenze di revisione e avvisi quando un processo fallisce. Rivedete la matrice in caso di modifiche al prodotto, nuove integrazioni, riprogettazioni dell'analisi, migrazioni o incidenti. In questo modo, la conservazione smette di essere un'attività reattiva e diventa una capacità di prodotto e operativa: conservare ciò che apporta valore dimostrabile e rimuovere ciò che aggiunge soltanto costo, esposizione e complessità.