

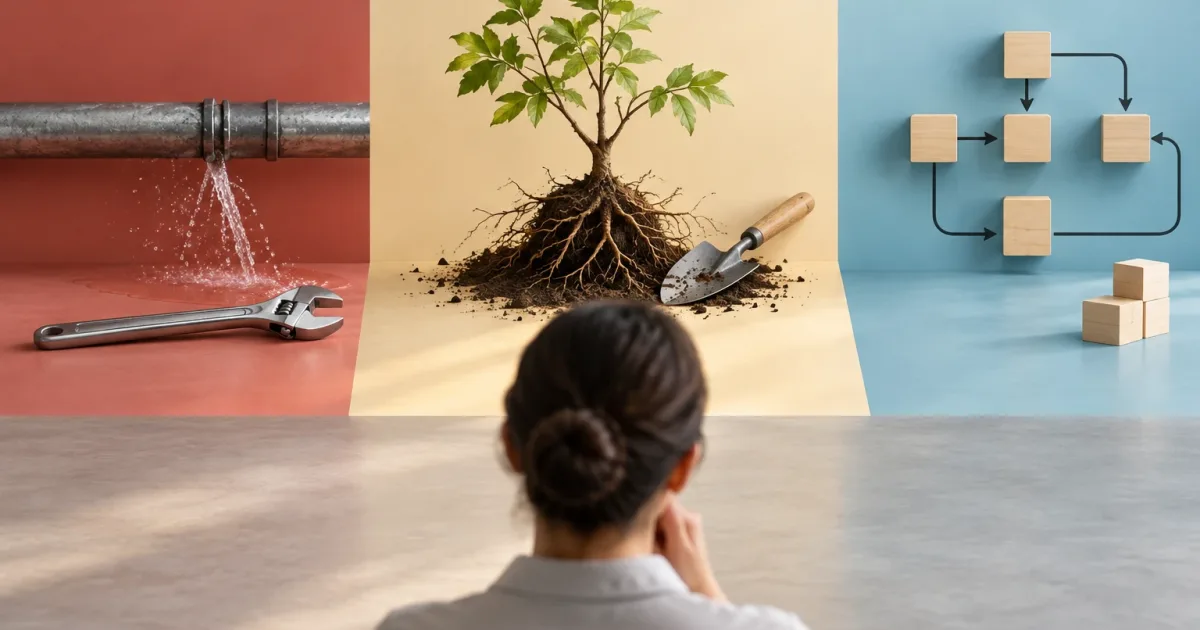
Wenn ein Vorfall erneut auftritt, ist die schnellste Reaktion nicht immer die passende. Die Behebung des konkreten Falls kann den Betrieb wiederherstellen, lässt aber möglicherweise die Ursache bestehen. Umgekehrt kostet es Ressourcen und kann neue Risiken schaffen, einen ganzen Prozess wegen eines einmaligen Problems neu zu gestalten. Entscheidend ist, Symptome und Ursachen auseinanderzuhalten, die Auswirkungen einzuschätzen und eine angemessene Maßnahme zu wählen.
Dieser Rahmen hilft Verantwortlichen aus Produktentwicklung, IT und Betrieb, zwischen drei Reaktionen zu wählen: den konkreten Fall beheben, eine technische Ursache beseitigen oder die Arbeitsweise ändern. Dafür müssen nicht bereits alle Informationen vorliegen. Es ist jedoch sinnvoll, bekannte Fakten festzuhalten, Unsicherheiten ausdrücklich zu benennen und festzulegen, wie sich das Ergebnis überprüfen lässt.
Symptom und Ursache voneinander trennen
Ein Vorfall ist das sichtbare Ereignis: Ein Vorgang bleibt unvollständig, ein Datenwert stimmt nicht oder eine Aufgabe erfordert manuelles Eingreifen. Die Ursache ist der Mechanismus, der dieses Ergebnis ermöglicht. Dahinter können ein Softwarefehler, eine Schnittstelle, eine mehrdeutige Regel, ein schlecht behandelter Ausnahmefall oder mehrere zusammenwirkende Faktoren stecken.
Beschreibe das Problem vor der Wahl einer Lösung anhand beobachtbarer Merkmale:
- Was ist passiert? Welches falsche Ergebnis ist entstanden oder wo kam es zum Stillstand?
- Wo und wann ist es passiert? Welcher Schritt, welches System oder welche Bedingung war beteiligt?
- Wen oder was betrifft es? Welche Personen, Abläufe, Daten oder Dienste sind betroffen?
- Welche Belege liegen vor? Gibt es Protokolle, Meldungen, Eingaben oder reproduzierbare Abläufe?
- Was ist noch unbekannt? Welche Hypothesen müssen überprüft werden?
Verwechsle eine erste plausible Erklärung nicht mit einer bestätigten Diagnose. Hat etwa eine Person einen falschen Wert eingegeben, beweist das noch nicht, dass ein individueller Fehler die Ursache war. Vielleicht ist eine Bezeichnung missverständlich, eine Validierung fehlt oder eine Anleitung widersprüchlich. Eine sorgfältige Untersuchung fragt, welche Bedingungen das Ergebnis ermöglicht haben – nicht nur, wer den letzten Schritt ausgeführt hat.
Vorfälle einordnen, bevor du Aufwand investierst
Bewerte jeden Vorfall anhand von vier Kriterien. Zu Beginn ist keine ausgefeilte Punkteskala nötig. Wichtig ist, die Kriterien festzuhalten und Fälle einheitlich miteinander zu vergleichen.
- Häufigkeit: Handelt es sich um einen Einzelfall, tritt das Problem unter einer bestimmten Bedingung erneut auf oder zeigt es sich in verschiedenen Bereichen des Betriebs?
- Auswirkungen: Welche Folgen hat es für Kundinnen und Kunden, Umsatz, Compliance, Datenqualität, Arbeitsaufwand oder die Kontinuität des Dienstes?
- Umfang: Betrifft es eine Person oder Transaktion, ein Segment, mehrere Teams oder den gesamten Ablauf?
- Umkehrbarkeit: Lässt sich die Korrektur sicher rückgängig machen, falls sie sich als falsch erweist? Gibt es dauerhafte Auswirkungen auf Daten oder spätere Entscheidungen?
Berücksichtige auch, wie sicher die Diagnose ist. Bei einem Vorfall mit großen Auswirkungen und unklarer Ursache kann es zunächst nötig sein, die Folgen einzudämmen und Belege zu sammeln. Ein reproduzierbarer, klar abgegrenzter Fehler erlaubt dagegen eher, eine dauerhafte Korrektur zu prüfen. Trenne Dringlichkeit von endgültiger Lösung: Ein Risiko sofort einzudämmen bedeutet nicht, dass das zugrunde liegende Problem damit gelöst ist.
Wann eine punktuelle Korrektur genügt
Eine punktuelle Korrektur ist meist angemessen, wenn ein Fall außergewöhnlich ist, die Auswirkungen begrenzt sind, die Ursache situationsbedingt erscheint und sich das Ergebnis sicher reparieren lässt. Das kann bedeuten, einen Vorgang abzuschließen, einen Wert wiederherzustellen oder eine genehmigte Ausnahme anzuwenden. Voraussetzung ist, dass die Maßnahme kein Muster verdeckt und keine unsichtbare operative Schuld entstehen lässt.
Erfasse jeden Fall mit einer einheitlichen Kategorie, Datum, Kontext, Auswirkungen, ergriffener Maßnahme und einem Verweis auf die verfügbaren Belege. Halte außerdem fest, ob die Ursache bestätigt oder noch eine Hypothese ist. Beschreiben verschiedene Teams dasselbe Problem mit unterschiedlichen Begriffen, lassen sich Wiederholungen schwerer erkennen. Eine kurze, gemeinsam genutzte Klassifikation erleichtert es, Vorfälle zusammenzuführen.
Prüfe bei der Korrektur auch Abhängigkeiten: Wenn andere Prozesse den betroffenen Wert oder das Ergebnis weiterverwenden, kann eine lokale Reparatur widersprüchliche Zustände hinterlassen. Sorge für eine Möglichkeit zur Überprüfung und lege fest, wer Ausnahmen genehmigen darf. Tritt derselbe Fall erneut auf, reicht eine punktuelle Korrektur als Strategie nicht mehr aus – auch wenn jeder einzelne Vorfall weiterhin bearbeitet werden muss.
Wann die Ursache dauerhaft beseitigt werden sollte
Suche nach einer dauerhaften Lösung, wenn mehrere Vorfälle denselben Mechanismus haben, unter bekannten Bedingungen reproduzierbar sind, regelmäßig manuelle Arbeit verursachen oder ein nicht akzeptables Risiko darstellen. In der Software kann die Antwort darin bestehen, eine Validierung zu korrigieren, unerwartete Antworten korrekt zu behandeln oder eine Schnittstelle robuster zu machen. Im Betrieb kann es darum gehen, eine Regel zu präzisieren oder einen Übergang zu verhindern, der unvollständige Daten zulässt.
Eine dauerhafte Maßnahme sollte auf einer bestätigten Ursache beruhen und nicht nur auf dem häufigsten Symptom. Lege vor der Umsetzung Folgendes fest:
- Die Hypothese zur Ursache und die Belege, die sie stützen.
- Die kleinste Änderung, die den Fehler verhindert oder erkennbar macht.
- Die Abläufe, Daten und Nutzergruppen, die betroffen sein könnten.
- Einen Test des ursprünglichen Falls sowie ähnlicher Szenarien, die weiterhin funktionieren müssen.
- Eine Möglichkeit zum Zurücksetzen oder Eindämmen, falls Nebenwirkungen auftreten.
Kannst du noch nicht erklären, warum der Vorfall auftritt, investiere zunächst in Beobachtbarkeit oder Reproduzierbarkeit. Ein zusätzlicher Alarm kann helfen, das Problem zu erkennen, beseitigt es aber nicht. Ebenso könnte eine Codeänderung, die einen bestimmten Fall verhindert, eine unklar definierte Geschäftsregel verdecken. Die Lösung muss das erwartete Verhalten abdecken – einschließlich wichtiger Grenzen und Ausnahmen.
Wann der Prozess statt nur das System geändert werden sollte
Der Ursprung kann in Regeln, Zuständigkeiten oder der Reihenfolge der Arbeitsschritte liegen. Ein Prozessproblem ist wahrscheinlich, wenn derselbe Fehler in verschiedenen Werkzeugen auftritt, Teams dieselbe Regel unterschiedlich auslegen, Ausnahmen von informellem Wissen abhängen oder der Fehler bei einer Übergabe zwischen Bereichen entsteht.
Prüfe in diesem Fall, wer über jeden Schritt entscheidet, ihn ausführt und kontrolliert. Kläre die Bedingungen für Ein- und Austritt, beseitige doppelte Arbeit und beschreibe, was zu tun ist, wenn eine Bedingung nicht erfüllt ist. Verwandle nicht jede Abweichung in ein Formular oder eine zusätzliche Freigabe: Auch Kontrollen kosten Zeit und können das Problem lediglich verlagern. Beziehe die Menschen ein, die die Arbeit tatsächlich erledigen. Sie kennen oft Ausnahmen, die in einem formalen Ablaufdiagramm nicht auftauchen.
Prozessänderungen erfordern Kommunikation und Nachverfolgung, nicht nur Dokumentation. Erprobe die neue Arbeitsweise, wenn möglich, zunächst in einem begrenzten Ablauf. Sammle offene Fragen und passe Anweisungen an, bevor du die Änderung ausweitest. Sind manuelle Schritte nötig, um eine technische Einschränkung auszugleichen, halte diese Abhängigkeit fest. Sie kann eine vorübergehende Entscheidung sein, sollte aber eine verantwortliche Person und einen Prüfzeitpunkt haben.
Entscheidungshilfe und Überprüfung der Ergebnisse
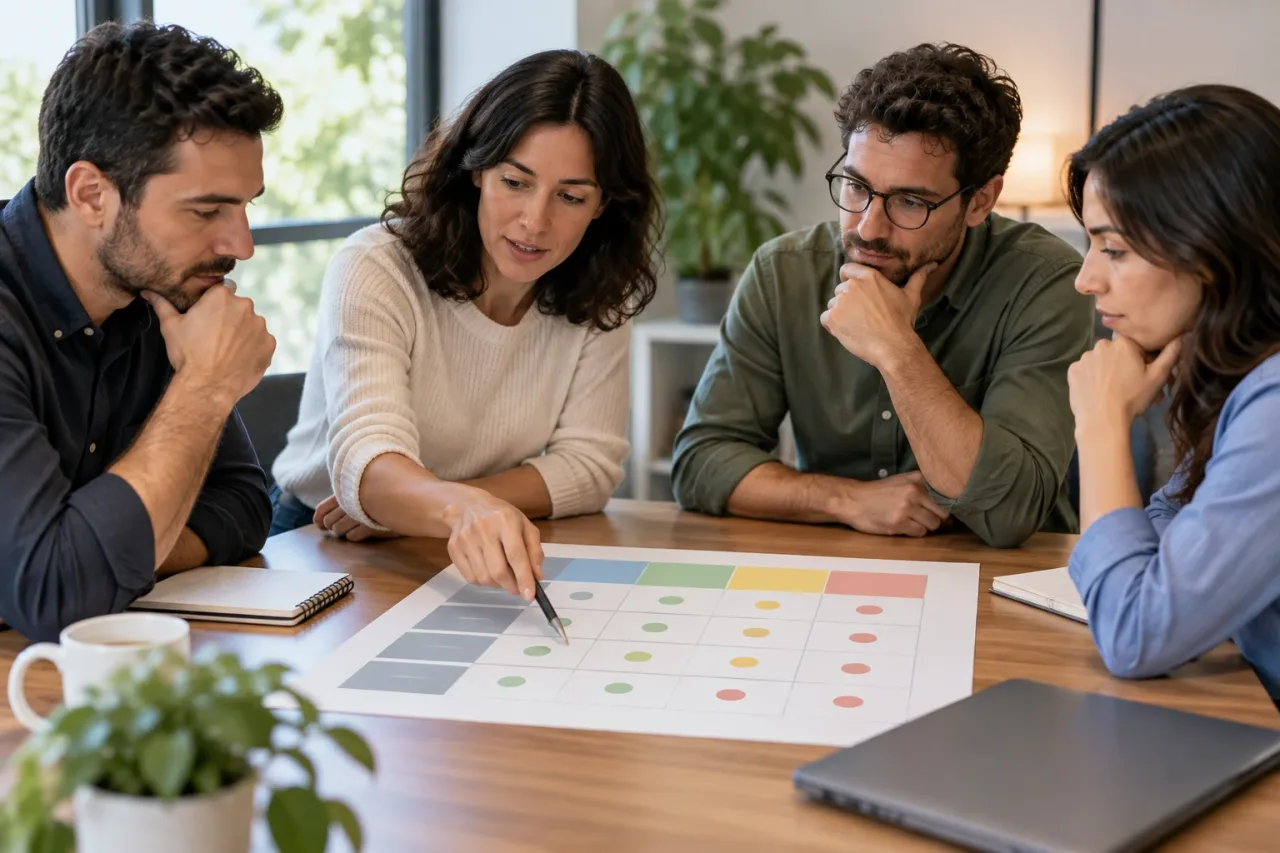
Die folgende Übersicht ist ein Ausgangspunkt und ersetzt nicht das Urteilsvermögen des Teams. Die Beispiele sind hypothetisch und müssen anhand des tatsächlichen Kontexts geprüft werden.
- Einzelfall, geringe Auswirkungen und reversible Reparatur: Behebe den konkreten Fall und halte den Kontext fest, um Wiederholungen erkennen zu können.
- Reproduzierbares Muster in einem System oder einer Schnittstelle mit bekanntem Umfang: Begrenze die Auswirkungen und priorisiere die Beseitigung der technischen Ursache, einschließlich Regressionstests.
- Unterschiedliche Ergebnisse je nach Team oder ein mehrdeutiger Arbeitsschritt: Prüfe Regeln, Zuständigkeiten und Reihenfolge, bevor du die Reaktion automatisierst.
- Große Auswirkungen oder schwer wiederherstellbare Daten bei unklarer Ursache: Begrenze das Risiko, eskaliere die Untersuchung und vermeide unumkehrbare Änderungen, bis die Abhängigkeiten geklärt sind.
Lege vor der Änderung fest, welches Signal eine Verbesserung belegt: weniger Vorfälle derselben Kategorie, weniger manuelle Korrekturen, kürzere Behebungszeiten oder weniger betroffene Vorgänge. Wähle einen Beobachtungszeitraum, der zum Tempo des Prozesses passt, und vergleiche ähnliche Bedingungen. Ein vorübergehender Rückgang kann auf geringere Aktivität zurückzuführen sein und muss nicht bedeuten, dass die Lösung wirkt.
Achte auch auf mögliche Nebenwirkungen: berechtigte Ablehnungen, neue Fehler, Verzögerungen, zusätzliche Übergaben oder mehr Ausnahmen. Sinkt die Zahl wiederkehrender Vorfälle, während der manuelle Aufwand steigt, hat die Maßnahme die Kosten vielleicht nur verlagert. Entscheide dann, ob sie beibehalten, angepasst oder zurückgenommen wird, und dokumentiere die Entscheidung. Eine regelmäßige Überprüfung gruppierter Vorfälle zeigt, wann aus einer punktuellen Korrektur ein Muster geworden ist, das eine umfassendere Reaktion erfordert.
Kurz gesagt: Behebe den konkreten Fall, wenn er außergewöhnlich und kontrollierbar ist; beseitige die Ursache dauerhaft, wenn der Mechanismus feststeht; ändere den Prozess, wenn Regeln oder Übergaben das Problem verursachen. Ist die Diagnose noch unsicher, begrenze das Risiko und sammle Belege, bevor du dich auf eine schwer umkehrbare Lösung festlegst.