Eine fehlgeschlagene Nachricht sollte nicht immer sofort erneut verarbeitet werden – und auch nicht unbegrenzt im System bleiben. Eine Benachrichtigung über eine ausstehende Zahlung, eine Lagerbestandsaktualisierung und eine Terminerinnerung unterscheiden sich in ihrer Dringlichkeit und darin, welchen Nutzen sie noch haben, wenn sie verspätet ankommen. Die Entscheidung, wie lange fehlgeschlagene Nachrichten erneut verarbeitet werden, ist deshalb sowohl eine betriebliche als auch eine technische Frage.
Eine Richtlinie sollte drei Fragen beantworten: Welche Fehler lassen sich beheben? Wie lange ist die Ausführung des jeweiligen Ereignisses noch sinnvoll? Und was geschieht, wenn diese Frist abläuft? Klare Antworten verringern sowohl unbemerkte Ausfälle als auch verspätete Ausführungen, die Kunden verwirren oder Systeme in widersprüchliche Zustände versetzen.
Warum wiederholte Verarbeitungsversuche zum Problem werden können
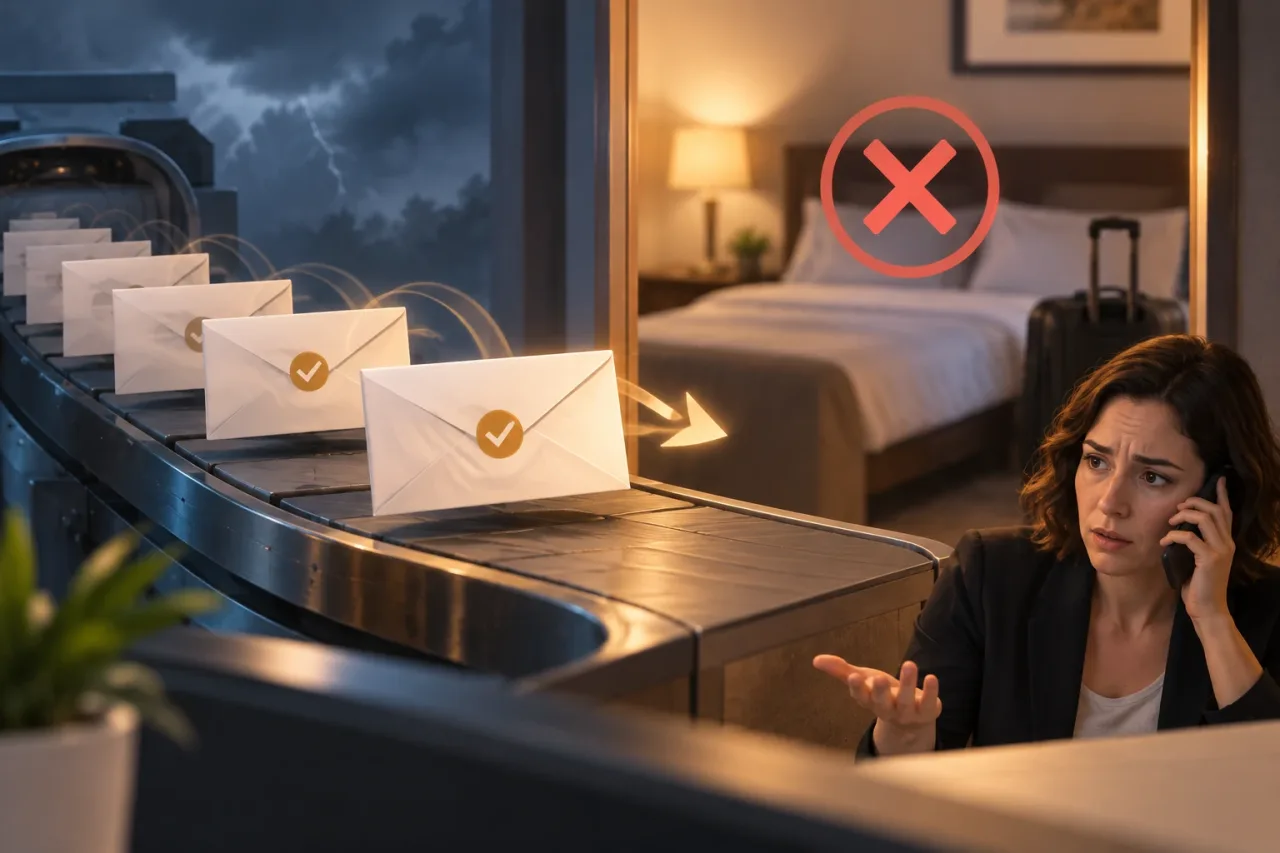
Ein erneuter Versuch kann einen Vorgang nach einer kurzen Unterbrechung erfolgreich abschließen. Jeder weitere Versuch beansprucht jedoch Ressourcen und kann unerwünschte Folgen haben, wenn die Aktion inzwischen nicht mehr gültig ist. Wird etwa eine Bestätigung versendet, nachdem eine Buchung storniert wurde, kann das Rückfragen und zusätzlichen Supportaufwand verursachen – selbst wenn die Nachricht schließlich zugestellt wird.
Das Risiko besteht nicht nur in der Verzögerung. Eine Warteschlange mit alten Ereignissen kann die Bearbeitung aktueller Nachrichten erschweren. Ist außerdem unklar, ob eine Anfrage bereits verarbeitet wurde, kann ein weiterer Versuch einen Vorgang doppelt ausführen. Ziel der Richtlinie sollte daher nicht die größtmögliche Zahl von Versuchen sein. Sie sollte die Chance erhöhen, weiterhin nützliche Aktionen abzuschließen, und zugleich die Folgen verspäteter Ausführungen begrenzen.
Unterscheiden Sie zwischen der technischen Aufbewahrungsdauer – wie lange das System ein Ereignis speichert – und dem Gültigkeitszeitraum – bis zu welchem Zeitpunkt es ausgeführt werden darf. Beides kann übereinstimmen, muss es aber nicht. Ein Ereignis kann nach Ablauf seiner Gültigkeit zur Untersuchung des Vorfalls gespeichert bleiben, ohne dass es automatisch erneut verarbeitet werden darf.
Fehler klassifizieren, bevor Sie den Zeitraum festlegen
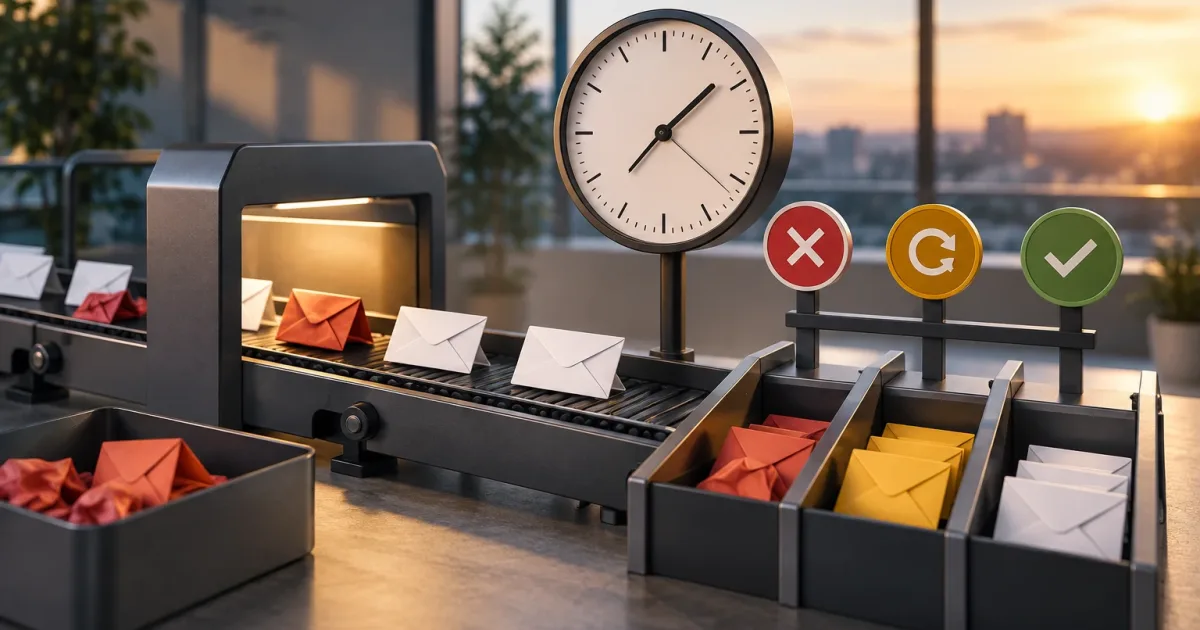
Fehlercodes, Antworten der Integration und der Prozessstatus helfen bei der Entscheidung, ob ein weiterer Versuch sinnvoll ist. Teilen Sie die Fälle als operativen Rahmen in drei Gruppen ein und legen Sie für jede Gruppe eine passende Maßnahme fest:
- Vorübergehende Fehler: Netzwerkunterbrechungen, zeitweilige Dienstlimits oder kurzzeitige Nichtverfügbarkeit. Ein erneuter Versuch kann sinnvoll sein, solange die Aktion noch gültig ist.
- Dauerhafte Fehler: ungültige Daten, ein nicht existierender Empfänger oder eine Anfrage, die aus einem Grund abgelehnt wurde, der sich nicht innerhalb weniger Minuten ändert. Ohne Behebung der Ursache hilft eine Wiederholung selten. In der Regel sollte der Prozess angehalten und eine Korrektur oder ein Eingreifen angefordert werden.
- Unklare Fehler: Die Verbindung wurde unterbrochen und das System weiß nicht, ob der empfangende Dienst den Vorgang abgeschlossen hat. Prüfen Sie, wenn möglich, zuerst den Status oder verwenden Sie Schutzmaßnahmen gegen doppelte Auswirkungen.
Die Antworten eines Dienstes sind nicht immer eindeutig zu interpretieren. Eine vorübergehende Antwort kann auf eine länger andauernde Störung hindeuten; ein scheinbar endgültiger Fehler kann sich durch korrigierte Daten beheben lassen. Dokumentieren Sie die Einordnung für jede Integration und prüfen Sie wiederkehrende Fälle. Wenn sich die Ursache nicht zuverlässig bestimmen lässt, sollten Sie nicht standardmäßig jeden Fehler als vorübergehend behandeln.
Fristen nach Dringlichkeit, Gültigkeit und Folgen festlegen
Das Zeitfenster für erneute Versuche beginnt mit dem Auftreten des Fehlers und endet, sobald das Ereignis nicht mehr automatisch ausgeführt werden darf. Legen Sie die Frist gemeinsam mit den Fachbereichen und dem Betrieb anhand von drei Kriterien fest:
- Dringlichkeit: Wie viel Verzögerung verträgt der Prozess, bevor eine Entscheidung, ein Versprechen oder der Kundenservice beeinträchtigt wird?
- Gültigkeit: Bis wann sind Inhalt oder Aktion noch korrekt? Berücksichtigen Sie spätere Statusänderungen, etwa eine Stornierung, eine bereits geklärte Zahlung oder einen vergangenen Termin.
- Folgen einer verspäteten Ausführung: Welche Kosten entstehen, wenn die Aktion erst danach ausgeführt wird? Möglich sind eine verwirrende Nachricht, eine falsche Aktualisierung oder manueller Aufwand. Vielleicht ist es aber auch vertretbar, eine interne Aufgabe ohne sichtbare Auswirkungen abzuschließen.
Richten Sie das Zeitfenster nach dem tatsächlichen Lebenszyklus des Prozesses aus. Eine Mitteilung zu einem unmittelbar bevorstehenden Termin kann rasch an Nutzen verlieren; eine Katalogsynchronisierung verträgt möglicherweise eine längere Verzögerung. Verwenden Sie nicht für alle Ereignisse dieselbe Frist, nur weil sich die Konfiguration dadurch vereinfacht. Gruppieren Sie Ereignisse mit ähnlichen Folgen und definieren Sie Ausnahmen nur bei einem klaren Grund.
Hängt die Gültigkeit von einem veränderlichen Status ab, reicht es nicht, die Stunden seit dem ersten Fehler zu zählen. Prüfen Sie vor einer verspäteten Ausführung, ob die Aktion noch zulässig ist. Ist diese Prüfung nicht möglich, verkürzen Sie das Zeitfenster oder leiten Sie den Fall zur Prüfung weiter, statt die fortbestehende Gültigkeit einfach vorauszusetzen.
Abstände und Grenzen festlegen, ohne Lastspitzen auszulösen
Ein gleichbleibender, kurzer Abstand kann dazu führen, dass während einer Unterbrechung viele Ereignisse gleichzeitig erneut verarbeitet werden. Erwägen Sie stattdessen wachsende Abstände zwischen den Versuchen und eine Obergrenze für die Gesamtdauer oder die Anzahl der Versuche. Größere Abstände verringern die Belastung des betroffenen Dienstes und geben ihm Zeit, sich zu erholen. Zufällige Abweichungen bei den Abständen können verhindern, dass synchronisierte Prozesse gleichzeitig neue Anfragen senden.
Die Einstellungen sollten sich am beobachteten Verhalten orientieren, nicht an einer willkürlichen Zahl. Prüfen Sie, wie lange typische Unterbrechungen dauern, wie oft Wiederholungen erfolgreich sind und wann ein Ereignis seinen Nutzen verliert. Begrenzen Sie Versuche, damit sie nicht endlos weiterlaufen, und räumen Sie kurzen Störungen dennoch eine realistische Chance zur Behebung ein. Gibt ein Dienst vor, dass noch nicht erneut versucht werden soll, beachten Sie diesen Hinweis, sofern die Integration dies unterstützt.
Trennen Sie außerdem die Obergrenze der Versuche von der Zahl gleichzeitiger Anfragen. Bei einer größeren Störung können unkontrolliert erhöhte Wiederholungen die Lage verschlimmern. Steigt das Alter der ausstehenden Ereignisse, während zugleich mehr Fehler auftreten, sollten Sie den Zustand des Dienstes prüfen und die Belastung begrenzen, statt die Wiederholungen zu beschleunigen.
Was nach Ablauf des Zeitfensters geschehen sollte
Nach Ablauf der Frist muss es einen klar definierten nächsten Schritt geben. Ohne erneute Versuche und ohne dokumentiertes Ergebnis fehlt die nötige Transparenz. Legen Sie je Ereignistyp fest, welche Option zutrifft:
- Verwerfen: für abgelaufene Ereignisse mit geringen Auswirkungen, deren Ausführung nicht mehr gültig wäre. Halten Sie genügend Informationen fest, um die Entscheidung zu erklären und Muster zu erkennen.
- Manuell prüfen: bei erheblichen Auswirkungen, ungeklärter Ursache oder unklarem Ergebnis. Die Prüfung braucht eine verantwortliche Person, den nötigen Kontext und eine konkrete Handlungsmöglichkeit: korrigieren, kontrolliert erneut versuchen oder abschließen.
- Ausgleichsmaßnahme einleiten: wenn ein Teilergebnis korrigiert oder ein vereinbarter Zustand wiederhergestellt werden muss. Auch für die Ausgleichsmaßnahme braucht es Bedingungen, Zuständigkeit und Dokumentation. Sie ist nicht einfach ein weiterer Wiederholungsversuch.
Die manuelle Prüfung darf nicht zu einer Warteschlange ohne Zuständigkeit werden. Legen Sie fest, wer sie bearbeitet, wie nach Alter und Auswirkungen priorisiert wird und was geschieht, wenn innerhalb der vereinbarten Frist niemand handelt. Können Mitarbeitende anhand der verfügbaren Angaben nicht zwischen einem behebbaren und einem veralteten Ereignis unterscheiden, liegt das Problem in der Gestaltung der Prüfung – nicht in der Arbeitsgeschwindigkeit des Teams.
Die nötigen Informationen für Diagnose und Maßnahmen erfassen
Speichern Sie für jedes Ereignis eine nachverfolgbare Kennung, den Ereignistyp, den Status, das Alter, Anzahl und Zeitpunkte der Versuche, die erfasste Ursache, den nächsten Schritt und die Entscheidung nach Fristablauf. Gibt es mehrere Integrationen, erfassen Sie auch das Zielsystem. Vermeiden Sie unnötige personenbezogene Daten oder Geheimnisse für die Diagnose und beachten Sie die geltenden Regeln für Zugriff und Aufbewahrung.
Diese Kennzahlen helfen, eine zu kurze Frist von einer externen Störung zu unterscheiden: den Anteil erfolgreich wiederaufgenommener Nachrichten, die Zeit bis zur Wiederherstellung, die Zahl abgelaufener Ereignisse, häufige Ursachen sowie Umfang und Alter der offenen manuellen Prüfungen. Betrachten Sie die Werte getrennt nach Ereignistyp. Eine hohe Erfolgsquote bei Wiederholungen rechtfertigt keine längere Frist, wenn die Ereignisse nach ihrer Wiederherstellung bereits wertlos sind.
Checkliste für die gemeinsame Richtlinie
- Welche geschäftliche Wirkung hat das Ereignis, und wann verliert es seine Gültigkeit?
- Welche Fehler sind bei jeder Integration vorübergehend, dauerhaft oder unklar?
- Wie lang ist das maximale Zeitfenster, und wie lässt sich die fortbestehende Gültigkeit prüfen?
- Welche Abstände und Obergrenzen verhindern übermäßige Last und endlose Wiederholungen?
- Wird ein Ereignis nach Fristablauf verworfen, geprüft oder durch eine Ausgleichsmaßnahme behandelt? Wer ist zuständig?
- Welche Daten und Kennzahlen helfen, das Ergebnis zu erklären und die Richtlinie zu verbessern?
Wie lange fehlgeschlagene Nachrichten erneut verarbeitet werden sollten, hängt letztlich davon ab, wie lange die Ursache bestehen bleibt und wie lange die Aktion währenddessen noch sinnvoll ist. Legen Sie Zeitfenster nach den möglichen Auswirkungen fest, begrenzen Sie die Versuche, behandeln Sie dauerhafte Fehler anders und vereinbaren Sie einen klaren nächsten Schritt. Prüfen Sie anschließend die Ereignisse, die besonders häufig ablaufen oder manuellen Aufwand verursachen. Dort liegen oft die besten Ansatzpunkte, um die Klassifizierung, die Integration oder den Prozess selbst zu verbessern.