

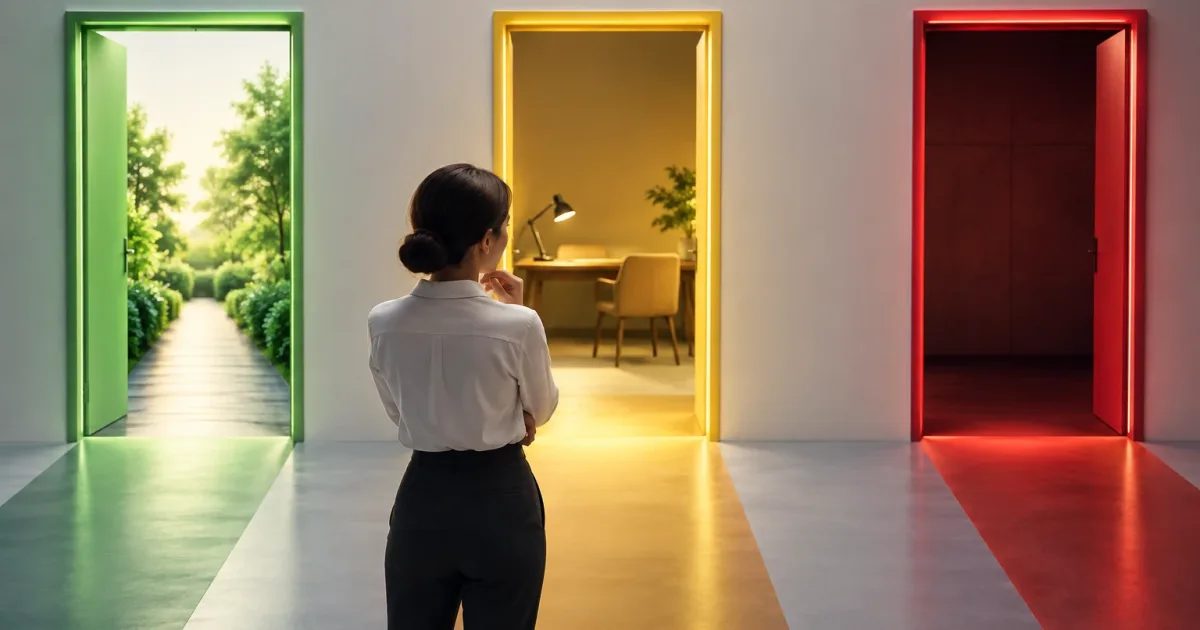
Eine automatische Klassifizierung sollte nicht allein deshalb akzeptiert werden, weil das Modell einen hohen Wert ausgibt. Dieser Wert ist eine Einschätzung des Systems, keine Garantie dafür, dass die Kategorie stimmt oder die Entscheidung für den Prozess geeignet ist. Um festzulegen, wie mit jedem Ergebnis umzugehen ist, müssen die Vorhersagequalität, die Fehlerkosten, die Möglichkeit einer Prüfung und die betrieblichen Folgen gemeinsam betrachtet werden.
Ein praktisches Rahmenwerk sieht drei Wege vor: automatische Annahme, menschliche Prüfung sowie Ablehnung oder Weiterleitung an einen alternativen Prozess. Die Grenzen zwischen diesen Wegen können je nach Kategorie variieren und sich im Lauf der Zeit ändern. Ziel ist nicht, um jeden Preis möglichst viel zu automatisieren, sondern ausreichend sichere Fälle automatisch zu bearbeiten und jene sichtbar zu machen, die Aufmerksamkeit erfordern.
Ein Vertrauenswert ist keine Entscheidung
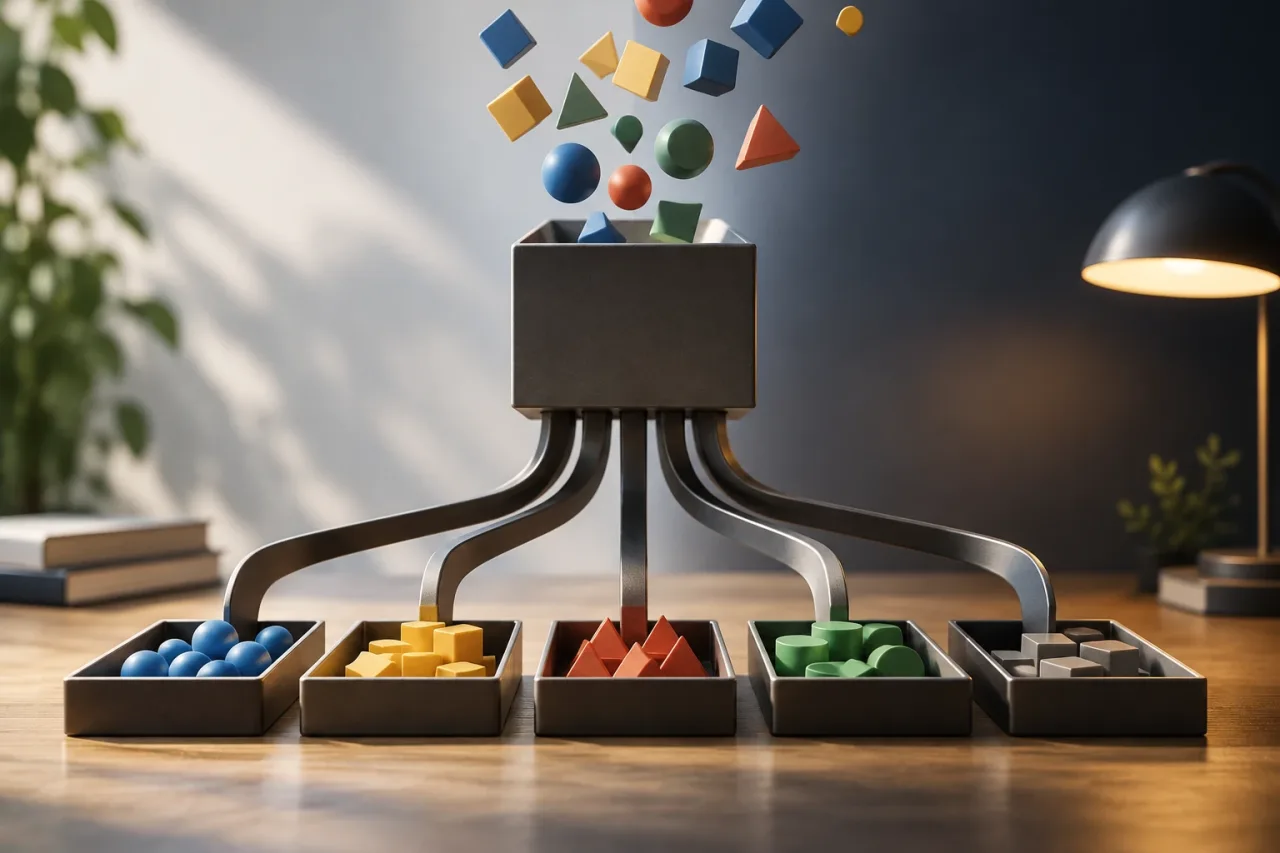
Klassifikatoren können eine Kategorie und einen zugehörigen Wert ausgeben. Ein Wert von 0,9 bedeutet jedoch nicht zwangsläufig, dass das Ergebnis im konkreten Einsatz mit einer Wahrscheinlichkeit von 90 Prozent richtig ist. Die Interpretation hängt davon ab, wie das Modell trainiert und bewertet wurde, wie repräsentativ die Daten sind und ob die Werte kalibriert wurden.
Außerdem können mit demselben Wert unterschiedliche Risiken verbunden sein. Eine Informationsanfrage als „allgemein“ statt als „Abrechnung“ einzuordnen, kann eine geringfügige Verzögerung verursachen. Wird dagegen eine dringende Anfrage als Routinefall eingestuft, können die Folgen schwerwiegender sein. Deshalb sollte nicht ohne vorherige Analyse der Kosten für die verschiedenen Fehlertypen ein einziger Schwellenwert für alle Klassen festgelegt werden.
Prüfe vor der Automatisierung, was der verfügbare Wert aussagt, wie er sich bei repräsentativen Daten verhält und ob das Modell sich enthalten kann, wenn es keine hinreichend eindeutige Antwort findet. Ist der Wert nicht kalibriert, solltest du ihn als Signal zur Sortierung oder Priorisierung verwenden, nicht als exakte Wahrscheinlichkeit.
Die Fehlerkosten je Kategorie berechnen
Vergleiche für jede Klasse zwei Fehlerarten: das falsch positive Ergebnis, bei dem das System eine unzutreffende Kategorie zuweist, und das falsch negative Ergebnis, bei dem es eine tatsächlich zutreffende Kategorie nicht erkennt. Bei einer Mehrklassenklassifizierung solltest du konkret festhalten, welche Verwechslungen wirklich schädlich sind. Nicht jede falsche Kategorie hat dieselben Auswirkungen.
Eine Konfusionsmatrix je Kategorie hilft, häufige Fehler zu erkennen. Kennzahlen ersetzen jedoch nicht die Analyse des Arbeitsablaufs. Frage die zuständigen Mitarbeitenden, was nach jeder Kennzeichnung geschieht: Wird eine Mitteilung versendet, ein Fall einem Team zugewiesen, eine Priorität ausgelöst oder ein Dokument archiviert? Halte die Folgen praktisch fest, etwa als Nacharbeit, Verzögerung, Nichteinhaltung eines Verfahrens oder Risiko für die betroffene Person. Gehe dabei nicht davon aus, dass jeder Fehler bekannte monetäre Kosten hat.
- Umkehrbare Fehler mit geringen Auswirkungen: Eine höhere automatische Abdeckung kann angemessen sein, wenn sie sich einfach korrigieren lassen.
- Schwer erkennbare oder schwer zu korrigierende Fehler: Sie erfordern vorsichtigere Schwellenwerte und zusätzliche Kontrollen.
- Kategorien mit erheblichen Folgen: Je nach Prozessrichtlinie kann eine menschliche Prüfung auch bei hohen Werten erforderlich sein.
Das Ergebnis ist eine Richtlinie je Klasse: Sie legt fest, welche Fehler toleriert werden, welche eine Prüfung erfordern und welche die Automatisierung stoppen oder eine Weiterleitung auslösen müssen.
Die Ausgabe in Annehmen, Prüfen und Ablehnen aufteilen
Definiere zwei Schwellenwerte statt nur eines. Oberhalb des oberen Schwellenwerts kann das System die automatische Annahme vorschlagen. Liegt ein Fall zwischen den beiden Schwellenwerten, wird er geprüft. Unterhalb des unteren Schwellenwerts wird die automatische Vorhersage abgelehnt oder der Fall an einen alternativen Weg weitergeleitet. „Ablehnen“ bedeutet in diesem Zusammenhang, die Klassifizierung nicht als endgültige Entscheidung zu verwenden – nicht, den Antrag der betreffenden Person abzuweisen.
Die Schwellenwerte müssen nicht für alle Klassen gleich sein. Wenn die Verwechslung zweier Kategorien unterschiedliche Folgen hat, können unterschiedliche Schwellenwerte oder besondere Regeln für diese Verwechslungen nötig sein. Zusätzlich kann eine Bedingung gelten, etwa dass die wahrscheinlichste Kategorie die zweitwahrscheinlichste um einen Mindestabstand übertreffen muss. Ein solcher Abstand kann helfen, mehrdeutige Ergebnisse zu erkennen, sollte aber anhand von Daten aus dem eigenen Arbeitsablauf bewertet werden.
Dokumentiere jeden Weg eindeutig: Wer darf ein Ergebnis korrigieren, was geschieht, wenn das System keine Antwort liefert, und wie wird die endgültige Entscheidung festgehalten? Für Ergebnisse mit geringem Vertrauen muss ein festgelegtes betriebliches Vorgehen existieren. Andernfalls wird das Team für jeden Fall eigene Ausnahmen erfinden.
Mit repräsentativen und überprüften Beispielen kalibrieren
Stelle Beispiele zusammen, die den tatsächlichen Einsatz abbilden: häufige und seltene Kategorien, kurze und lange Texte, unterschiedliche Formate, mehrdeutige Fälle und absehbare Eingabefehler. Berücksichtige Stichproben aus den Kanälen und Gruppen, die das System nutzen werden. Ein Datensatz, der nur aus einfachen Fällen besteht, kann eine bessere Leistung vortäuschen, als später im Betrieb erreicht wird.
Halte für jedes Beispiel die korrekte Kennzeichnung anhand eines vereinbarten Kriteriums fest und lege fest, wie Meinungsverschiedenheiten geklärt werden. Trenne die Daten, mit denen die Richtlinie angepasst wird, von den Daten, die für ihre Überprüfung zurückgehalten werden. Miss für jeden möglichen Schwellenwert mindestens, wie viele Fälle automatisch angenommen würden, welcher Anteil dieser Fälle je Klasse korrekt ist und wie viele Fälle zur Prüfung weitergeleitet würden. Bewerte zusätzlich die Fehler nach ihren betrieblichen Auswirkungen.
- Lege gemeinsam mit den Prozessverantwortlichen die Klassen und die Folgen der jeweiligen Fehler fest.
- Erstelle eine repräsentative Stichprobe, überprüfe ihre Kennzeichnungen und kläre Meinungsverschiedenheiten.
- Teste mehrere Schwellenwerte und berechne Präzision, automatische Abdeckung und Prüfaufwand je Klasse.
- Wähle eine Richtlinie, die die Anforderungen an Risiko und Betriebskapazität erfüllt – nicht nur eine zusammengefasste Kennzahl.
- Überprüfe die Entscheidung anhand separater Daten, bevor du sie im Betrieb einsetzt.
Das KI-Risikomanagement-Framework des NIST bietet eine Orientierung, um die Identifizierung, Bewertung und Steuerung von Risiken zu strukturieren. Es liefert keinen universellen Schwellenwert zum Übernehmen: Die Entscheidung muss zum Kontext, zu den Daten und zu den Auswirkungen des konkreten Systems passen.
Die menschliche Prüfung als Teil des Produkts gestalten
Die Prüfung ist keine technische Ausnahme, die sich damit erledigt, Fälle in einen Posteingang zu verschieben. Lege fest, wer prüft, welche Informationen benötigt werden, wie viel Zeit dafür zur Verfügung steht und welche Maßnahmen möglich sind. Zeige die vorgeschlagene Kategorie und den relevanten Kontext an. Zugleich muss es möglich sein, die Kategorie zu korrigieren, Informationen anzufordern oder den Fall bei Bedarf weiterzuleiten.
Erfasse die endgültige Kennzeichnung und, wenn möglich, den Grund für eine Korrektur. Diese Daten helfen, wiederkehrende Verwechslungen zu erkennen und Verbesserungen vorzubereiten. Sie sollten jedoch nicht ohne Qualitätskontrollen automatisch in das Training einfließen. Wenn sich Prüfende nicht auf gemeinsame Kriterien stützen, können ihre Entscheidungen zusätzliches Rauschen erzeugen, statt es zu verringern.
Behalte auch den Arbeitsaufwand im Blick: Eine sehr hohe Prüfquote kann die Automatisierung zum Engpass machen. Übersteigt das Volumen die vorgesehene Kapazität, priorisiere nach Auswirkungen, Dringlichkeit oder Alter des Falls und prüfe, ob sich Modell, Kategorien oder Schwellenwerte ändern müssen. Lockere die Schwellenwerte nicht spontan, nur um den Rückstau abzubauen.
Die Entscheidungsrichtlinie überwachen und überprüfen
Miss die Ergebnisse je Klasse und nach relevanten Segmenten des Prozesses. Verfolge mindestens die Präzision der automatisch angenommenen Fälle, die Prüfquote, den Anteil der Ablehnungen oder Weiterleitungen, relevante Fehler und die Bearbeitungszeit. Eine globale Kennzahl kann verbergen, dass eine kleinere Kategorie systematisch fehlerhaft bearbeitet wird.
Vergleiche die Vorhersagen mit überprüften Ergebnissen und lege eine Prüfhäufigkeit fest, die dem Risiko und dem Volumen entspricht. Bewerte die Richtlinie neu, wenn sich Kategorien, Formulare, Kanäle, das Modell oder betriebliche Regeln ändern. Untersuche auch Anzeichen wie häufigere menschliche Korrekturen, eine veränderte Verteilung der Klassen oder mehr Fälle außerhalb bekannter Muster. Solche Beobachtungen sind Hinweise, die analysiert werden sollten – kein automatischer Beweis dafür, dass sich das Modell verschlechtert hat.
Bewahre Versionen der Schwellenwerte, die zu ihrer Freigabe verwendeten Nachweise und das Datum der Überprüfung auf. Auch Datenmanagement und Datenqualität sind wichtig: Uneinheitliche Definitionen oder veraltete Kennzeichnungen schwächen jede Kalibrierung. Das Wissensangebot von DAMA International kann als allgemeine Orientierung für die Strukturierung von Datenmanagementpraktiken dienen.
Checkliste für die Einführung
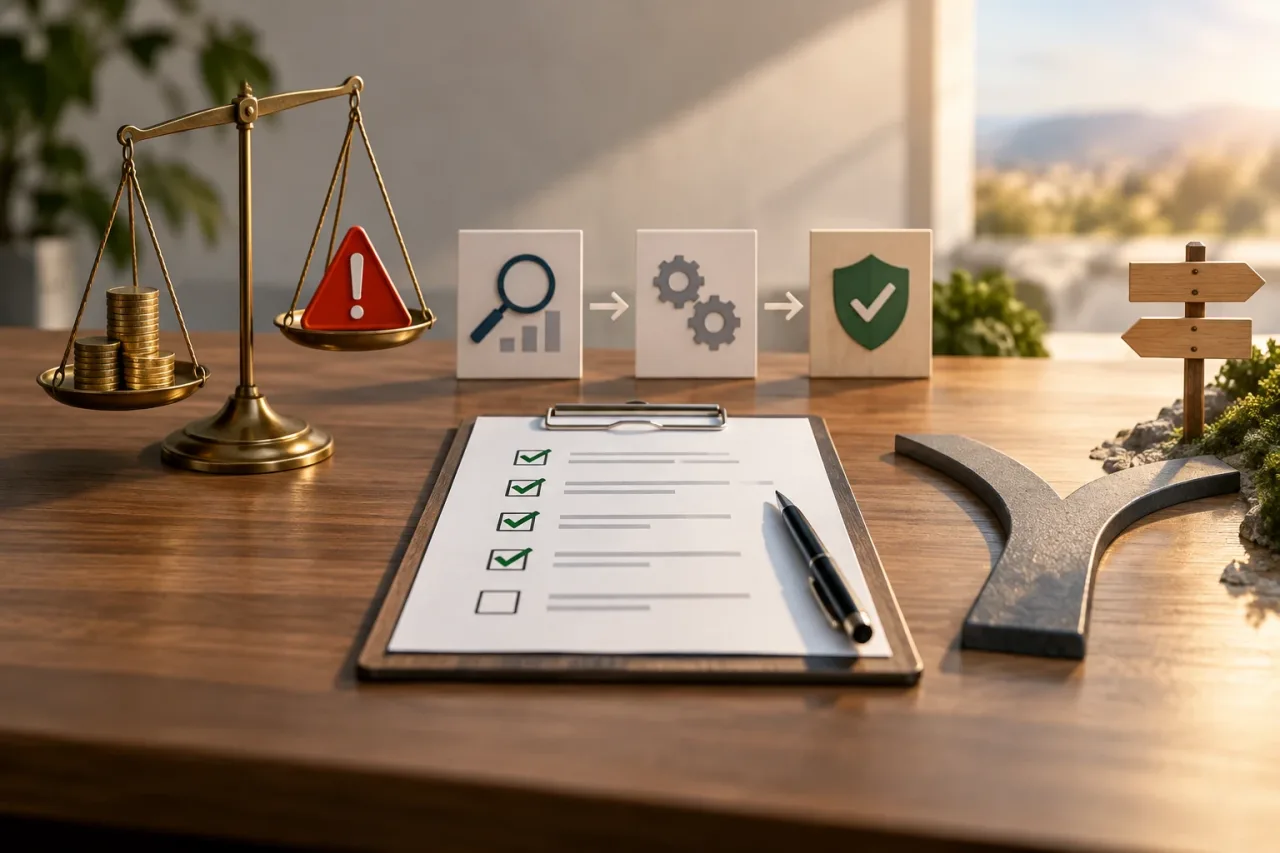
- Hat jede Kategorie eine operative Definition und gibt es Beispiele für Grenzfälle?
- Wurden falsch positive und falsch negative Ergebnisse anhand ihrer Folgen verglichen?
- Unterscheiden die Schwellenwerte zwischen Annahme, Prüfung und Weiterleitung, und können sie je Klasse variieren?
- Beruht die Bewertung auf repräsentativen Daten und überprüften Kennzeichnungen?
- Gibt es genügend Prüfkapazität, klare Anweisungen und einen Eskalationsweg?
- Werden Fehler, Abdeckung und Prüfaufwand je Klasse gemessen?
- Sind Verantwortliche, Aufzeichnungen und klare Bedingungen für eine erneute Bewertung der Richtlinie festgelegt?
Zusammengefasst bedeutet das Festlegen von Vertrauensschwellen, eine Entscheidungsrichtlinie zu gestalten – nicht eine einzelne Zahl auszuwählen. Beginne mit den Fehlerkosten, überprüfe die Schwellenwerte anhand realer Fälle und halte für unsichere Ergebnisse einen sicheren Weg bereit. So kann die Automatisierung wachsen, ohne einen Modellwert mit einer verlässlichen Entscheidung gleichzusetzen.