

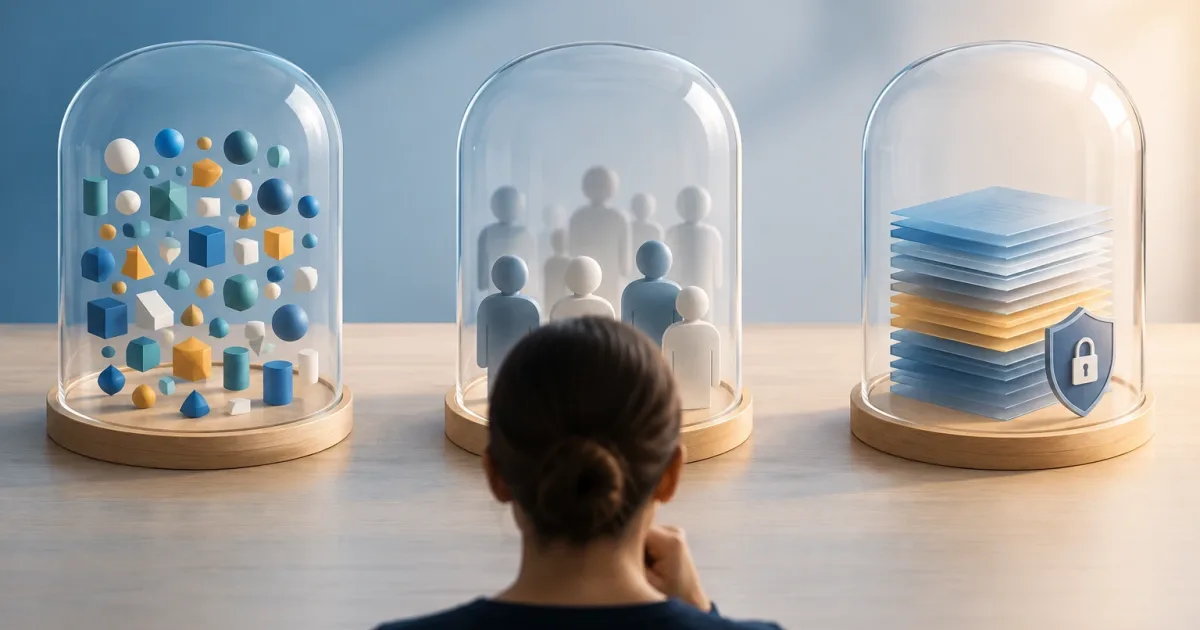
Testdaten beeinflussen sowohl die Softwarequalität als auch das Risiko, sensible Informationen offenzulegen. Ein zu einfacher Datensatz kann Fehler verbergen; eine unkontrollierte Produktionskopie kann personenbezogene oder geschäftliche Daten preisgeben. Die Entscheidung besteht nicht nur darin, zwischen echten und fiktiven Daten zu wählen: Realitätsnähe, Sensibilität, Pflegeaufwand und Zweck der jeweiligen Umgebung müssen gegeneinander abgewogen werden.
Dieser Leitfaden vergleicht drei Ansätze – synthetische Daten, anonymisierte Daten und kontrollierte Kopien – und zeigt praktische Kriterien für Entwicklung, Tests und Demonstrationen auf. Die passende Option kann sich je nach Team und sogar zwischen verschiedenen Tests innerhalb desselben Produkts unterscheiden.
Warum Daten Qualität und Risiko beeinflussen
Eine Anwendung verhält sich entsprechend den Daten, die sie verarbeitet. Datenmengen, Kombinationen, fehlende Werte, Duplikate und Beziehungen zwischen Datensätzen können Abläufe auslösen, die mit einfachen Beispielen nicht geprüft werden. Decken Tests nur den Idealfall ab, bleiben möglicherweise Fehler bei Validierungen, Berechnungen, Berechtigungen, Integrationen oder Migrationen unentdeckt.
Gleichzeitig gibt es in Nicht-Produktivumgebungen oft mehr zugriffsberechtigte Personen, Debugging-Werkzeuge und weniger strenge Lebenszyklen als in der Produktion. Identifizierbare Informationen aus Bequemlichkeit zu übernehmen, vergrößert die Folgen eines kompromittierten Kontos, eines versehentlichen Exports oder einer vergessenen Umgebung. Ziel ist es, die für Tests erforderlichen Eigenschaften zu bewahren, nicht mehr Informationen als nötig zu kopieren.
Legen Sie vor der Wahl einer Methode fest, was geprüft werden soll: eine Geschäftsregel, eine Migration, die Leistung, die Nutzererfahrung oder eine Demonstration. Ohne einen klaren Zweck bleibt „realistische Daten“ eine ungenaue Anforderung und kann dazu führen, dass Details gesammelt werden, die keinen Mehrwert bieten.
Drei Ansätze mit unterschiedlicher Datentreue
Synthetische Daten
Diese Daten werden anhand von Regeln, Vorlagen oder internen Werkzeugen von Grund auf erzeugt. Sie können fiktive Namen, Datumsangaben, Statuswerte und schlüssige Beziehungen enthalten sowie gezielt entworfene Grenzfälle. Da sie nicht auf echten Datensätzen beruhen, werden Produktionsdaten nicht unmittelbar übertragen. Automatisch sicher sind sie dennoch nicht, wenn sie echte Werte, Geheimnisse oder kopierte Beispiele enthalten.
Synthetische Daten eignen sich für Entwicklung, automatisierte Tests, Schulungen und Demonstrationen, wenn sich Struktur und erwartetes Verhalten beschreiben lassen. Der größte Aufwand besteht darin, Generatoren zu entwickeln und zu pflegen, die Geschäftsregeln, Verteilungen und relevante Kombinationen abbilden. Ein zu regelmäßiger synthetischer Datensatz deckt Probleme durch unregelmäßige historische Daten möglicherweise nicht auf.
Anonymisierte Daten
Diese Daten entstehen, indem Ausgangsdaten so verändert werden, dass Personen nicht identifiziert werden können. Das Ergebnis kann für bestimmte Tests nützliche Muster bewahren. Das Risiko hängt jedoch vom Kontext, den beibehaltenen Feldern und der Möglichkeit ab, die Informationen mit anderen Quellen zu kombinieren. Namen oder E-Mail-Adressen zu ersetzen, reicht nicht unbedingt aus: Auch Datumsangaben, Orte, indirekte Kennungen und seltene Beziehungen können Identitäten offenlegen.
Bei diesem Ansatz muss das Ergebnis überprüft werden; die Transformation allein genügt nicht. Benötigt ein Test lediglich aggregierte Trends, kann es sinnvoll sein, den Detailgrad zu verringern. Sind Beziehungen zwischen Datensätzen erforderlich, sollte die Transformation diese schlüssig erhalten, ohne unnötige Kennungen beizubehalten. Anonymisierung ist keine automatische Garantie dafür, dass jede spätere Nutzung unbedenklich ist.
Kontrollierte Produktionskopien
Eine kontrollierte Kopie enthält eine ausgewählte Teilmenge echter Daten oder eine veränderte und eingeschränkte Version davon. Sie kann nützlich sein, um schwer reproduzierbare Vorfälle zu untersuchen, komplexe Migrationen zu prüfen oder das Verhalten anhand authentischer Verteilungen zu bewerten. Gleichzeitig birgt sie Risiken: Sie kann sensible Informationen und operative Geheimnisse enthalten und schnell veralten.
Nutzen Sie diesen Ansatz nur, wenn Alternativen nicht die erforderliche Realitätsnähe bieten. Legen Sie fest, welche Felder extrahiert werden, wer die Aufbereitung genehmigt, wo die Daten gespeichert werden, wer Zugriff erhält und wann sie gelöscht werden. Eine Kopie sollte nicht allein deshalb zum Standard werden, weil sie am bequemsten ist.
Auswahl nach Testzweck und Risiko
Nutzen Sie die folgenden Kriterien, um eine bewusste Entscheidung zu treffen:
- Entwicklung und Unit-Tests: Bevorzugen Sie kleine, vorhersehbare und leicht zurücksetzbare synthetische Datensätze. Sie sollten gültige und ungültige Werte sowie Grenzfälle der Regeln abdecken.
- Integrationstests: Kombinieren Sie synthetische Daten, die mit den Schnittstellen der verbundenen Systeme übereinstimmen. Erfordert eine Abhängigkeit historische Realitätsnähe, prüfen Sie einen transformierten und begrenzten Auszug.
- Last- und Leistungstests: Bilden Sie das erforderliche Volumen, die Verteilung und die Beziehungen nach. Setzen Sie nicht voraus, dass echte Identitäten nötig sind; prüfen Sie, ob sich dasselbe Betriebsprofil synthetisch erzeugen lässt.
- Untersuchung von Vorfällen: Versuchen Sie zunächst, den Fehler mit synthetischen Daten zu reproduzieren. Reicht das nicht aus, verwenden Sie eine kontrollierte Kopie mit festgelegtem Umfang, Zugriff und Ablaufdatum.
- Demonstrationen: In der Regel eignen sich gezielt zusammengestellte synthetische Daten. Vermeiden Sie, dass eine öffentliche oder geteilte Demo echte Datensätze, Kommentare oder Anhänge übernimmt.
Auch die Sensibilität ist entscheidend. Je sensibler die Informationen und je breiter der Zugriff, desto stärker sollten synthetische Daten oder eine Transformation bevorzugt werden, die unnötige Details entfernt. Die Entscheidung sollte dokumentieren, warum zusätzliche Realitätsnähe den Aufwand und das Risiko rechtfertigt.
Repräsentativität, Grenzfälle und Reidentifizierung
Repräsentativität bedeutet nicht, jeden Datensatz nachzubilden. Entscheidend ist, die Eigenschaften zu bewahren, die für den Test relevant sind. Bestimmen Sie Dimensionen wie die Häufigkeit von Statuswerten, Größenverteilungen, Beziehungen zwischen Entitäten, Alter und fehlende Werte. Vergleichen Sie anschließend den Testdatensatz anhand dieser Dimensionen, ohne ungenutzte Felder aufzunehmen.
Berücksichtigen Sie seltene Fälle, die Annahmen verletzen können: doppelte Datensätze, unvollständige Abläufe, unerwartete Formate, Zeitzonen oder ungewöhnliche Statusübergänge. Mit synthetischen Daten lassen sich solche Fälle gezielt erzeugen; eine Produktionsstichprobe enthält sie möglicherweise nicht.
Um das Risiko einer Reidentifizierung einzuschätzen, sollten Sie prüfen, welche Rückschlüsse sich ziehen lassen, wenn die beibehaltenen Felder mit Informationen aus anderen Quellen kombiniert werden. Überprüfen Sie direkte und indirekte Kennungen, seltene Werte und Verknüpfungen zwischen Tabellen. Können Sie die Notwendigkeit eines Attributs nicht begründen, entfernen oder verallgemeinern Sie es und prüfen Sie erneut, ob der Testfall weiterhin nützlich ist.
Kontrollen für den Lebenszyklus des Datensatzes
Der Schutz endet nicht mit der Erstellung des Datensatzes. Legen Sie einfache und überprüfbare Kontrollen für Vorbereitung und Verwendung fest:
- Inventarisieren: Erfassen Sie Datensätze, Zweck, Herkunft, Felder und die jeweilige Einsatzumgebung.
- Begrenzen: Extrahieren Sie nur die erforderlichen Datensätze und Attribute. Trennen Sie Testdaten von Anmeldedaten, Tokens und operativen Geheimnissen.
- Zugriff beschränken: Vergeben Sie Berechtigungen nach dem tatsächlichen Arbeitsbedarf und prüfen Sie, wer die Daten herunterladen, kopieren oder exportieren kann.
- Aktualisierungen kontrollieren: Dokumentieren Sie, wie jede Version erstellt wird, wer sie pflegt und welche Schema- oder Regeländerungen eine Neuerstellung erfordern.
- Ablauf festlegen: Bestimmen Sie, wann der Datensatz und seine Arbeitskopien gelöscht werden, einschließlich bekannter Exporte.
- Ergebnis prüfen: Vergewissern Sie sich, dass keine echten Daten oder unerwarteten sensiblen Felder enthalten sind und die Tests die vorgesehenen Szenarien weiterhin abdecken.
Ein wiederverwendbarer Testdatensatz sollte wie jedes andere Team-Asset einen Verantwortlichen und einen klaren Zweck haben. Weiß niemand, woher er stammt oder wann er entfernt werden muss, sollte er als operativer Rückstand behandelt und sein Verbleib geklärt werden, bevor er weiterverbreitet wird.
Häufige Fehler und Checkliste
Zwei Extreme führen häufig zu Problemen. Erstens werden aus Bequemlichkeit echte Daten verwendet: Das spart anfangs Vorbereitungsaufwand, vervielfacht jedoch die Kopien und erschwert die Kontrolle von Zugriff und Löschung. Zweitens kommen künstliche, übermäßig saubere Daten zum Einsatz: Das verringert zwar die Offenlegung, vermittelt aber falsche Sicherheit, wenn relevante Formate, Beziehungen und Grenzfälle fehlen. Die Lösung ist nicht, sich grundsätzlich für Realitätsnähe oder Sicherheit zu entscheiden, sondern den Datensatz auf die zu beantwortende Frage abzustimmen.
Prüfen Sie vor der Freigabe von Daten für eine Nicht-Produktivumgebung:
- Ist das Testziel festgelegt, und ist klar, welche Dateneigenschaften dafür benötigt werden?
- Lässt sich das Ziel mit synthetischen Daten erreichen? Wenn nicht: Welche Eigenschaft für mehr Realitätsnähe fehlt?
- Wurden Felder, Datensätze und Beziehungen auf das unbedingt erforderliche Maß reduziert?
- Wurden seltene Werte und Kombinationen geprüft, die eine Reidentifizierung erleichtern könnten?
- Sind Zugriff, Speicherort, Aktualisierung, Verantwortlichkeit und Löschdatum festgelegt?
- Deckt der Datensatz Grenzfälle ab und lässt er sich bei Änderungen am Produkt oder Schema erneut erzeugen?
Die fundierteste Entscheidung verbindet jede Datenart mit einem konkreten Testbedarf und einer konkreten Kontrolle. Beginnen Sie mit synthetischen Daten und greifen Sie nur dann auf eine Transformation oder kontrollierte Kopie zurück, wenn eine nachweisbare Lücke bei der Datentreue besteht. Überprüfen Sie die Wahl erneut, wenn sich Zweck, Daten oder Zugriffsrechte ändern.