

Eine Automatisierung kann in isolierten Tests zutreffende Ergebnisse liefern und dennoch scheitern, sobald sie auf die tatsächliche Variabilität eines Betriebs trifft. Der Schattenmodus verringert dieses Risiko: Das System erhält dieselben Daten wie der aktive Prozess, berechnet eine Empfehlung oder Entscheidung, führt jedoch keine Handlung aus, die sich auf Kunden, Bestellungen, Konten oder operative Datensätze auswirkt.
Seine Aufgabe besteht nicht darin, mit einer allgemeinen Trefferquote zu belegen, dass die Automatisierung „funktioniert“. Er soll prüfen, ob sie unter den konkreten Bedingungen und mit den konkreten Folgen des zu verändernden Prozesses ausreichend gute Entscheidungen trifft. Das gilt für die Klassifizierung von Anfragen, die Priorisierung von Vorfällen, die Erkennung von Anomalien, die Dokumentenprüfung, die Weiterleitung von Fällen oder Empfehlungen für Service- und Betriebsteams.
Das nützliche Ergebnis eines Schattentests ist nicht nur ein Prozentsatz übereinstimmender Entscheidungen. Es ist eine fundierte betriebliche Entscheidung: mit Grenzen aktivieren, den Test ausweiten, Daten oder Regeln korrigieren, menschliche Aufsicht beibehalten oder den Anwendungsfall verwerfen.
Was der Schattenmodus ist und welches Problem er löst
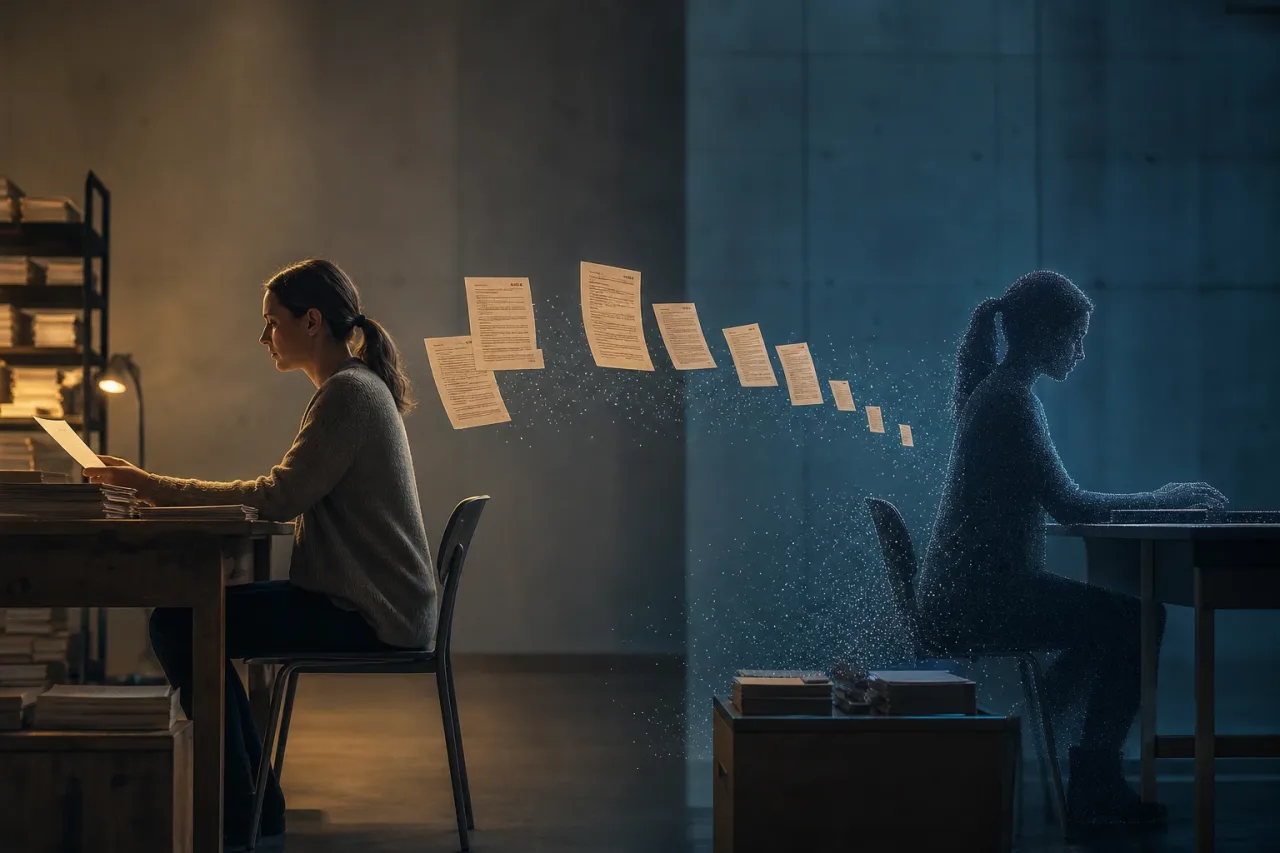
Im Schattenmodus verarbeitet die Automatisierung reale Ereignisse parallel zum bestehenden Ablauf. Das Team arbeitet weiterhin mit der aktuellen Entscheidung, die häufig von Menschen getroffen wird oder auf bereits genehmigten Regeln basiert. Die automatische Ausgabe wird getrennt protokolliert und später verglichen, ohne das tatsächliche Ergebnis verändern zu können.
Ein System kann beispielsweise für jede eingehende Anfrage eine Priorität vorschlagen, während das Betriebsteam die wirksame Zuordnung beibehält. Nach einem festgelegten Zeitraum wird analysiert, wo beide Entscheidungen übereinstimmen, wo sie voneinander abweichen und vor allem, was geschehen wäre, wenn der automatischen Empfehlung gefolgt worden wäre.
Die Trennung zwischen Empfehlen und Handeln muss technisch umgesetzt und überprüfbar sein. Es reicht nicht aus zu erklären, das System sei „nicht verbunden“. Die Integration muss ausdrücklich verhindern, dass die Ausgabe im Schattenmodus Nachrichten versendet, Status aktualisiert, Aufgaben erstellt, Bestände verändert oder Zahlungen auslöst. Ein versehentlicher Schreibzugriff verwandelt eine Validierung in eine unkontrollierte Einführung.
Dieser Ansatz entspricht dem Risikomanagement: den Nutzungskontext bestimmen, relevante Ergebnisse messen und Kontrollen festlegen, bevor eine automatisierte Entscheidung ausgeweitet wird. Das AI Risk Management Framework von NIST bietet einen hilfreichen Rahmen, um diese Praktiken zu strukturieren. Für Datenqualität, Herkunft und Definitionen helfen die Grundsätze von DAMA International dabei, zu vermeiden, dass ein Vergleich schlüssig wirkt, obwohl die Referenz uneinheitlich ist.
Wann der Einsatz sinnvoll ist – und wann er nicht ausreicht
Der Schattenmodus ist besonders wertvoll, wenn eine wiederholbare Entscheidung und eine angemessene betriebliche Referenz für den Vergleich vorhanden sind. Er setzt nicht voraus, dass Menschen fehlerfrei entscheiden. Der aktuelle Prozess muss jedoch genügend Nachvollziehbarkeit bieten, um zu verstehen, was entschieden wurde und warum.
- Geeignete Fälle: Ticketklassifizierung, Priorisierung von Warteschlangen, Zuweisung an Teams, Erkennung von Duplikaten, Prüfungen der Berechtigung sowie Vorschläge für Antworten oder nächste Schritte.
- Günstige Voraussetzungen: strukturierte oder zugängliche Eingaben, ein beobachtbares Ergebnis, ausreichendes Volumen, ein Verlauf früherer Entscheidungen und die Möglichkeit, die Automatisierung zu stoppen, ohne die Betriebskontinuität zu beeinträchtigen.
- Angemessene Auswirkungen: Fehler sind korrigierbar, oder Entscheidungen können zunächst als von Menschen geprüfte Empfehlung eingeführt werden.
Ein Schattentest beseitigt jedoch nicht alle Risiken. Er reicht nicht aus, wenn die tatsächliche Entscheidung von Informationen abhängt, die das System nicht erhält, wenn kein stabiler menschlicher Maßstab existiert oder wenn Fälle zwischen Bearbeitenden so unterschiedlich gelöst werden, dass keine eindeutige „Wahrheit“ definiert ist.
Besondere Vorsicht ist auch bei irreversiblen oder folgenreichen Entscheidungen erforderlich. Wenn Rechte, der Zugang zu Leistungen, Sicherheit, Zahlungen oder vertragliche Verpflichtungen betroffen sind, belegt historische Übereinstimmung allein nicht, dass eine Automatisierung vertretbar ist. Dann sind zusätzliche Kontrollen, fachliche Prüfung und strengere Nutzungsgrenzen erforderlich.
Den Entscheidungsfall vor dem Vergleich definieren
Ein Test scheitert häufig, weil eine zu weit gefasste Automatisierung bewertet werden soll: etwa „Anfragen bearbeiten“ oder „Priorisierung verbessern“. Wandeln Sie dieses Ziel in eine konkrete Entscheidungseinheit um. Jeder verglichene Datensatz muss dieselbe Frage mit demselben zeitlichen Horizont beantworten.
- Eingabe: Welche Daten zum Zeitpunkt der Entscheidung verfügbar waren und welche ausgeschlossen bleiben.
- Ausgabe: Kategorie, Priorität, Weiterleitung, Prüfung oder Empfehlung, die das System erzeugt.
- Tatsächliche Referenz: Wer die gültige Entscheidung getroffen hat, wann sie getroffen wurde und wo sie dokumentiert ist.
- Folge: Welcher Schaden durch einen falsch positiven oder falsch negativen Befund, eine Verzögerung oder eine fehlerhafte Weiterleitung entsteht.
- Frist: Wie lange die Entscheidung dauern darf, bevor sie ihren betrieblichen Wert verliert.
- Verantwortung: Wer Ergebnisse prüft, Meinungsverschiedenheiten klärt und Änderungen freigibt.
Bewahren Sie eine Momentaufnahme der Eingabedaten, die Version der Regeln oder des Modells, einen Zeitstempel und die Fallkennung auf. Ohne diese Elemente lässt sich eine Abweichung weder reproduzieren noch feststellen, ob eine Veränderung vom System, einer Datenaktualisierung oder einer Änderung im menschlichen Prozess stammt.
Eine zentrale Regel lautet, Informationslecks zu vermeiden. Die Automatisierung darf nur Daten verwenden, die vor der tatsächlichen Entscheidung verfügbar waren. Bezieht sie ein Feld ein, das erst nach der Falllösung ausgefüllt wird, fällt die Bewertung künstlich gut aus und bildet die Leistung im Produktivbetrieb nicht ab.
Eine parallele Ausführung gestalten, die den Betrieb nicht verändert
Das technische Design sollte Isolation und Prüfbarkeit fördern. Der Schattenablauf kann eine Kopie der Ereignisse verarbeiten oder Informationen aus einer kontrollierten Quelle lesen, doch seine Ergebnisse müssen in ein vom Transaktionssystem getrenntes Ziel geschrieben werden.
betriebliches Ereignis → bestehender Prozess → tatsächliche Aktion
betriebliches Ereignis → Automatisierung im Schattenmodus → Bewertungsprotokoll
Prüfen Sie vor dem Start einfache, aber entscheidende Sicherheitsbedingungen: Anmeldedaten ohne Schreibrechte, soweit möglich, getrennte Warteschlangen oder Tabellen, deutlich sichtbare Kennzeichnungen für Bewertungsdatensätze sowie Warnungen bei jedem Versuch einer externen Aktion. Benötigt eine Integration Zugriff auf Produktivsysteme, wenden Sie das Prinzip der minimalen Rechte an und prüfen Sie, welche Felder sie erhält und speichert.
Der Vergleich muss denselben Fall in beiden Abläufen verknüpfen. Definieren Sie eine stabile Kennung und eine Regel dafür, wann eine menschliche Lösung als endgültig gilt. Wenn das Team eine Anfrage mehrfach neu klassifiziert, kann die ausschließliche Erfassung des letzten Status relevante Verzögerungen oder Korrekturen verdecken. Halten Sie mindestens die ursprüngliche Empfehlung, die ursprüngliche tatsächliche Entscheidung und den Ausgang des Falls fest.
Was gemessen werden sollte und wie Abweichungen untersucht werden
Übereinstimmung ist eine erste Kennzahl, kein Urteil. Zwei Entscheidungen können in einer Kategorie übereinstimmen und sich dennoch wesentlich bei Dringlichkeit, Zuständigkeit oder Frist unterscheiden. Umgekehrt kann eine Abweichung einen automatischen Fehler aufdecken, aber ebenso eine mehrdeutige menschliche Regel oder fehlende Daten.
Strukturieren Sie die Analyse anhand von Kennzahlen, die reale Risiken abbilden:
- Gewichtete Übereinstimmung: Eine Differenz zwischen zwei ähnlichen Prioritäten ist nicht mit dem Übersehen eines kritischen Falls gleichzusetzen.
- Qualität des Ergebnisses: Prüfen Sie, sofern anwendbar, Wiedereröffnungen, Eskalationen, Fristüberschreitungen, Korrekturen und Nacharbeit.
- Entscheidungszeit: Messen Sie, ob der Vorschlag innerhalb des nutzbaren Zeitfensters eintrifft, nicht nur, ob er letztlich zutrifft.
- Abdeckung: Ermitteln Sie, welchen Anteil der Fälle das System verarbeitet und welche es ablehnt oder ohne Empfehlung lässt.
- Ausnahmen: Gruppieren Sie Ergebnisse nach Kanal, Anfrageart, Zeitraum, unvollständigen Daten und weiteren relevanten betrieblichen Segmenten.
Untersuchen Sie Abweichungen mit einer qualitativen Stichprobe und priorisieren Sie Fälle mit den größten Auswirkungen. Ordnen Sie sie handlungsorientierten Kategorien zu: Datenfehler, nicht ausdrücklich formulierte Geschäftsregel, fehlende Eingabeinformation, inkonsistente menschliche Entscheidung, Systemfehler oder berechtigte Prozessvariation. Korrigieren Sie das System nicht, um jede menschliche Entscheidung nachzuahmen. War eine tatsächliche Entscheidung mangelhaft oder widersprüchlich, würde sie als Zielwert lediglich institutionalisiert.
Die Stichprobe sollte sowohl häufige Fälle als auch Randfälle umfassen: Nachfragespitzen, Schichtwechsel, unvollständige Eingaben, Duplikate, dringende Fälle und Zeiträume mit Richtlinienänderungen. Ein Test, der nur auf Durchschnittswerten basiert, kann genau die Fehler verdecken, die die höchsten Kosten oder Risiken verursachen.
Praktische Kriterien für Aktivierung, Ausweitung oder Neugestaltung
Definieren Sie die Austrittskriterien, bevor Sie die Ergebnisse betrachten. So verhindern Sie, dass der Schwellenwert am Ende gesenkt wird, um eine bereits getätigte Investition zu rechtfertigen. Die Schwellenwerte sollten sich am Fehleraufwand, an der Aufsichtskapazität und am anfänglichen Umfang orientieren, nicht an einer universellen Zahl.
Stellen Sie sich eine Automatisierung vor, die Anfragen priorisiert. Sie kann zunächst als sichtbare Empfehlung aktiviert werden, wenn sie bei kritischen Fällen eine akzeptable Qualität wahrt, den regulären Ablauf abdeckt und das Team sie problemlos übersteuern kann. Sie kann zu einer automatischen Entscheidung nur für Anfragen mit niedriger Kritikalität ausgeweitet werden, während bei Dringlichkeit oder unvollständigen Daten die menschliche Prüfung bestehen bleibt.
- Mit Grenzen aktivieren, wenn schwerwiegende Abweichungen selten, erklärbar und kontrollierbar sind sowie Warnungen und ein klarer Rückweg bestehen.
- Den Test ausweiten, wenn repräsentative Zeiträume, Segmente oder Ausnahmen fehlen, auch wenn das erste Ergebnis vielversprechend ist.
- Korrigieren und wiederholen, wenn Probleme der Datenqualität, mehrdeutige Definitionen oder Regeln überwiegen, die der Prozess noch nicht formalisiert hat.
- Menschliche Aufsicht beibehalten, wenn die Automatisierung Geschwindigkeit oder Konsistenz bietet, das Risiko bestimmter Ausnahmen jedoch weiterhin Fachwissen erfordert.
- Verwerfen oder neu gestalten, wenn es keine verlässliche Referenz gibt, der Fehleraufwand den erwartbaren Nutzen übersteigt oder der Prozess vor der Automatisierung vereinfacht werden muss.
Der Schattenmodus schafft Wert, wenn er als Entscheidungspraxis und nicht als technische Demonstration behandelt wird. Isolieren Sie die Aktionen, vergleichen Sie mit relevanten betrieblichen Ergebnissen, untersuchen Sie Unterschiede und begrenzen Sie die Einführung anhand der Evidenz. So gelangt die Automatisierung mit ausdrücklichen Kontrollen in den Produktivbetrieb – und mit einem realistischen Verständnis dafür, wo sie hilft, wo sie Aufsicht benötigt und wo sie nicht entscheiden sollte.