

Die Verbindung eines CRM, eines ERP, eines E-Commerce-Systems und eigener Anwendungen wirft eine scheinbar einfache Frage auf: Woher wissen wir, dass zwei Datensätze dieselbe Entität darstellen? Die Antwort kann nicht standardmäßig auf einem Namen, einer E-Mail-Adresse oder einer sichtbaren Referenz beruhen. Diese Werte ändern sich, können mehrfach vorkommen und folgen in jedem System häufig anderen Regeln.
Eine schlechte Entscheidung zu Identifikatoren führt zu Duplikaten, Aktualisierungen am falschen Datensatz, Bestellungen ohne zugeordneten Kunden und manuellen Abstimmungen, die zum Dauerzustand werden. Eine fundierte Entscheidung besteht nicht darin, einen magischen universellen Identifikator zu finden, sondern darin, festzulegen, welches System welche Entität anhand welchen Schlüssels, wie lange und unter welchen Änderungsregeln erkennt.
Dieser Rahmen hilft bei der Wahl zwischen internen IDs, Geschäftsreferenzen, externen IDs und Zuordnungstabellen, ohne unnötige Informationen offenzulegen oder Systeme fragil aneinanderzukoppeln.
Warum sichtbare Felder die Identität nicht bestimmen
Der Name eines Unternehmens kann unterschiedlich geschrieben werden, sich nach einer Fusion ändern oder von verschiedenen Organisationen verwendet werden. Bei Personennamen gibt es noch mehr Kollisionen. Eine E-Mail-Adresse kann sich ändern, wiederverwendet werden, zu einem gemeinsamen Konto gehören oder in bestimmten Abläufen fehlen. Selbst eine Geschäftsreferenz kann nur innerhalb einer Tochtergesellschaft, eines Kanals oder eines Zeitraums eindeutig sein.
Diese Felder bleiben nützlich für die Suche, Anzeige und das Vorschlagen von Treffern, sollten jedoch nur selten als technischer Schlüssel einer Integration dienen. Entscheidend ist folgende Unterscheidung:
- Identität: der konkrete Datensatz, den ein System als Entität betrachtet.
- Attribute: Daten, welche diese Entität beschreiben, etwa Name, E-Mail-Adresse, Telefonnummer oder Anschrift.
- Geschäftsreferenz: ein operativ bedeutungsvoller Code, beispielsweise eine Bestellnummer oder Kundennummer.
Die Verwechslung dieser Ebenen ist eine häufige Fehlerquelle. So identifiziert eine Adresse nicht zwangsläufig einen Kunden: Dieselbe Person kann mehrere Adressen haben, und mehrere Personen können eine Adresse teilen. Ebenso identifiziert eine Bestellung eine Transaktion, nicht dauerhaft den Käufer.
Arten von Identifikatoren und ihr jeweiliger Zweck
Vor dem Entwurf von Nachrichten oder Endpunkten sollten die verfügbaren Schlüssel klassifiziert werden. Jede Art hat Vorteile und Grenzen.
- Interne ID: ein von einem System erzeugter und kontrollierter Schlüssel, normalerweise stabil und ohne geschäftliche Bedeutung. Sie ist die beste Option für Vorgänge innerhalb der eigenen Domäne.
- Geschäftsreferenz: ein lesbarer oder operativer Code wie eine Bestellreferenz. Er erleichtert Support und Abstimmung, kann aber sein Format ändern, je Nummernkreis zurückgesetzt oder wiederverwendet werden.
- Externe ID: ein Identifikator, den ein empfangendes System speichert, um sich an den Datensatz eines sendenden Systems zu erinnern. Er ist nützlich, wenn eine klare Herkunftsbeziehung besteht.
- Zusammengesetzter Identifikator: eine Kombination von Werten, etwa
quelle + entitätstyp + id. Er ist unverzichtbar, wenn eine ID nur innerhalb eines Systems eindeutig ist. - Temporärer Identifikator: ein Korrelationsschlüssel für einen noch nicht abgeschlossenen Prozess. Er muss ablaufen und darf nicht versehentlich zur dauerhaften Identität werden.
Eine praktische Regel besteht darin, die interne ID jeder Anwendung als lokale Autorität beizubehalten. Beim Datenaustausch ist der minimal sichere Identifikator meist ein Wert mit explizitem Namensraum. Zum Beispiel:
{
  "entity_type": "customer",
  "source_system": "ecommerce",
  "source_id": "C-48291"
}
Der Wert C-48291 allein ist nicht zwingend global eindeutig. Der Herkunftskontext verhindert, dass ein anderes System eine textuelle Übereinstimmung als gemeinsame Identität interpretiert.
Fragen, die vor dem Teilen einer ID beantwortet werden müssen
Wählen Sie keinen Schlüssel allein aus Gründen der einfachen Implementierung. Entscheiden Sie zuerst über Eigentumsmodell und Lebenszyklus. Diese Fragen zeigen, ob ein Identifikator zwischen Systemen übertragen werden kann:
- Welches System erstellt die Entität, und welches ist für jedes Attribut die maßgebliche Quelle?
- Ist der Wert in der gesamten Organisation eindeutig oder nur innerhalb einer Anwendung, eines Landes, Kanals oder Entitätstyps?
- Kann er sich ändern? Falls ja: Wird der vorherige Wert aufbewahrt und das Ereignis veröffentlicht?
- Kann er nach einer Löschung, Stornierung oder Aufbewahrungsfrist wiederverwendet werden?
- Enthält er personenbezogene Daten, sensible Geschäftsinformationen oder leicht erratbare Muster?
- Kann ein Datensatz mit einem anderen zusammengeführt oder in mehrere Datensätze aufgeteilt werden?
- Wie soll sich der Empfänger verhalten, wenn keine Zuordnung gefunden wird?
Eine geteilte ID muss stabil, in ihrem Kontext eindeutig, nicht wiederverwendbar und für den vorgesehenen Einsatz ausreichend undurchsichtig sein. Erfüllt eine Geschäftsreferenz diese Bedingungen nicht, verwenden Sie sie als überprüfbares Attribut und nicht als Aktualisierungsschlüssel.
Außerdem müssen technische Identität und Berechtigung getrennt werden. Die Kenntnis eines Identifikators darf nicht erlauben, eine Entität zu lesen oder zu ändern. APIs müssen prüfen, ob der Aufrufer zum Zugriff auf die Ressource berechtigt ist, und vorhersagbare IDs dürfen nicht der einzige Schutzmechanismus sein.
Wann die Ursprungs-ID weitergegeben werden sollte und wann eine Zuordnungstabelle nötig ist
Die Weitergabe der Ursprungs-ID ist sinnvoll, wenn eine Entität in einem eindeutig maßgeblichen System entsteht und die übrigen Systeme sie lediglich erkennen müssen. So kann das E-Commerce-System eine Bestellung anlegen und das ERP den Bestellidentifikator des E-Commerce-Systems als externe Referenz speichern. Dieses Muster reduziert Mehrdeutigkeiten und macht die Herkunft nachvollziehbar.
Allerdings haben nicht alle Domänen eine einzige Autorität. Ein Kunde kann über Vertrieb, E-Commerce, Support oder historische Importe eingehen. In diesen Fällen führt es zu Abhängigkeiten, die ID eines Systems als universellen Schlüssel durchzusetzen, und kann eine spätere Migration zu einem Hochrisikoprojekt machen.
Eine Zuordnungstabelle ist vorzuziehen, wenn es mehrere führende Systeme, eine schrittweise Konsolidierung, Datensatzfusionen oder komplexe Identitätsregeln gibt. Sie sollte mindestens Entitätstyp, System, lokale ID, kanonische ID, sofern vorhanden, Status der Verknüpfung, Erstellungsdatum sowie Belege oder Regeln enthalten, welche die Beziehung begründen.
Vermeiden Sie eine Tabelle, die lediglich zwei Spalten ohne Kontext verknüpft. Derselbe Wert kann für verschiedene Typen existieren, und eine Verknüpfung kann bestätigt, vorläufig, abgelehnt oder nach einer Fusion ersetzt sein. Behandeln Sie dieses Mapping als operative Information mit Auditierbarkeit, nicht als unsichtbare Konfiguration im Code.
Anlagen, Duplikate und Fusionen: Für die unangenehmen Fälle planen
Trifft eine Anlage ohne gemeinsamen Identifikator ein, sollte der Empfänger weder automatisch von einer neuen Entität ausgehen noch eine E-Mail-Übereinstimmung als endgültig betrachten. Er sollte eine explizite Richtlinie anwenden:
- Einen neuen Datensatz erstellen und ihn nicht verknüpft lassen, wenn die Evidenz nicht ausreicht.
- Eine Übereinstimmung vorschlagen, wenn mehrere konsistente Attribute einen fachlich definierten Schwellenwert überschreiten.
- Eine menschliche Prüfung verlangen, um Datensätze mit finanziellen, vertraglichen oder kundenbetreuungsrelevanten Folgen zusammenzuführen.
- Die Entscheidung, die angewandte Regel und die beteiligten IDs protokollieren.
Automatische Deduplizierung ist besonders riskant, wenn die Kosten einer falschen Zusammenführung höher sind als die Kosten für zwei ausstehende Datensätze. Werden zwei Kunden fälschlich zusammengeführt, können Rechnungen, Einwilligungen oder Mitteilungen vermischt werden. Ein erkanntes Duplikat lässt sich dagegen über eine Prüfwarteschlange auflösen.
Fusionen benötigen eine eigene Semantik. Definieren Sie einen verbleibenden Datensatz, bewahren Sie historische IDs als Aliasse oder Weiterleitungen auf und veröffentlichen Sie die Änderung, damit konsumierende Systeme ihre Verknüpfungen aktualisieren können. Löschen Sie die übernommene ID nicht sofort: Asynchrone Prozesse, Wiederholungsversuche und historische Datensätze können weiterhin darauf verweisen.
Änderungen, Löschungen und Reaktivierungen ohne Verlust der Nachvollziehbarkeit
Ein technischer Identifikator sollte idealerweise unverändert bleiben. Muss sich eine Geschäftsreferenz ändern, sollte das Ereignis sowohl den bisherigen als auch den neuen Wert übermitteln und den Grund erläutern. Deuten Sie Schweigen niemals als Löschung: Verzögerungen, Zustellfehler oder Synchronisationsfilter können vorliegen.
Verwenden Sie für Löschungen explizite Statuswerte wie aktiv, inaktiv, storniert, gelöscht oder zusammengeführt, abhängig von der Domäne. Eine physische Löschung kann aufgrund von Datenschutzanforderungen erforderlich sein, muss aber gemeinsam mit der Nachvollziehbarkeit konzipiert werden: Möglicherweise kann ein nicht identifizierbarer technischer Marker oder ein Nachweis erhalten bleiben, dass eine Verknüpfung nicht erneut erstellt werden darf.
Verwenden Sie bereits vergebene Referenzen nicht erneut, auch wenn der Datensatz inaktiv ist. Eine Wiederverwendung verwandelt korrekte historische Daten in künftige Mehrdeutigkeit. Stellt eine Reaktivierung dieselbe Entität dar, behalten Sie die ID bei; stellt sie eine neue Entität dar, vergeben Sie eine neue ID und dokumentieren Sie die Beziehung nur, wenn sie operativen Nutzen bringt.
Gestaltung von APIs, Nachrichten und operativen Kontrollen
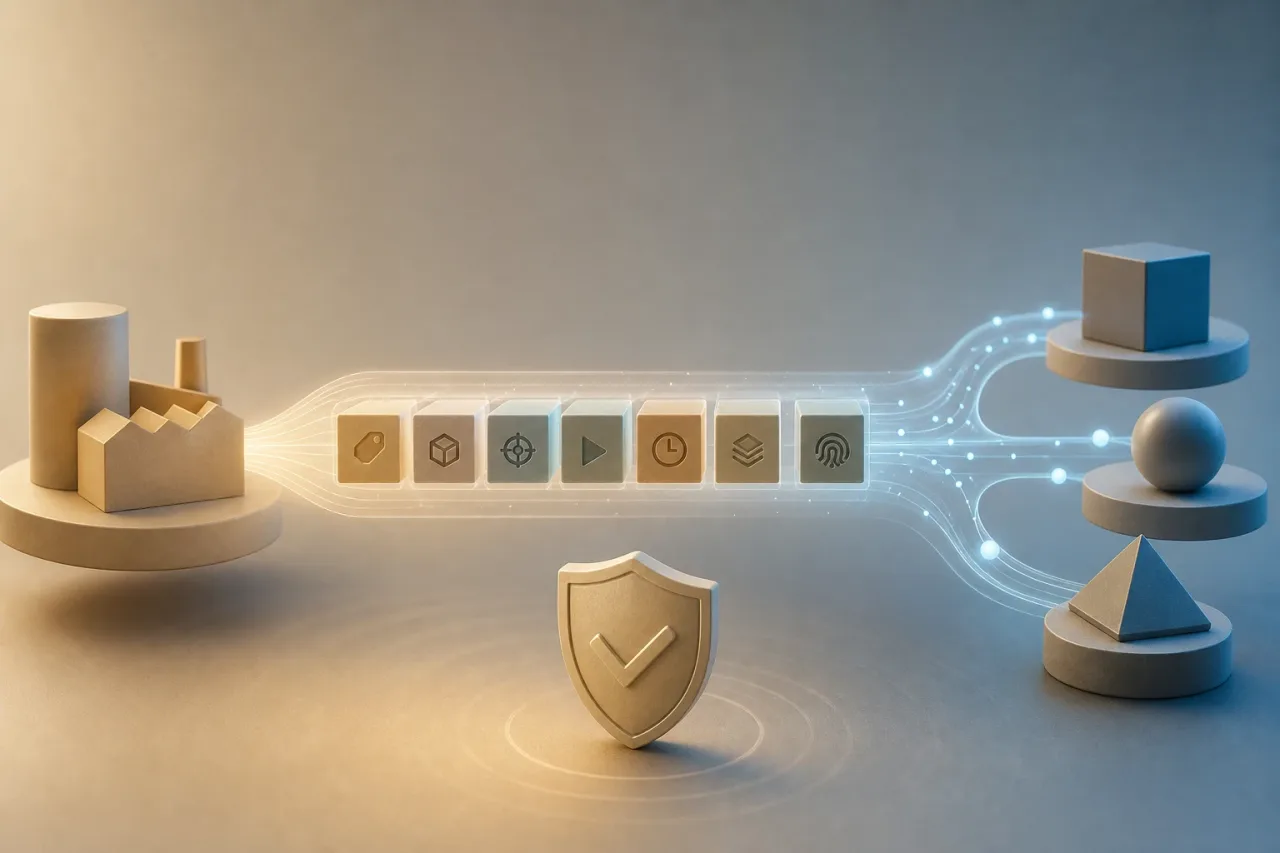
Ein Integrationsvertrag sollte ausreichend Kontext transportieren, jedoch nicht mehr Daten als nötig. Nehmen Sie Entitätstyp, Quellsystem, Ursprungs-ID, Vorgang, Zeitstempel, Version oder Sequenz, sofern zutreffend, sowie eine Ereignis-ID für Wiederholungsversuche auf. Idempotenz verhindert, dass dieselbe Entität bei wiederholter Zustellung mehrfach angelegt wird.
Bei Aktualisierungen sollte eine Operation Vorrang haben, die den verwendeten Schlüssel eindeutig benennt. Ist eine Suche über Geschäftsreferenz erlaubt, behandeln Sie mehrere Ergebnisse als kontrollierten Fehler und nicht als Aufforderung, den ersten Datensatz auszuwählen.
Operative Kontrollen sollten Identitätsprobleme in sichtbare Signale umwandeln:
- Warnungen bei mehrdeutigen Übereinstimmungen und Nachrichten ohne Zuordnung;
- Warteschlangen für ausstehende Verknüpfungen und Prüfungen von Fusionen;
- Kennzahlen zu angelegten Duplikaten, defekten Verknüpfungen und wiederkehrenden Fehlern je System;
- regelmäßige Abstimmungen zwischen erwarteten Anzahlen, Statuswerten und Verknüpfungen;
- Logs mit technischen IDs und Korrelations-IDs, ohne unnötige personenbezogene Attribute offenzulegen.
Dokumentieren Sie vor der Umsetzung für jede Entität ihr maßgebliches System, die lokale ID, akzeptierte externe Schlüssel, Eindeutigkeitsregeln, Änderungsrichtlinie, Löschstatus und Deduplizierungsstrategie. Diese Entscheidung reduziert heute die Kopplung und macht eine künftige Migration, Prüfung oder die Einführung eines neuen Kanals beherrschbar.