

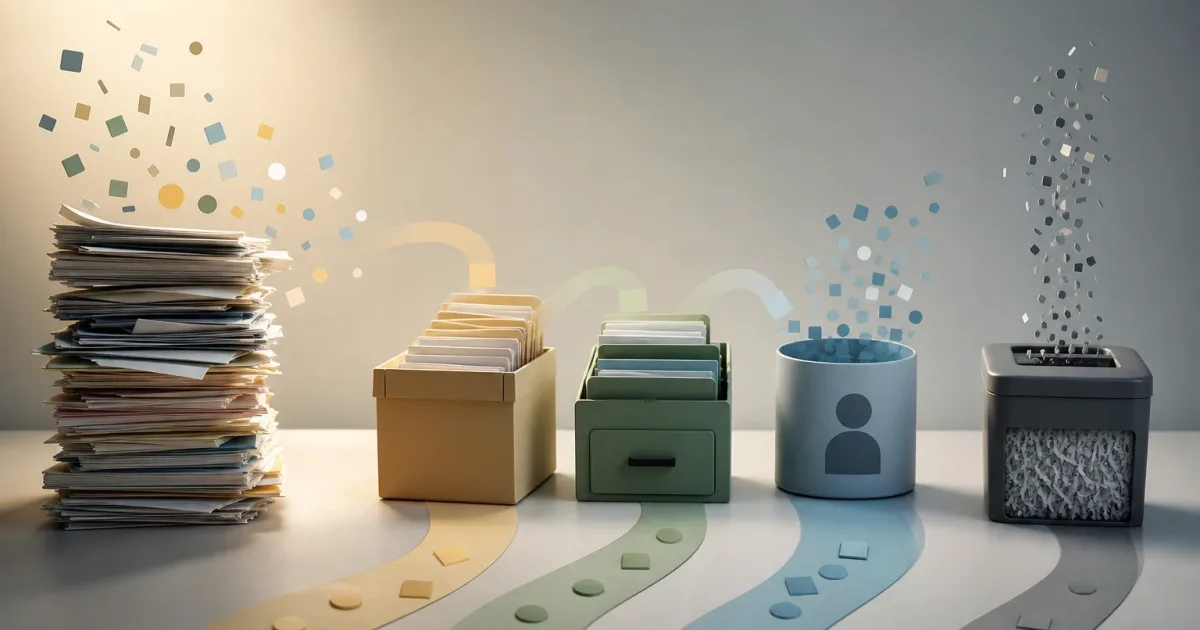
Daten standardmäßig aufzubewahren, wirkt zunächst wie eine vorsichtige Entscheidung: Vielleicht werden sie später benötigt, helfen bei der Bearbeitung eines Vorfalls oder ermöglichen ein besseres Verständnis der Nutzer. Doch eine ungeregelte Ansammlung macht Datenbanken, Analyseplattformen, technische Protokolle und Support-Tools zu einer operativen Belastung. Speicher- und Migrationskosten steigen, mögliche Zugriffe nehmen zu, und es wird schwieriger, nützliche Nachweise von veralteten Informationen zu unterscheiden.
Eine wirksame Datenaufbewahrungsrichtlinie besteht nicht darin, eine einheitliche Frist festzulegen. Sie umfasst überprüfbare Entscheidungen darüber, welche Informationen für welchen Prozess benötigt werden, wer dafür verantwortlich ist, wie lange sie zugänglich bleiben dürfen und wie sie entfernt werden, ohne das Produkt zu beeinträchtigen. Das Ziel ist weder, Daten möglichst schnell zu löschen, noch sie unbegrenzt aufzubewahren: Es geht darum, nur das Notwendige mit ausreichender Nachvollziehbarkeit und kontrollierter Entfernung zu behalten.
Das Problem einer routinemäßigen Datenaufbewahrung
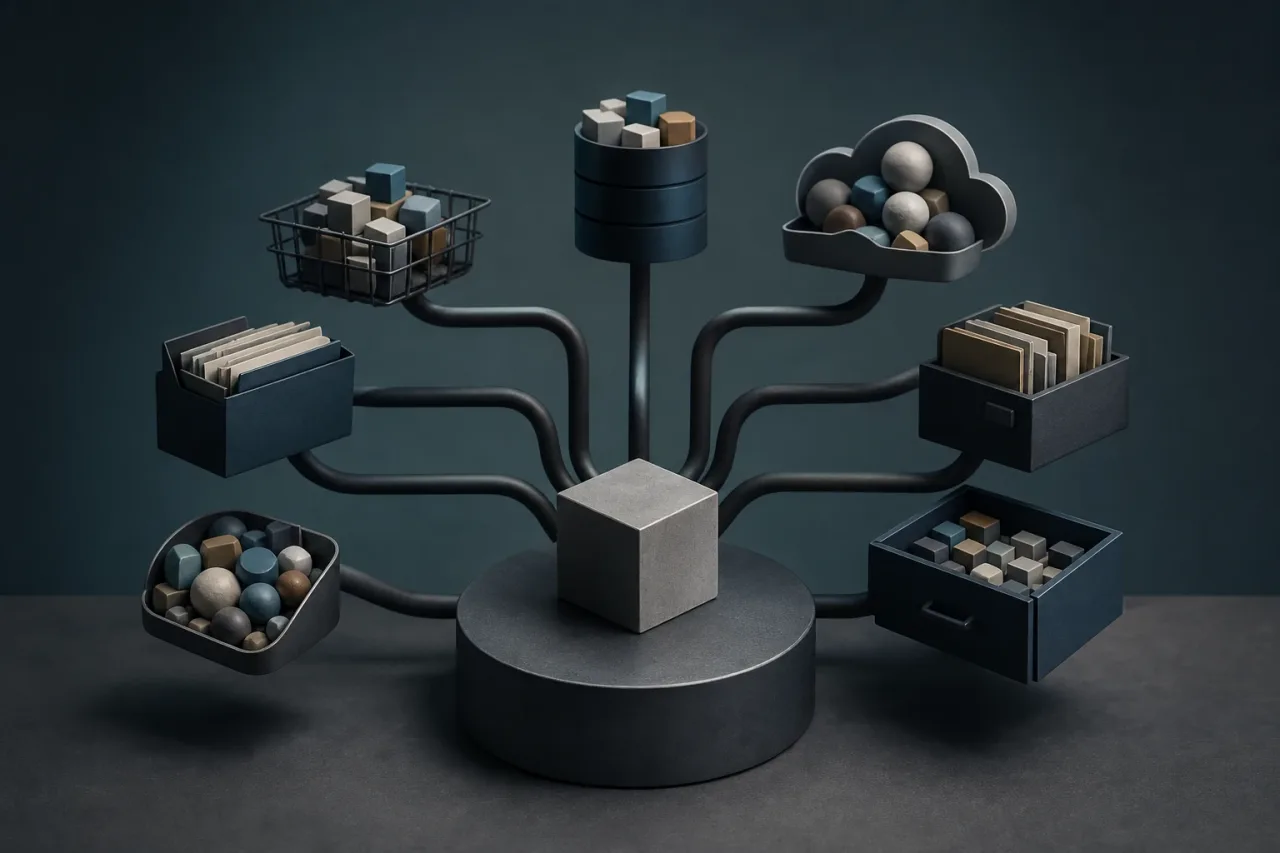
Daten entstehen an vielen Stellen im Produkt: in Formularen, Nutzungsereignissen, Bestellungen, Support-Gesprächen, Integrationen, Anwendungsfehlern, Sicherungskopien und manuellen Exporten. Wenn jedes Team isoliert entscheidet, entstehen Duplikate mit unvereinbaren Lebenszyklen. Ein Datensatz kann im transaktionalen System gelöscht worden sein und dennoch in einem Analyse-Tool, einem Suchindex oder einer wiederherstellbaren Kopie verfügbar bleiben.
Diese Situation schafft konkrete Risiken. Support-Teams können Informationen einsehen, die nicht mehr der Realität entsprechen. Berichte können historische Zeiträume mit inzwischen geänderten Definitionen vermischen. Migrationen dauern länger, weil Tabellen und Dateien ohne aktuellen Wert übertragen werden. Und ein Löschersuchen wird schwer umsetzbar, weil niemand alle Speicherorte der Daten kennt.
Das erste Warnsignal ist, wenn niemand präzise beantworten kann, wo ein Datum gespeichert ist, welcher Dienst es nutzt oder wer seine Löschung freigibt. Weitere häufige Anzeichen sind:
- Tabellen, Felder oder Dashboards ohne benannten Verantwortlichen;
- geteilte Exportkopien, die für punktuelle Anforderungen erstellt wurden;
- technische Protokolle mit personenbezogenen Kennungen über unbestimmte Zeiträume;
- manuelle, außergewöhnliche Löschprozesse oder Prozesse, die von einer einzigen Person abhängen;
- historische Kennzahlen, die sich nicht reproduzieren lassen, weil Quelle oder angewandte Transformation unbekannt sind.
Was es tatsächlich bedeutet, Daten aufzubewahren
Bevor Fristen festgelegt werden, sollten Kategorien getrennt werden, die oft vermischt sind. Aktive Daten ermöglichen den laufenden Betrieb des Dienstes: eine aktuelle Lieferadresse, der Status einer Bestellung oder eine Einstellung, die zur Bereitstellung einer Funktion nötig ist. Historische Daten erfassen vergangene Ereignisse, die für Analysen, Support oder Abstimmungen relevant sind. Nachweise dokumentieren eine Handlung oder Änderung und können erforderlich sein, um zu belegen, wie ein Vorgang zustande kam.
Daneben gibt es Sicherungskopien und technische Protokolle. Eine Sicherungskopie dient dazu, Verfügbarkeit oder Integrität nach einem Vorfall wiederherzustellen; sie sollte nicht zu einem gewöhnlichen Recherchearchiv werden. Technische Protokolle helfen bei der Fehlerdiagnose, bei der Untersuchung auffälligen Verhaltens und bei der Überwachung der Systemgesundheit. Sie können jedoch Kennungen, Parameter oder Nachrichten enthalten, die besondere Kontrollen erfordern.
Die Unterscheidung ist wichtig, weil jede Kategorie unterschiedlich behandelt werden kann. Wird ein Datum aus dem Produkt gelöscht, bedeutet das nicht zwangsläufig, dass es sofort aus allen Sicherungskopien verschwindet. Die Verzögerung muss jedoch definiert und begrenzt sein und darf keinen normalen operativen Zugriff ermöglichen. Ebenso erfordert die Aufbewahrung einer aggregierten Kennzahl nicht, dass die zugehörigen Einzeldaten erhalten bleiben, wenn diese nicht mehr benötigt werden.
Die fünf Fragen für Entscheidungen zum Datenlebenszyklus
Stellen Sie für jeden Datenbestand dieselben Fragen. Das verhindert intuitive Entscheidungen und ermöglicht, verschiedene Systeme in einer gemeinsamen Sprache zu vergleichen.
- Was ist der konkrete Zweck? Beschreiben Sie den Prozess, nicht eine allgemeine Formel wie „für alle Fälle“. Zum Beispiel: Bestellprobleme lösen, Duplikate verhindern, eine monatliche Kennzahl berechnen oder den Dienst nach einem Ausfall wiederherstellen.
- Welche operative Abhängigkeit besteht? Identifizieren Sie Dienste, Berichte, Integrationen, Automatisierungen und Teams, die diese Daten nutzen. Unterscheiden Sie bestätigte Abhängigkeiten von ungeprüften Möglichkeiten.
- Welcher Detailgrad wird benötigt? Vielleicht benötigt ein Prozess eine pseudonymisierte Kennung, einen aggregierten Status oder ein Datum, aber nicht den vollständigen Inhalt eines Gesprächs oder alle Profilattribute.
- Was geschieht bei Aufbewahrung oder Löschung? Bewerten Sie Auswirkungen auf Betrieb, Sicherheit, Nutzererlebnis, Analyse und Wiederherstellung. Wenn die Löschung eine wesentliche Funktion verhindert, muss die Aufbewahrung begründet werden. Dient sie nur einem hypothetischen Komfort, ist sie ein Kandidat für eine Reduzierung.
- Wie wird die Entfernung ausgeführt und überprüft? Definieren Sie den technischen Mechanismus, die Behandlung von Replikaten, die Protokollierung der Ausführung und den Nachweis, der das Ergebnis bestätigt.
Wenn ein Zweck weder einen Verantwortlichen noch einen zugehörigen Prozess hat, sollte er keine unbegrenzte Aufbewahrung rechtfertigen. Bestehen anwendbare vertragliche, gesetzliche oder regulatorische Anforderungen, müssen sie in konkrete Regeln übersetzt und von den für Compliance oder Rechtsberatung zuständigen Personen geprüft werden. Die operative Richtlinie ersetzt diese Prüfung nicht; sie ermöglicht ihre konsistente Umsetzung.
Nach Zweck, Sensibilität und Zugriff klassifizieren
Eine schlanke Klassifizierung ist nachhaltiger als eine übermäßig detaillierte Taxonomie. Sie kann drei Dimensionen verbinden: operativer Zweck, Sensibilität und Zugriffsmuster. Der Zweck erklärt, warum ein Datum existiert; die Sensibilität bestimmt erforderliche Kontrollen und Minimierung; der Zugriff zeigt, ob die Daten täglich, nur ausnahmsweise oder ausschließlich zur Wiederherstellung eingesehen werden.
Kundendaten können beispielsweise Identität, Kontaktdaten, Präferenzen und Aktivitäten umfassen. Bestellungen können für einen definierten Zeitraum eine transaktionale Nachverfolgung erfordern. Support-Gespräche können nützlich sein, solange ein Vorfall oder eine Supportbeziehung besteht; ihr Inhalt muss jedoch nicht genauso lange gespeichert werden wie aggregierte Kennzahlen zu Anfragevolumen. In Anwendungsprotokollen kann das Ersetzen direkter Kennungen durch technische Referenzen oder das Filtern von Feldern die Exposition verringern, ohne die Diagnosefähigkeit einzuschränken.
Vier Behandlungsoptionen
- Aktiv aufbewahren: wenn ein laufender Prozess die Daten häufig einsehen und ändern muss.
- Archivieren: Daten mit eingeschränktem Zugriff und außerhalb des üblichen Ablaufs aufbewahren, wenn sie nur für außergewöhnliche Abfragen oder definierte historische Zwecke benötigt werden.
- Anonymisieren oder aggregieren: die Möglichkeit entfernen oder verändern, Informationen einer Person zuzuordnen, wenn Trends, Zählungen oder Analysen kollektiven Verhaltens ausreichen. Prüfen Sie, ob die Transformation in Ihrem Kontext eine vernünftigerweise vorhersehbare Reidentifizierung ermöglicht.
- Löschen: Daten entfernen, wenn kein aktueller Zweck und keine begründete Abhängigkeit mehr besteht. Beziehen Sie Indizes, Caches, verwaltete Exporte und abgeleitete Datenflüsse in die Prüfung ein.
Bei der Pseudonymisierung ist eine Unterscheidung nötig: Das Ersetzen einer Kennung durch eine andere reduziert die Exposition in bestimmten Datenflüssen, entspricht aber nicht zwangsläufig einer Anonymisierung, wenn weiterhin eine angemessene Möglichkeit zur Zuordnung besteht.
Abhängigkeiten und sichere Entfernung vor der Löschung
Der kostspieligste Fehler ist eine Löschung ohne Verständnis der Abhängigkeiten. Prüfen Sie vor der Aktivierung einer automatischen Regel Berichtabfragen, geplante Aufgaben, APIs, Ereigniswarteschlangen, Support-Tools, Suchmaschinen und Analysemodelle. Es reicht nicht, nur Teams zu befragen: Kombinieren Sie dies mit technischen Inventaren, Observability und, wenn möglich, Tests in einer kontrollierten Umgebung.
Eine sichere Entfernung folgt üblicherweise dieser Reihenfolge:
- Primäre Speicherorte, Replikate und abgeleitete Ziele inventarisieren.
- Verbraucher kennzeichnen und bestätigen, welche Mindestdaten jeder benötigt.
- Ein Ablaufdatum oder eine Ablaufbedingung definieren, die für Systeme und Personen verständlich ist.
- Die Regel an einer Stichprobe oder in einer nicht produktiven Umgebung testen.
- Löschung, Archivierung oder Transformation automatisiert und wiederholbar anwenden.
- Prüfen, dass erwartete Verbraucher weiter funktionieren und die Daten in den vorgesehenen Wegen nicht mehr erscheinen.
- Ausführung, genehmigte Ausnahmen und den nächsten Prüfungstermin dokumentieren.
Für Sicherungskopien ist eine separate Regel erforderlich: Dokumentieren Sie ihren Rotationszeitraum, wer sie wiederherstellen darf und wie verhindert wird, dass eine Wiederherstellung entfernte Daten ohne Kontrollen erneut in die operative Umgebung einführt. Wird eine Kopie wiederhergestellt, muss das Team wissen, welche Synchronisierungs- oder nachträglichen Entfernungsaufgaben erforderlich sind.
Eine umsetzbare Aufbewahrungsmatrix erstellen
Die Aufbewahrungsmatrix ist die Brücke zwischen Geschäftsentscheidung und Umsetzung. Sie sollte einfach zu pflegen und zugleich konkret genug sein, damit Produkt-, Daten-, Infrastruktur- und Betriebsteams dieselbe Regel gleich auslegen. Benennen Sie einen Verantwortlichen für den Zweck und einen für die Umsetzung; beide Rollen können zusammenfallen, haben aber unterschiedliche Verantwortlichkeiten.
Datenbestand | Zweck | Verantwortliche Person | Speicherort | Verbraucher
Zugriffsebene | Ablaufbedingung | Behandlung | Methode | Überprüfung
In einem vernetzten Dienst könnte eine hypothetische Matrix drei Fälle unterscheiden. Daten aktiver Kunden werden aufbewahrt, solange sie für den Betrieb des Kontos erforderlich sind, und bei einer Statusänderung überprüft. Bestellungen bleiben entsprechend dem definierten Transaktionszweck erhalten; der Zugriff ist auf Teams begrenzt, die Vorfälle und Abstimmungen bearbeiten. Für Support-Gespräche gilt eine eigene Regel: Nach dem vereinbarten Zeitraum wird der Inhalt entfernt oder transformiert, während aggregierte Kennzahlen zu Volumen und Bearbeitungszeiten für die Betriebsanalyse verfügbar bleiben können.
Die Qualität einer Richtlinie zeigt sich in ihrer Ausführung: automatische Regeln, befristete Ausnahmen, Überprüfungsnachweise und Warnungen bei Prozessfehlern. Überarbeiten Sie die Matrix bei Produktänderungen, neuen Integrationen, Neugestaltungen der Analyse, Migrationen oder Vorfällen. So wird Datenaufbewahrung nicht länger zu einer reaktiven Aufgabe, sondern zu einer Produkt- und Betriebskompetenz: Daten mit nachweisbarem Wert bewahren und alles entfernen, was nur Kosten, Exposition und Komplexität erhöht.