

Ein Nutzungslimit schützt eine API vor Lastspitzen, Integrationsfehlern und einer Verwendung, die den Dienst beeinträchtigen kann. Zugleich beeinflusst es die Erfahrung aller, die auf die API angewiesen sind: Eine zu strenge Richtlinie kann legitime Prozesse unterbrechen, während eine zu großzügige kaum Spielraum lässt, um auf eine Überlastung zu reagieren.
Es geht nicht darum, eine allgemeingültige Zahl von Anfragen pro Minute festzulegen. Entscheidend ist, welche Ressource geschützt werden soll, welche Nutzungsmuster normal sind und wie das Limit verständlich und vorhersehbar gestaltet werden kann. Dieser Leitfaden zeigt Kriterien für Kontingente, den Umgang mit Überschreitungen und die Überprüfung einer Richtlinie anhand konkreter Daten.
Welche Probleme Limits lösen – und welche nicht
Limits beschränken, wie viel ein Client oder Prozess innerhalb eines Zeitraums verbrauchen oder wie viele Vorgänge gleichzeitig ausführen kann. Sie helfen dabei, Kapazität zu verteilen, kurze Lastspitzen abzufangen und die Folgen von Fehlern zu begrenzen, etwa wenn eine Schleife ohne Pause wiederholt Anfragen sendet. Außerdem können sie ein kommerzielles Angebot mit festgelegten Nutzungsstufen unterstützen.
Ein Kontingent ersetzt jedoch weder die Kapazitätsplanung noch den Schutz vor Angriffen oder ein effizientes API-Design. Ein Limit kann die Belastung verringern, behebt aber weder eine aufwendige Abfrage noch eine langsame Abhängigkeit oder eine fehlerhafte Wiederholungsstrategie. Ebenso garantiert es für sich genommen nicht, dass alle Verbraucher einen fairen Anteil der Ressourcen erhalten.
Legen Sie vorab das Ziel fest: Soll ein kostenintensiver Vorgang geschützt, Kapazität für unterschiedliche Kunden reserviert oder eine Servicebedingung definiert werden? Wenn mehrere Ziele verfolgt werden, trennen Sie diese. Technische Schutzrichtlinien und kommerzielle Regeln können zusammenwirken, sollten aber nicht verwechselt werden: Für sie gelten unterschiedliche Änderungskriterien und Kommunikationsanforderungen.
Verbraucher und Vorgänge bestimmen, bevor Sie Werte festlegen
Ein Kontingent ist nur dann sinnvoll, wenn das System Anfragen einer stabilen Identität zuordnen kann. Legen Sie fest, ob als Verbraucher ein Konto, eine registrierte Anwendung, ein Zugangsschlüssel, ein internes Team oder ein Endnutzer gilt. Eine IP-Adresse kann ein zusätzliches Signal liefern, identifiziert aber nicht immer einen Kunden: Mehrere Personen können dieselbe Adresse nutzen, und ein Kunde kann seine Adresse wechseln.
Klassifizieren Sie anschließend die Vorgänge. Das Lesen einer zwischengespeicherten Ressource verursacht in der Regel nicht dieselben Kosten wie das Erstellen eines Berichts, der Start eines Exports oder eine umfangreiche Suche. Alle Endpunkte mit einem einzigen Limit zusammenzufassen, vereinfacht zwar die Erklärung, kann aber sehr unterschiedlich aufwendige Anfragen gleich behandeln.
Untersuchen Sie den tatsächlichen Datenverkehr und erwartete Szenarien, bevor Sie Werte festlegen. Achten Sie auf Muster nach Verbraucher, Endpunkt, Uhrzeit, Anfragedauer, Parallelität und Fehlern. Prüfen Sie außerdem, welche Integrationen Stapel verarbeiten oder regelmäßige Synchronisierungen durchführen. Eine legitime Integration kann viele Anfragen in einem kurzen Zeitfenster bündeln, ohne dauerhaft eine hohe Last zu erzeugen.
- Pro Konto oder Anwendung: Ermöglicht eine stabile Richtlinie für den Kunden, sofern die Identität zuverlässig verknüpft ist.
- Pro Vorgang: Schützt Funktionen mit unterschiedlichen Kosten oder Kapazitätsanforderungen gezielt.
- Pro gemeinsam genutzter Ressource: Hilft, die Belastung einer Datenbank, eines Anbieters oder eines gemeinsamen Prozesses zu begrenzen.
Der Geltungsbereich sollte zur geschützten Ressource passen. Lässt sich ein Limit pro Zugangsschlüssel umgehen, indem neue Schlüssel angelegt werden, ist möglicherweise das Konto die passende Einheit. Nutzt ein Vorgang dieselbe Ressource wie andere Endpunkte, reicht ein individuelles Kontingent eventuell nicht aus, um diese Ressource zu schützen.
Kontingente, Parallelität und Lastspitzen: die passende Kontrolle wählen
Ein Kontingent begrenzt die Zahl der Anfragen innerhalb eines Zeitraums. Es macht ein Nutzungsbudget deutlich und lässt sich leicht vermitteln. Dafür müssen der Zeitraum und die Definition einer Anfrage eindeutig sein. Ein festes Zeitfenster kann rund um den Wechsel des Zeitraums eine hohe Konzentration von Anfragen ermöglichen. Ein gleitendes Zeitfenster oder ein tokenbasiertes Verfahren kann diesen Effekt abmildern, ist aber aufwendiger umzusetzen und zu erklären.
Eine Parallelitätsgrenze beschränkt, wie viele Vorgänge gleichzeitig aktiv sein dürfen. Sie eignet sich, wenn Anfragen lange dauern oder während ihrer Ausführung Ressourcen beanspruchen. Das Gesamtvolumen begrenzt sie nicht unbedingt: Ein Client kann viele kleine Vorgänge nacheinander abschließen. Wenn beide Risiken relevant sind, lässt sie sich deshalb mit einem Kontingent kombinieren.
Eine Begrenzung von Lastspitzen kann kurze Ausschläge abfangen, ohne dauerhaft eine hohe Anfragerate zuzulassen. Sie eignet sich für Synchronisierungen oder den Start von Prozessen, sofern der Dienst die zusätzliche Last bewältigen kann. Gewähren Sie Lastspitzen nicht allein deshalb, weil das durchschnittliche Verkehrsaufkommen niedrig erscheint: Auch die verfügbare Kapazität während der Spitze ist entscheidend.
Fragen Sie bei der Auswahl, was zuerst beeinträchtigt wird: das angesammelte Arbeitsvolumen, die Zahl gleichzeitig aktiver Vorgänge oder die momentane Kapazität. Verwenden Sie die einfachste Kontrolle, die das beobachtete Risiko abdeckt. Eine unbegründete Kombination von Mechanismen kann Limits hervorbringen, die schwer zu analysieren sind und widersprüchliche Meldungen verursachen.
Überschreitungen vorhersehbar behandeln
Wird ein zeitlich begrenztes Limit überschritten, sollte sich eine Ablehnung klar von einem unerwarteten Dienstausfall unterscheiden. In vielen Fällen zeigt der HTTP-Statuscode 429 an, dass innerhalb eines Zeitraums zu viele Anfragen eingegangen sind. Kann das System abschätzen, wann die nächste Anfrage wieder angenommen wird, lässt sich dies über den Header Retry-After mitteilen. Die Antwort sollte außerdem erklären, welches Limit erreicht wurde und wo die zugehörige Richtlinie zu finden ist.
Geben Sie keine Erholungszeit an, die das System nicht gewährleisten kann. Lässt sich nicht vorhersagen, wann wieder Kapazität frei wird, sollten Sie nicht zu sofortigen Wiederholungen auffordern. Clients sollten die Wartezeit schrittweise verlängern, die Zahl der Versuche begrenzen und gegebenenfalls eine zufällige Abweichung zur Wartezeit hinzufügen, damit nicht alle gleichzeitig erneut anfragen.
Wenn eine Anfrage einen aufwendigen oder nicht idempotenten Vorgang auslöst, legen Sie fest, wie mit einer Ablehnung umzugehen ist und ob ein erneutes Senden sicher ist. Ein Client sollte nicht jeden Fehler als Erlaubnis verstehen, einen Vorgang unbegrenzt zu wiederholen. Dokumentieren Sie außerdem die Unterschiede zwischen einem ausgeschöpften Kontingent, ungültigen Zugangsdaten und einer vorübergehenden Nichtverfügbarkeit.
Ausnahmen transparent und überprüfbar gestalten
Es kann legitime Gründe geben, ein Kontingent anzupassen: eine Migration, eine vereinbarte Synchronisierung oder eine nachweisbare Änderung des Nutzungsmusters. Legen Sie fest, wer eine Ausnahme beantragen kann, welche Informationen dafür erforderlich sind, wer sie genehmigt und wann sie überprüft wird. Halten Sie Geltungsbereich, Dauer und verantwortliche Person fest, damit eine Ausnahme nicht durch bloße Trägheit zur dauerhaften Regel wird.
Vermeiden Sie informelle Ausnahmen, die an eine einzelne Person oder an Vereinbarungen geknüpft sind, von denen das Betriebsteam nichts weiß. Wenn eine Änderung auf einer kommerziellen Bedingung beruht, stimmen Sie die Kommunikation zwischen Produkt, Geschäft und Technik ab. Ist sie vorübergehend technisch erforderlich, definieren Sie klar, wann sie zurückgenommen wird.
Kontingente können sich ändern, aber aktive Integrationen sollten davon nicht überrascht werden. Kündigen Sie wesentliche Änderungen rechtzeitig an, nennen Sie die betroffenen Nutzer und bieten Sie nach Möglichkeit einen Migrationsweg an. Veröffentlichen Sie die aktuellen Limits und erläutern Sie, ob es sich um garantierte Werte oder um überprüfbare Schwellen handelt. Transparenz bei Änderungen ist Teil der Richtlinie und keine bloße Verwaltungsaufgabe.
Messwerte prüfen, ohne missbräuchliche Wiederholungen zu belohnen
Beobachten Sie sowohl angenommene als auch abgelehnte Anfragen. Gliedern Sie die Daten nach Verbraucher und Vorgang und setzen Sie sie in Beziehung zu Latenz, Fehlern, Parallelität und der Belastung von Abhängigkeiten. Eine steigende Zahl von 429-Antworten kann auf Missbrauch hindeuten, aber auch auf ein falsch bemessenes Kontingent, eine Produktänderung oder eine Integration, die nicht ausreichend informiert wurde.
Betrachten Sie die Signale im Zusammenhang. Erreicht ein Kunde während einer geplanten Aufgabe gelegentlich das Limit, obwohl noch Kapazität verfügbar ist, passen möglicherweise die Regelung für Lastspitzen oder der Zeitraum nicht zu seinem Muster. Steigern mehrere Verbraucher gleichzeitig die Latenz und die Auslastung einer Abhängigkeit, könnte eine Erhöhung ihrer Kontingente das Problem verschärfen.
Erfassen und analysieren Sie Wiederholungsversuche: Viele abgelehnte Anfragen können den Datenverkehr aufblähen und den tatsächlichen Arbeitsbedarf verschleiern. Achten Sie auf wiederholte Versuche ohne Wartezeit, Häufungen direkt nach dem Zurücksetzen eines Zeitfensters sowie auf fehlgeschlagene Anfragen, die unverändert erneut gesendet werden. Teilen Sie diese Erkenntnisse nach Möglichkeit mit dem Verbraucher und messen Sie die Wirkung jeder Anpassung, bevor Sie sie auf alle ausweiten.
Checkliste zur Veröffentlichung einer Richtlinie
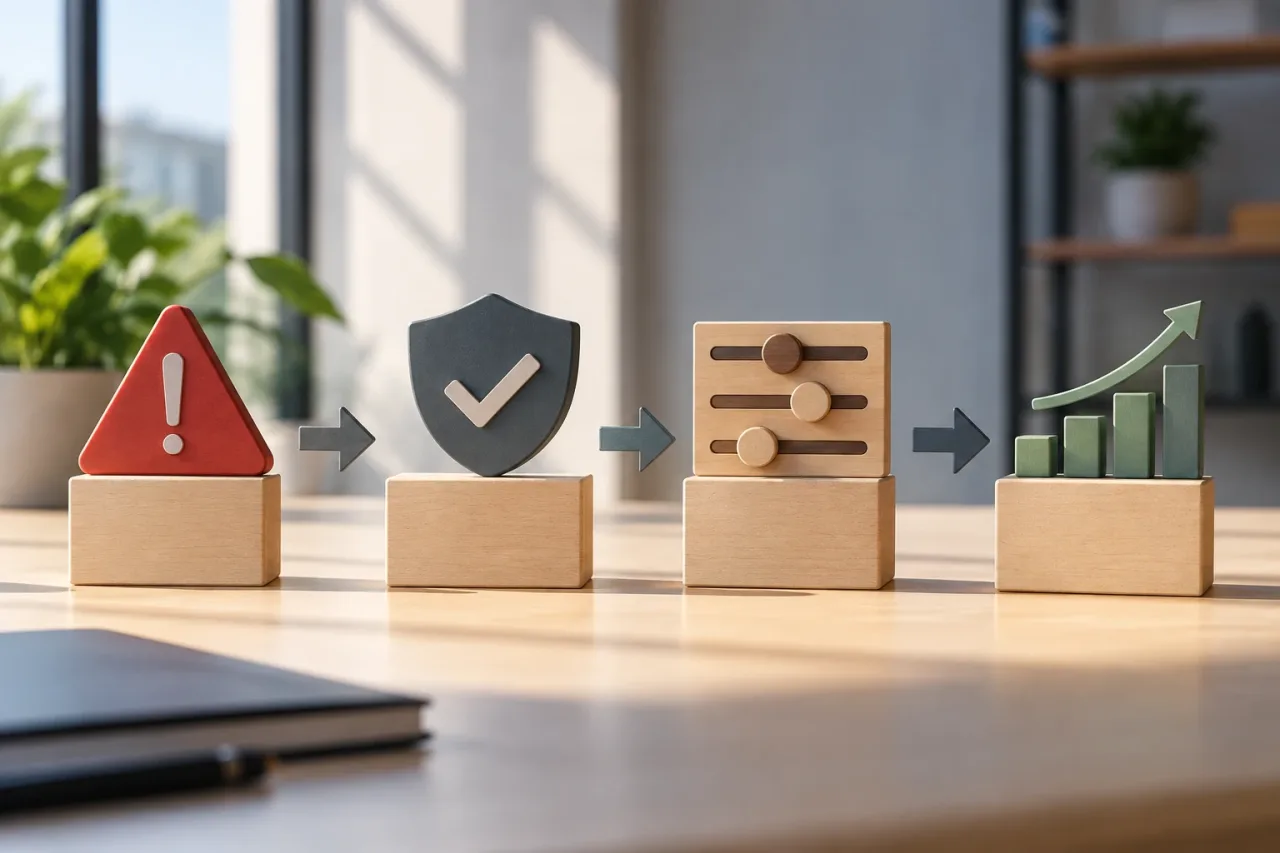
- Legen Sie fest, welche Ressource oder welches Risiko jedes Limit schützt.
- Identifizieren Sie den Verbraucher anhand eines stabilen Schlüssels und erklären Sie, wie seine Zugangsdaten zusammengefasst werden.
- Trennen Sie Vorgänge, wenn sich ihre Kosten oder Nutzungsmuster unterscheiden.
- Dokumentieren Sie Einheit, Zeitraum, Geltungsbereich, Parallelität und Verhalten bei Lastspitzen.
- Beschreiben Sie die Reaktion auf Überschreitungen und die Hinweise zu erneuten Versuchen.
- Richten Sie einen nachvollziehbaren Prozess für Ausnahmen und Änderungen ein.
- Überwachen Sie Ablehnungen, Wiederholungen, Latenz und Ressourcenauslastung.
- Prüfen Sie die Richtlinie anhand von Daten und kündigen Sie Änderungen, soweit möglich, vor ihrer Umsetzung an.
Die beste Richtlinie ist nicht diejenige, die die höchstmögliche Zahl an Anfragen zulässt, sondern diejenige, die den Dienst schützt, ohne die Nutzung für Kunden und interne Teams unvorhersehbar zu machen. Beginnen Sie mit dem konkreten Risiko, setzen Sie verständliche Limits ein und passen Sie diese nur an, wenn Messwerte und Integrationsmuster die Entscheidung stützen.