

Eine Anwendung in mehreren Regionen bereitzustellen, wirkt zunächst wie eine direkte Möglichkeit, Ausfälle zu reduzieren oder den Dienst näher an seine Nutzerinnen und Nutzer zu bringen. Doch verteilte Infrastruktur bringt zusätzliche Entscheidungen mit sich: Wie werden Daten repliziert? Was geschieht, wenn eine Region nicht mehr erreichbar ist? Und wer kann die gesamte Umgebung betreiben? Entscheidend ist nicht, wie viele Regionen möglich sind, sondern welches konkrete Problem eine zweite Region lösen würde und ob das Team die Lösung dauerhaft betreiben kann.
Die Entscheidung hängt von den Zielen des Dienstes, seinen Abhängigkeiten und den Folgen eines Ausfalls ab. Eine einfache, gut überwachte Architektur mit erprobter Wiederherstellung kann geeigneter sein als eine multiregionale Konfiguration, die niemand getestet hat. Dieser Leitfaden bietet Kriterien, um Alternativen zu vergleichen und schrittweise vorzugehen.
Was es bedeutet, eine Anwendung in einer oder mehreren Regionen bereitzustellen
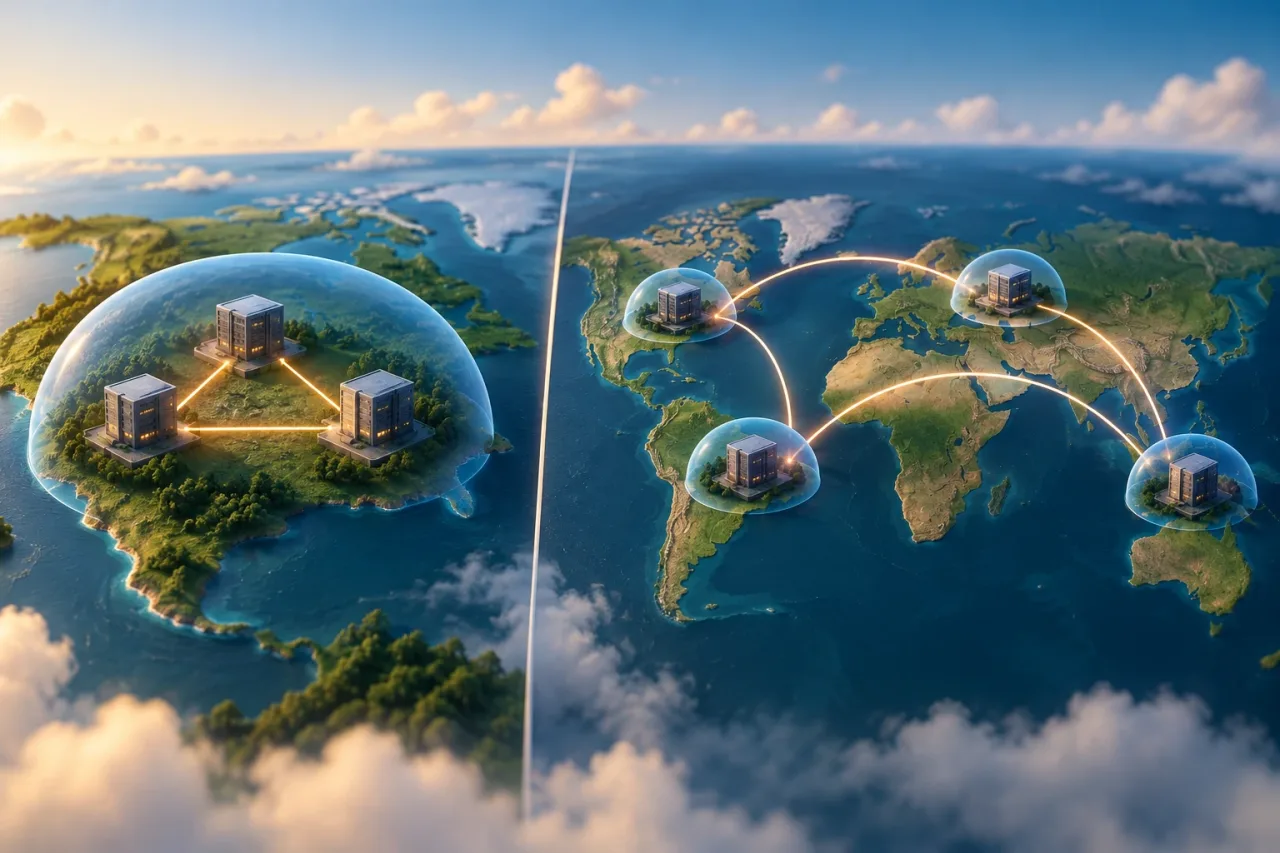
Eine Region ist ein geografischer Standort innerhalb einer Cloud-Infrastruktur. Bei einer Bereitstellung in nur einer Region befinden sich die wichtigsten Komponenten der Anwendung dort, auch wenn sie auf verschiedene Verfügbarkeitszonen verteilt sein können. Mehrere Zonen innerhalb einer Region helfen bei bestimmten lokalen Ausfällen, sind aber nicht gleichbedeutend mit einer vorbereiteten zweiten Region.
Bei einer multiregionalen Bereitstellung werden Anwendungskomponenten an verschiedenen geografischen Standorten betrieben oder können von dort aus betrieben werden. Die Konfigurationen unterscheiden sich: Eine Region kann den regulären Datenverkehr abwickeln, während eine andere für die Wiederherstellung bereitsteht. Alternativ können beide aktiv sein und Anfragen entgegennehmen. Diese Varianten stellen unterschiedliche Anforderungen an Daten, Routing und Betrieb.
Legen Sie zunächst den Umfang fest. Eine Anwendung kann Server in mehreren Regionen haben und dennoch von einer Datenbank, einem Identitätssystem oder einer Integration abhängig sein, die nur in einer Region funktioniert. In diesem Fall bedeutet die Verteilung der Anwendungsschicht nicht, dass der gesamte Dienst bei einem Regionsausfall weiterlaufen kann.
Ermitteln Sie das Problem, bevor Sie die Architektur auswählen
Die häufigsten Gründe, mehrere Regionen in Betracht zu ziehen, lassen sich drei Zielen zuordnen. Jedes erfordert eigene Prüfungen und Entscheidungen:
- Ausfallsicherheit: Den Dienst aufrechterhalten oder wiederherstellen, wenn eine Region nicht verfügbar ist. Legen Sie fest, wie lange eine Unterbrechung dauern darf und wie viele Daten verloren gehen oder rekonstruiert werden könnten.
- Latenz: Die Antwortzeit für geografisch verteilte Nutzerinnen und Nutzer verringern. Der Nutzen hängt davon ab, wo sich die Nutzenden befinden und ob kritische Vorgänge lokal abgewickelt werden können – einschließlich Daten und Abhängigkeiten.
- Datenspeicherort: Anforderungen an Speicherung, Verarbeitung oder Zugriff auf Informationen erfüllen. Kopien an verschiedenen Standorten können geltende Pflichten erschweren, statt sie zu lösen. Prüfen Sie diese Anforderungen für jede Datenart.
Ein messbar formuliertes Ziel verhindert, dass eine Lösung nur aus dem Bauch heraus gewählt wird. Vereinbaren Sie für die Ausfallsicherheit Wiederherstellungsziele für den Dienst und seine Daten. Messen Sie bei der Latenz die tatsächlichen Nutzerpfade. Klären Sie für den Datenspeicherort, welche Daten an welchem Ort bleiben müssen und welche Komponenten sie verarbeiten.
Wann eine gut betriebene einzelne Region ausreichen kann
Eine einzelne Region kann ausreichen, wenn die Auswirkungen eines Ausfalls tragbar sind, sich die Nutzenden auf ein Gebiet konzentrieren oder die aktuelle Latenz den Anforderungen des Produkts entspricht. Sie kann auch die vernünftigere Wahl sein, wenn dem Team noch die Abläufe fehlen, um einen zweiten Standort zu testen und zu betreiben.
Prüfen Sie zunächst, welche Maßnahmen zur Ausfallsicherheit sich innerhalb der bestehenden Architektur umsetzen lassen. Dazu können Redundanz über mehrere Verfügbarkeitszonen, Backups, eine dokumentierte Wiederherstellung, die Überwachung von Abhängigkeiten und eine reversible Bereitstellungsstrategie gehören. Ein Backup schützt nur dann, wenn es sich wiederherstellen lässt und geprüft wurde, ob das Ergebnis zur Wiederaufnahme des Dienstes ausreicht.
Analysieren Sie frühere Vorfälle und Unterbrechungen: Wurden sie durch einen Regionsausfall, eine Softwareänderung, eine externe Abhängigkeit oder ein Konfigurationsproblem verursacht? Wenn das Hauptrisiko nicht regional bedingt ist, könnte ein zusätzlicher Standort den Aufwand erhöhen, ohne die Ursache zu beheben. Halten Sie außerdem fest, wie lange eine manuelle Wiederherstellung dauern würde und welche Aufgaben weiterhin von einer bestimmten Person abhängen.
Kosten und Risiken eines verteilten Dienstes
Die Komplexität einer multiregionalen Umgebung beschränkt sich nicht darauf, mehr Ressourcen zu betreiben. Die Anwendung kann Entscheidungen zur Replikation, Konfliktauflösung, Reihenfolge von Vorgängen und zum Verhalten bei Verbindungsverlust erfordern. Wenn zwei Standorte Änderungen an denselben Informationen annehmen, muss das Design festlegen, welche Quelle maßgeblich ist und wie gleichzeitige Schreibvorgänge behandelt werden.
Konsistenz ist eine Produkt- und Architekturentscheidung. Eine Verzögerung bei der Datenreplikation kann dazu führen, dass Nutzende einen älteren Status sehen oder zwei Vorgänge miteinander in Konflikt geraten. In manchen Fällen ist das akzeptabel, aber nicht jede Funktion kann mit diesem Verhalten umgehen. Legen Sie fest, welche Aktionen sofort eine konsistente Antwort erfordern und welche vorübergehend mit verzögerten Daten funktionieren können.
Prüfen Sie auch externe Abhängigkeiten, Identitätsverwaltung, Warteschlangen, Speicher, DNS oder Routing, Beobachtbarkeit und Bereitstellungsprozesse. Jedes Element kann zu einem einzelnen Ausfallpunkt werden oder eine regionsspezifische Konfiguration benötigen. Zu den Betriebskosten gehören neben der Infrastruktur auch Tests, Bereitschaftsdienste, Vorfallanalysen und die Pflege von Abläufen.
Prüfen Sie, ob kritische Abläufe regionsweise funktionieren können
Erstellen Sie eine Übersicht der wesentlichen Nutzeraktionen – von der ersten Anfrage bis zur abschließenden Bestätigung. Notieren Sie für jeden Ablauf, welche Dienste und Daten beteiligt sind, wo sie sich befinden und was geschieht, wenn die primäre Region nicht mehr antwortet. Betrachtet wird der vollständige Ablauf, nicht ein einzelner Server.
- Funktionen einordnen: Unterscheiden Sie, was für den Betrieb unverzichtbar ist und was eingeschränkt oder vorübergehend nicht verfügbar sein darf.
- Abhängigkeiten erfassen: Berücksichtigen Sie interne Dienste, externe Systeme und Betriebsprozesse, die im Infrastrukturdiagramm möglicherweise nicht auftauchen.
- Ausfälle beschreiben: Untersuchen Sie den vollständigen Ausfall, eine teilweise unterbrochene Verbindung und die Wiederherstellung. Klären Sie, wer das Problem erkennt und wie die Änderung der Datenverkehrsführung entschieden wird.
- Daten validieren: Bestimmen Sie, welche Schreibvorgänge verfügbar sein müssen, welche Verzögerung akzeptabel ist und wie Duplikate oder Konflikte aufgelöst werden.
- Das Ergebnis prüfen: Stellen Sie sicher, dass die für Nutzende sichtbaren Vorgänge abgeschlossen werden – nicht nur, dass die Komponenten antworten.
Diese Prüfung zeigt, ob die Regionen tatsächlich unabhängig sind oder ob der zweite Standort von Ressourcen abhängt, die weiterhin in der ersten Region liegen. Außerdem lässt sich so eine gezielte Verbesserung priorisieren – etwa eine kritische Abhängigkeit wiederherstellbar zu machen –, statt die gesamte Plattform zu replizieren.
Sekundärregion oder aktiver Betrieb in mehreren Regionen
Eine auf Wiederherstellung ausgerichtete Sekundärregion dient in der Regel dazu, den Dienst wiederherzustellen, wenn die primäre Region ausfällt. Das Team muss entscheiden, welche Komponenten bereitgehalten werden, wie die Aktivierung erfolgt und welche Daten bei der Wiederherstellung verfügbar sind. Für die Umschaltung kann ein manueller Eingriff nötig sein. Die tatsächlichen Wiederherstellungszeiten müssen daher getestet werden, statt sie aus dem Design abzuleiten.
Ein Dienst im aktiven Betrieb über mehrere Regionen kann regelmäßig Datenverkehr aus mehr als einem Standort bedienen. Das kann Latenz oder Ausfallsicherheit verbessern, erfordert aber Entscheidungen zu Routing, Lastverteilung und Datenverhalten zwischen den Regionen. Es bedeutet nicht zwangsläufig, dass alle Vorgänge unabhängig sind oder dass der Wechsel bei einem Ausfall automatisch und korrekt erfolgt.
Die Wahl hängt von den vereinbarten Zielen und den betrieblichen Möglichkeiten ab. Wenn der Dienst eine geplante Wiederherstellung toleriert, kann eine Sekundärregion ausreichen. Muss er parallel laufen, um Anforderungen an Verfügbarkeit oder Reaktionszeit zu erfüllen, kann ein aktiver Betrieb sinnvoll sein – sofern die Datenregeln und Tests umsetzbar sind.
Entscheiden Sie anhand von Fakten und gehen Sie schrittweise vor
Bringen Sie Produkt-, Technik- und Betriebsteams zusammen, um vier Fragen zu beantworten: Welche Folgen hätte eine Unterbrechung? Wo befinden sich Nutzende und Daten? Welche Wiederherstellung ist akzeptabel? Und wer kann die Architektur betreiben und testen? Halten Sie Annahmen und Unsicherheiten fest. Bleibt eine kritische Frage unbeantwortet, ist dieser Informationsmangel ein Risiko, das vor einer Erweiterung der Bereitstellung geklärt werden sollte.
Validieren Sie anschließend die kleinste Alternative, mit der sich Erkenntnisse gewinnen lassen. Dazu kann gehören, die Latenz nach Standort zu messen, ein Backup in einer getrennten Umgebung wiederherzustellen oder die Wiederherstellung einer Abhängigkeit zu erproben. Legen Sie bei einem Umschalttest Umfang, Verantwortliche, Startbedingungen und Erfolgskriterien fest. Prüfen Sie außerdem, wie der Normalbetrieb wiederhergestellt und wie mit Datenkonflikten umgegangen wird.
Überprüfen Sie die Entscheidung erneut, wenn sich das Nutzerprofil, die Datenanforderungen, die Auswirkungen einer Unterbrechung oder die Zusammensetzung des Dienstes ändern. Die passende Architektur erfüllt ausdrücklich festgelegte Ziele und lässt sich vom Team nachweislich wiederherstellen. Mehrere Regionen können die richtige Antwort sein, sind aber kein Selbstzweck: Ihr Wert liegt in einer überprüfbaren Verbesserung gegenüber einer einfacheren Alternative.