

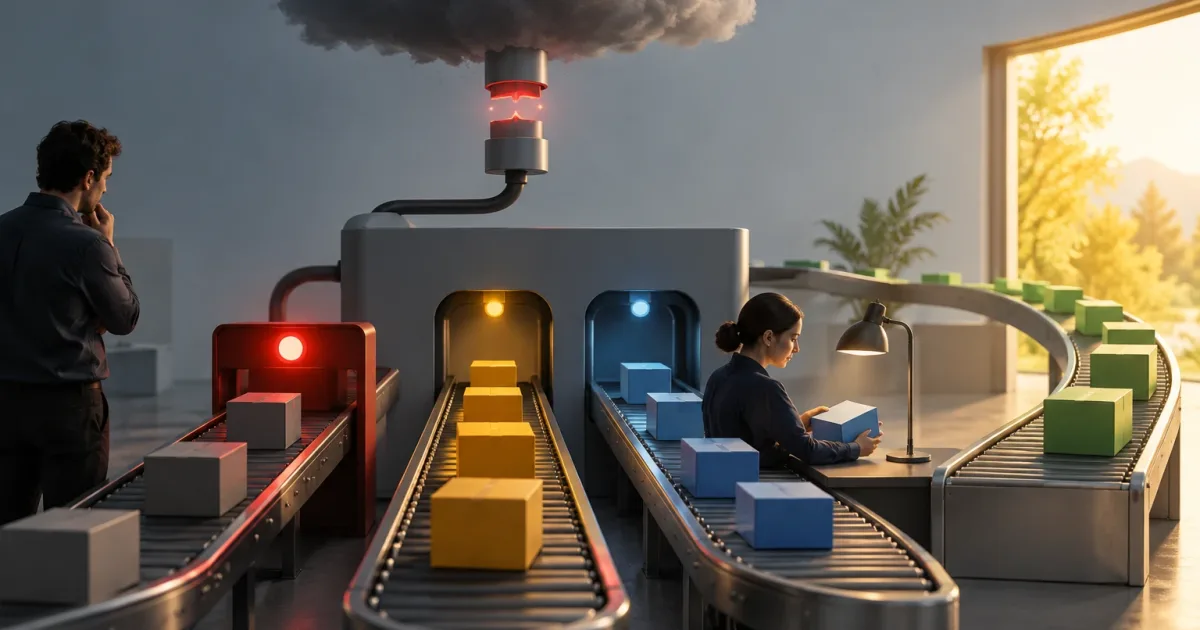
Uma automatização que depende de uma API ou de outro serviço externo pode falhar mesmo que o processo interno esteja a funcionar corretamente. A questão importante não é apenas como detetar o incidente, mas também o que deve acontecer enquanto a dependência estiver indisponível. Uma decisão uniforme — parar tudo ou continuar a qualquer custo — tende a ser inadequada: o impacto depende da função afetada, dos dados necessários e das consequências de agir tarde ou com informação incompleta.
Uma política de contingência traduz esses fatores em decisões operacionais. Determina quando bloquear, quando continuar com limitações e quando encaminhar o caso para uma pessoa; além disso, estabelece como voltar a processar o que ficou pendente. Assim, reduz-se a improvisação e evita-se que uma interrupção técnica se transforme numa decisão de negócio acidental.
Classifique o impacto antes de escolher uma resposta
Comece por descrever o que a dependência fornece a cada processo. O mesmo fornecedor pode ser essencial para uma operação e dispensável para outra. Por exemplo, se um serviço enriquece um registo para facilitar uma análise posterior, talvez seja aceitável guardar o registo sem esse dado. Se verifica uma condição necessária para autorizar uma operação, continuar sem resposta pode ser inseguro ou violar uma regra interna.
Para cada utilização, avalie o que acontece se a tarefa parar, se atrasar ou for concluída com dados incompletos. Considere tanto os danos potenciais como a possibilidade de os corrigir posteriormente. Uma classificação útil distingue entre:
- Bloqueante: continuar sem a resposta externa pode causar uma ação não autorizada, uma perda difícil de reverter ou um resultado incorreto com impacto elevado.
- Adiável: a tarefa pode esperar sem causar prejuízo relevante, desde que alguém a consiga identificar e tratar dentro de um prazo operacional aceitável.
- Degradável: é possível disponibilizar parte do valor sem o serviço, com limites claros e sem apresentar como completo um resultado que não o é.
- Sujeito a revisão: o sistema não dispõe de informação suficiente para decidir com segurança, pelo que deve conservar o caso e solicitar intervenção humana.
Não classifique apenas por componente. Registe o processo, o tipo de operação, o dado afetado e as consequências de cada alternativa. Se o resultado tiver implicações contratuais, económicas, de privacidade ou de segurança, envolva as áreas responsáveis na decisão.
Escolha entre bloquear, degradar ou encaminhar
Bloquear é adequado quando a resposta externa é uma condição necessária e não existe uma alternativa autorizada. O bloqueio deve ser explícito: informe que a operação não foi concluída, conserve o contexto para a retomar e evite estados ambíguos que pareçam indicar sucesso. Defina o que o utilizador pode fazer entretanto, como guardar um rascunho ou tentar a operação mais tarde.
Continuar em modo degradado faz sentido quando é possível dispensar uma função secundária sem comprometer o resultado essencial. Limite as ações que o sistema permite, identifique os dados em falta e comunique a limitação ao utilizador ou à equipa que receberá o resultado. Não transforme a ausência de resposta num valor predefinido aparentemente válido se isso puder induzir em erro. Convém também distinguir entre um dado desconhecido e um dado confirmado como negativo.
Encaminhar para uma pessoa é uma opção quando é necessário usar discernimento, mas a tarefa continua a poder ser resolvida. O encaminhamento exige uma fila visível, informação suficiente para decidir e uma indicação clara do que a pessoa deve verificar. Sem estes elementos, o “modo manual” limita-se a transferir a falha para uma caixa de entrada desorganizada. Defina também quem é responsável por tratar os casos e o que acontece se não forem analisados a tempo.
Estas respostas podem variar consoante a operação. Não é necessário atribuir um único modo a toda a integração: uma consulta informativa pode funcionar de forma degradada, enquanto uma ação que altera um registo sensível é bloqueada. Documente as exceções e evite que o comportamento dependa de pressupostos implícitos no código.
Estabeleça limites seguros para a alternativa manual
Um procedimento manual deve ser uma exceção controlada, não uma via paralela sem supervisão. Antes de o disponibilizar, defina que funções podem intervir, que ações são permitidas e durante quanto tempo. A autorização deve ser proporcional ao risco: nem todas as pessoas que analisam um caso precisam de ter permissão para o aprovar ou alterar.
Defina também que evidências ficam registadas. No mínimo, conserve a operação afetada, a informação disponível nesse momento, a decisão tomada, quem a tomou e quando. Se alguém introduzir um dado provisório, indique claramente a sua origem e se precisa de confirmação posterior. Mantenha separados os factos recebidos do serviço e as decisões humanas; essa distinção facilita a auditoria e a correção.
A alternativa precisa de um limite temporal ou de uma condição de encerramento. Por exemplo, pode deixar de ser aceite quando a fila atingir a capacidade definida pela equipa de operações, quando uma autorização expirar ou quando a dependência voltar a estar disponível. Não invente um limite universal: escolha-o em função do volume, do custo da revisão e do risco de acumular trabalho por resolver. Se não houver capacidade suficiente, bloquear novas operações pode ser mais seguro do que criar uma dívida operacional invisível.
Defina quando retomar e como reconciliar pendências
O facto de uma API voltar a responder não prova, por si só, que seja seguro processar tudo o que se acumulou. Defina sinais de recuperação adequados à dependência e ao processo: disponibilidade mantida durante um período estabelecido pela equipa, respostas válidas para as operações necessárias e ausência de discrepâncias que obriguem a interromper a retoma. O critério deve poder ser verificado e não depender de uma impressão.
Antes de retomar, determine o que fazer com cada estado pendente. Alguns casos podem ser processados novamente de forma automática; noutros, é necessário verificar se a operação foi parcialmente concluída ou se alguém a resolveu manualmente. Evite duplicar ações: identifique as operações de modo a que o sistema reconheça quais já foram realizadas e quais continuam em aberto. Se não conseguir confirmar o estado final, encaminhe o caso para revisão em vez de presumir que repeti-lo não tem consequências.
A reconciliação deve comparar o que era esperado com o que aconteceu: tarefas recebidas, decisões manuais, operações concluídas e erros ainda em aberto. Defina quem valida o encerramento e como são corrigidos os dados divergentes. Assim, a recuperação não termina quando o fornecedor volta a estar disponível, mas quando o processo interno regressa a um estado coerente.
Teste os cenários e reveja a política
Teste a indisponibilidade num ambiente controlado e percorra o processo tanto na perspetiva do utilizador como na das operações. Inclua respostas tardias, dados incompletos, recuperação intermitente e uma falha durante uma ação em curso. O objetivo não é testar uma lista genérica de falhas, mas confirmar que cada decisão documentada é executada e que os responsáveis compreendem o que lhes compete fazer.
Esteja atento a sinais de problemas de conceção: casos apresentados como concluídos sem uma resposta válida, filas manuais que crescem sem responsável, utilizadores que repetem uma operação por desconhecerem o seu estado ou tarefas pendentes que não são reconciliadas após a recuperação. Analise também os efeitos nos tempos de atendimento, na qualidade dos dados e no trabalho adicional. Se uma alternativa gerar mais risco ou custo do que esperar, altere a política.
Atualize a decisão quando o processo, o fornecedor, as permissões ou o impacto de uma operação mudarem. Uma contingência válida para uma função informativa pode deixar de o ser se passar a desencadear uma ação com consequências mais graves. A revisão deve envolver as equipas de produto, tecnologia e operações, bem como outras áreas implicadas quando o risco o justificar.
Lista de verificação por dependência
- Que processos e decisões dependem deste serviço externo?
- Que consequências tem parar, adiar ou concluir cada operação sem todos os dados?
- Quais são as condições para bloquear, degradar ou encaminhar para uma pessoa?
- Que permissões, limites de duração e registos são exigidos pela via manual?
- Quem trata os casos pendentes e quando deve o volume ser escalado?
- Que sinais verificáveis autorizam a retoma do processamento?
- Como são identificados duplicados, estados parciais e decisões manuais?
- Que testes e revisões mantêm a política atualizada?
Responder a estas perguntas permite transformar uma dependência externa numa decisão explícita de produto e de operação. A política adequada não elimina as falhas: limita os seus efeitos, mantém as exceções visíveis e oferece um caminho verificável para retomar o trabalho normal.