

Implantar uma aplicação em várias regiões pode parecer uma forma direta de reduzir interrupções ou aproximar o serviço dos usuários. Mas distribuir a infraestrutura também traz novas decisões: como os dados serão replicados, o que acontece se uma região ficar isolada e quem poderá operar o conjunto. A questão não é quantas regiões são possíveis, mas que problema concreto uma segunda região resolveria e se a equipe consegue manter essa solução.
A decisão depende dos objetivos do serviço, de suas dependências e das consequências de uma interrupção. Uma arquitetura simples, bem monitorada e com recuperação testada pode ser mais adequada do que uma configuração multirregional que ninguém ensaiou. Este guia apresenta critérios para comparar alternativas e avançar gradualmente.
O que significa implantar em uma região ou em várias
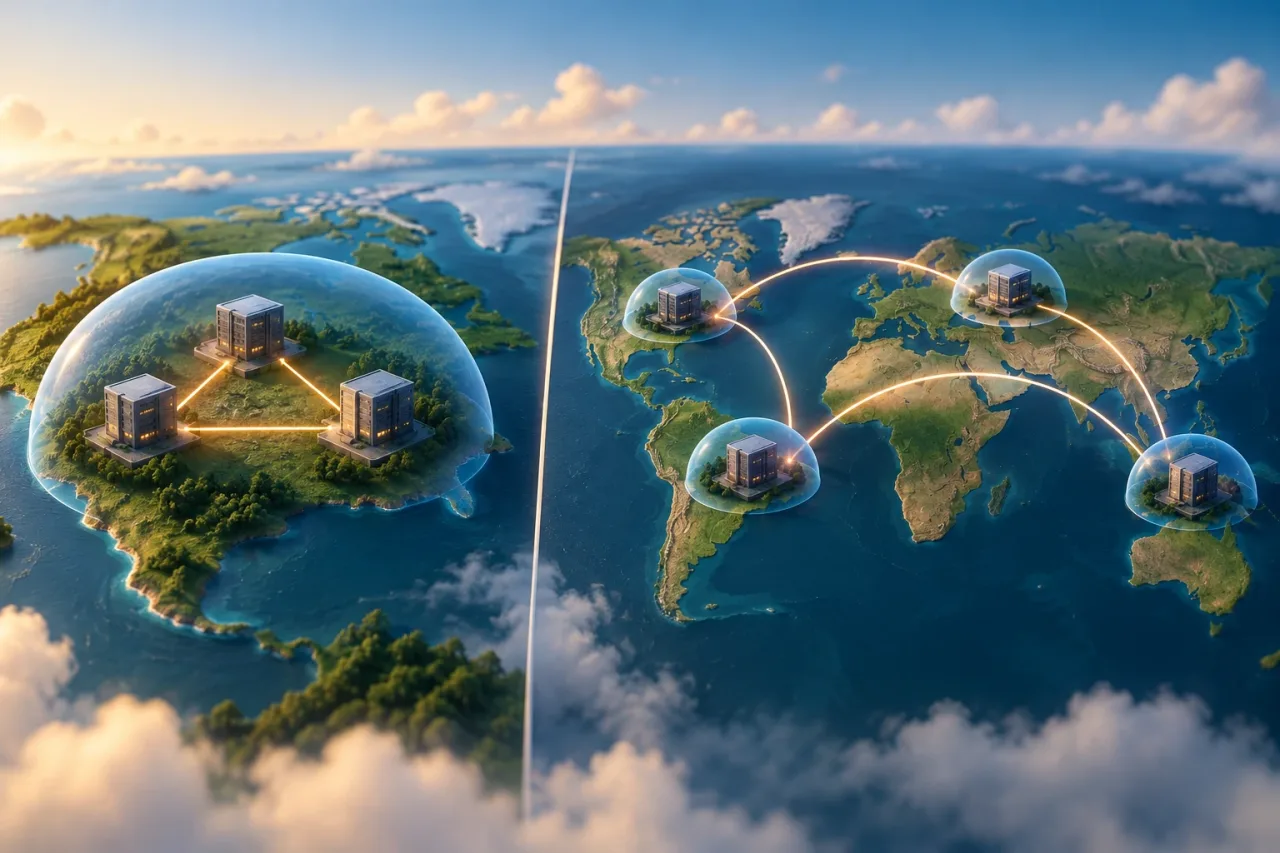
Uma região é uma localização geográfica dentro da infraestrutura em nuvem. Uma aplicação implantada em uma única região concentra ali seus principais componentes, embora eles possam estar distribuídos entre diferentes zonas de disponibilidade. Várias zonas em uma região ajudam a lidar com certos tipos de falha local, mas não equivalem a ter uma segunda região preparada.
Em uma implantação multirregional, os componentes da aplicação operam ou podem operar em diferentes localizações geográficas. A configuração varia: uma região pode atender ao tráfego habitual enquanto outra fica preparada para a recuperação; também é possível manter ambas ativas e recebendo solicitações. Essas opções não têm os mesmos requisitos de dados, roteamento e operação.
É importante definir primeiro o escopo. Uma aplicação pode ter servidores em várias regiões e, ainda assim, depender de um banco de dados, de um sistema de identidade ou de uma integração que funciona em apenas uma delas. Nesse caso, distribuir a camada de aplicação não significa que o serviço completo continuará funcionando diante da perda de uma região.
Identifique o problema antes de escolher a arquitetura
Os motivos mais comuns para avaliar várias regiões se agrupam em três objetivos. Cada um exige testes e decisões diferentes:
- Continuidade: manter ou recuperar o serviço se uma região ficar indisponível. É preciso especificar por quanto tempo a interrupção pode durar e que quantidade de dados pode ser perdida ou reconstruída.
- Latência: reduzir o tempo de resposta para usuários geograficamente dispersos. O benefício depende de onde os usuários estão e de as operações críticas poderem ser atendidas localmente, incluindo dados e dependências.
- Localização de dados: cumprir requisitos de residência, tratamento ou acesso às informações. Manter cópias em lugares diferentes pode complicar, e não resolver, as obrigações aplicáveis; elas devem ser verificadas para cada tipo de dado.
Formular o objetivo de maneira mensurável evita adotar uma solução por intuição. Para continuidade, estabeleça objetivos de recuperação para o serviço e seus dados. Para latência, meça os percursos reais dos usuários. Para localização de dados, identifique quais dados devem permanecer em cada lugar e quais componentes os processam.
Quando uma região bem operada pode ser suficiente
Uma única região pode ser suficiente quando o impacto de uma interrupção é aceitável, os usuários estão concentrados em uma área ou a latência atual atende às necessidades do produto. Também pode ser a opção mais sensata se a equipe ainda não tiver processos para testar e operar uma segunda localização.
Antes de adicionar regiões, examine as medidas de resiliência disponíveis na arquitetura atual. Entre elas podem estar a redundância entre zonas, os backups, a restauração documentada, o monitoramento de dependências e uma estratégia de implantação reversível. Um backup só oferece proteção se puder ser restaurado e se o resultado tiver sido verificado para confirmar que permite recuperar o serviço.
Investigue incidentes e interrupções anteriores: foram causados por uma falha regional, uma mudança de software, uma dependência externa ou um problema de configuração? Se o principal risco não for regional, adicionar outra localização pode aumentar o trabalho sem corrigir a causa. Registre também quanto tempo levaria uma recuperação manual e quais tarefas ainda dependem de uma pessoa específica.
Custos e riscos de distribuir o serviço
A complexidade multirregional não se limita à manutenção de mais recursos. A aplicação pode exigir decisões sobre replicação, resolução de conflitos, ordem das operações e comportamento durante uma perda de conectividade. Se duas localizações aceitarem alterações sobre as mesmas informações, o projeto precisa especificar qual é a fonte de verdade e como lidar com gravações simultâneas.
A consistência é uma decisão de produto e de arquitetura. Um atraso na replicação pode fazer com que um usuário leia um estado anterior ou que duas operações entrem em conflito. Isso pode ser aceitável em alguns casos, mas não se deve presumir que todas as funcionalidades toleram esse comportamento. Defina quais ações exigem uma resposta imediatamente consistente e quais poderiam funcionar temporariamente com dados atrasados.
Também é necessário revisar dependências externas, gestão de identidades, filas, armazenamento, DNS ou roteamento, observabilidade e processos de implantação. Cada elemento pode se tornar um ponto único de falha ou precisar de configuração por região. O custo operacional inclui testes, plantões, análise de incidentes e manutenção de procedimentos, além da infraestrutura.
Avalie se os fluxos críticos podem funcionar por região
Mapeie as ações essenciais dos usuários, da solicitação inicial até a confirmação final. Para cada fluxo, anote os serviços e dados envolvidos, onde estão e o que acontece se a região principal parar de responder. A unidade de análise é o percurso completo, não um servidor isolado.
- Classifique as funcionalidades: diferencie as indispensáveis para a operação daquelas que podem ter desempenho reduzido ou ficar temporariamente indisponíveis.
- Trace as dependências: inclua serviços internos, sistemas externos e processos operacionais que não aparecem no diagrama da infraestrutura.
- Descreva a falha: analise perda total, conectividade parcial e recuperação. Esclareça quem detecta o problema e como é decidida a mudança do tráfego.
- Valide os dados: determine quais gravações precisam estar disponíveis, que atraso é aceitável e como duplicações ou conflitos serão resolvidos.
- Verifique o resultado: confirme que as operações visíveis para o usuário são concluídas, e não apenas que os componentes respondem.
Essa análise revela se existe independência real entre as regiões ou se a segunda localização depende de recursos que continuam na primeira. Também permite priorizar uma melhoria específica, como tornar recuperável uma dependência crítica, em vez de replicar toda a plataforma.
Região secundária ou serviço ativo em várias regiões
Uma região secundária voltada para a recuperação costuma se concentrar em restabelecer o serviço se a principal falhar. A equipe precisa decidir o que será mantido preparado, como será ativado e quais dados estarão disponíveis durante a recuperação. A alternância pode exigir intervenção, por isso os tempos reais devem ser testados, e não deduzidos do projeto.
Um serviço ativo em várias regiões pode atender ao tráfego normalmente a partir de mais de uma localização. Isso pode favorecer a latência ou a continuidade, mas exige resolver o roteamento, a distribuição de carga e o comportamento dos dados entre regiões. Isso não significa necessariamente que todas as operações sejam independentes nem que a mudança diante de uma falha seja automática e correta.
A escolha depende dos objetivos definidos e da capacidade operacional. Se o serviço tolera uma recuperação planejada, uma região secundária pode ser suficiente. Se precisa operar em paralelo para atender às necessidades de disponibilidade ou resposta, a opção ativa pode fazer sentido, desde que suas regras de dados e seus testes sejam viáveis.
Decida com base em evidências e avance gradualmente
Reúna as equipes de produto, tecnologia e operações para responder a quatro perguntas: qual seria o impacto de uma interrupção? Onde estão os usuários e os dados? Que recuperação é aceitável? Quem consegue operar e testar a arquitetura? Registre as premissas e incertezas. Se uma questão crítica não tiver resposta, essa falta de informação é um risco que deve ser resolvido antes de ampliar a implantação.
Em seguida, valide a menor alternativa que permita aprender. Ela pode consistir em medir a latência por localização, restaurar um backup em um ambiente separado ou ensaiar a recuperação de uma dependência. Se houver um teste de alternância, defina o escopo, os responsáveis, as condições de início e os critérios de sucesso; verifique também como retornar ao estado habitual e reconciliar os dados.
Reavalie a decisão quando mudarem o perfil dos usuários, os requisitos de dados, o impacto de uma interrupção ou a composição do serviço. A arquitetura adequada é aquela que atende a objetivos explícitos e cuja recuperação a equipe consegue demonstrar. Várias regiões podem ser a resposta, mas não são um objetivo por si só: o valor está em uma melhoria verificável em relação a uma alternativa mais simples.