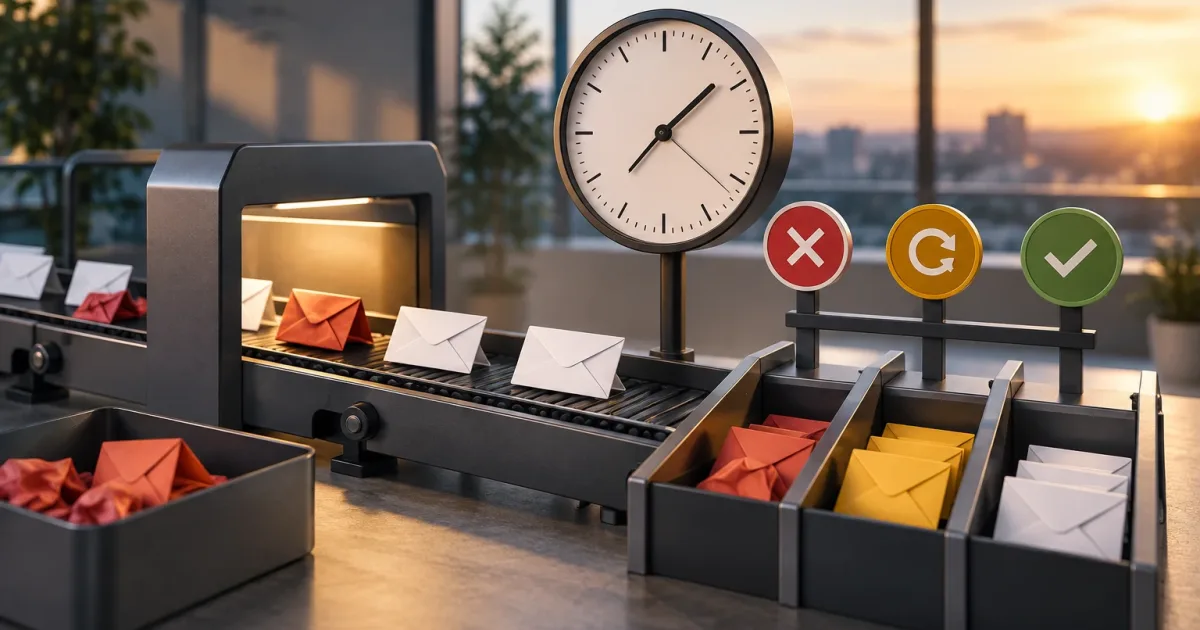
Uma mensagem que falha nem sempre deve ser tentada novamente de imediato, nem mantida indefinidamente. Uma notificação de pagamento pendente, uma atualização de estoque e um lembrete de consulta têm urgências diferentes e também perdem valor em momentos distintos quando chegam atrasados. Por isso, decidir por quanto tempo tentar novamente mensagens com falha é uma decisão de negócio e de operação, além de ser uma configuração técnica.
A política deve responder a três perguntas: quais tipos de falha podem ser recuperados, por quanto tempo ainda é útil executar o evento e o que acontece quando esse prazo termina. Acordar essas respostas reduz tanto os abandonos silenciosos quanto as execuções tardias que confundem clientes ou deixam os sistemas em estados incoerentes.
Por que uma mensagem que continua sendo tentada pode se tornar um problema
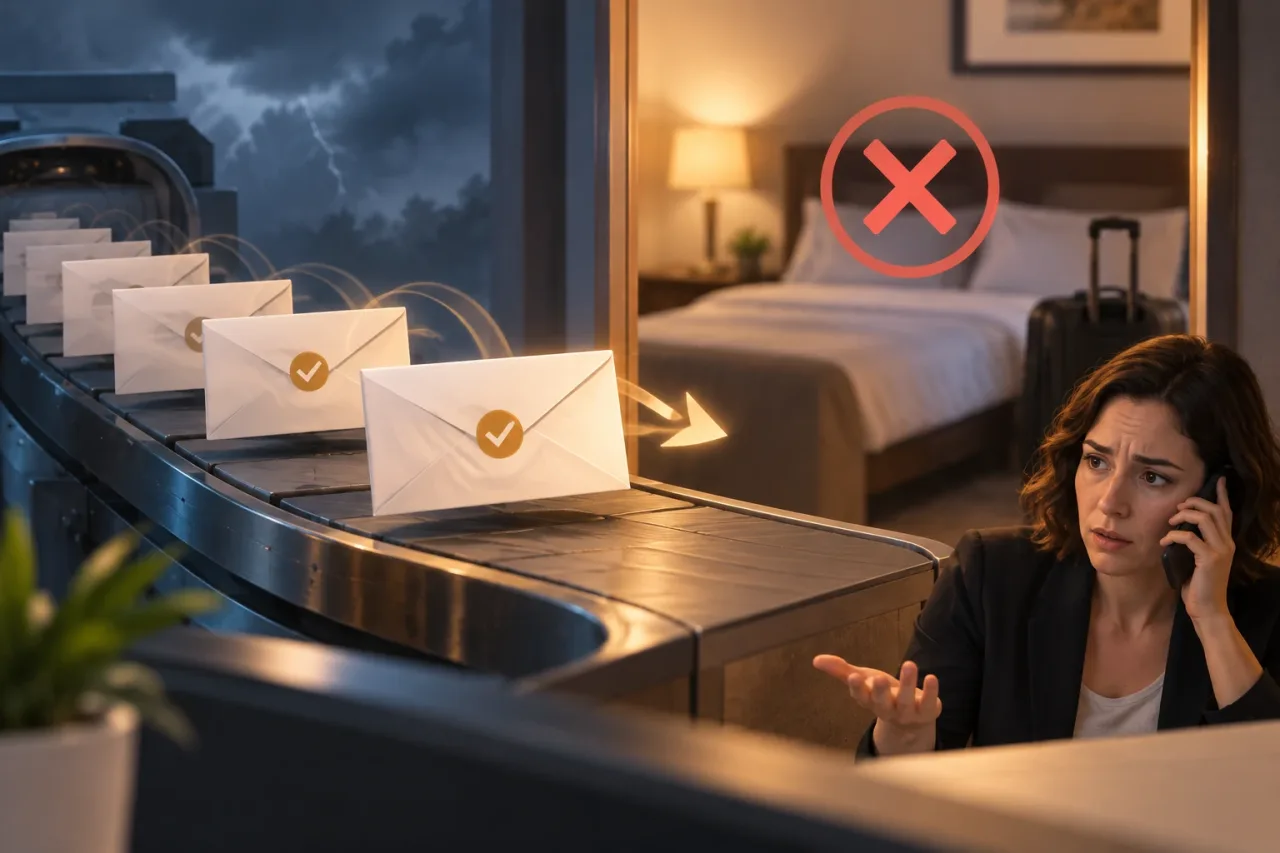
Tentar novamente pode recuperar uma operação após uma interrupção breve. Mas cada nova tentativa também consome recursos e pode produzir efeitos indesejados se a ação for executada depois de perder a validade. Por exemplo, enviar uma confirmação depois que uma reserva foi cancelada pode gerar dúvidas e trabalho para a equipe de suporte, mesmo que a mensagem seja entregue.
O risco não se limita ao atraso. Uma fila de eventos antigos pode dificultar o atendimento de mensagens recentes, e repetir uma solicitação cujo resultado é incerto pode duplicar uma operação. Portanto, a política não deve maximizar o número de tentativas: deve maximizar a possibilidade de concluir ações que ainda agregam valor, limitando os danos causados por aquelas que chegam tarde.
É importante distinguir a retenção técnica — por quanto tempo o sistema mantém o evento — da janela de validade — até quando sua execução é permitida. Esses períodos podem coincidir, mas não precisam. Um evento pode ser mantido depois de expirar para investigar o que aconteceu, sem que isso autorize seu reprocessamento automático.
Classifique as falhas antes de definir a janela
O código de erro, a resposta da integração e o estado do processo ajudam a decidir se uma falha justifica outra tentativa. Como estrutura operacional, separe os casos em três grupos e determine a ação correspondente:
- Transitórias: interrupções de rede, limites temporários do serviço ou indisponibilidade momentânea. Podem justificar uma nova tentativa, desde que a ação ainda esteja válida.
- Permanentes: dados inválidos, destinatário inexistente ou uma solicitação rejeitada por uma condição que não mudará em poucos minutos. Repetir sem corrigir a causa raramente ajuda; em geral, é melhor parar e solicitar uma correção ou intervenção.
- Ambíguas: a conexão foi interrompida e o sistema não sabe se o serviço receptor chegou a concluir a operação. Antes de tentar novamente, verifique o estado, se possível, ou aplique controles para evitar efeitos duplicados.
Nem todas as respostas de um serviço têm uma interpretação universal. Uma resposta temporária pode resultar de uma falha persistente, enquanto um erro aparentemente definitivo pode ser resolvido com a correção dos dados. Documente a classificação para cada integração e revise os casos recorrentes. Se não for possível determinar a causa com segurança, evite tratar todas as falhas como transitórias por padrão.
Defina o prazo conforme a urgência, a validade e as consequências
A janela de novas tentativas começa quando ocorre a falha e termina quando o evento já não deve ser executado automaticamente. Para defini-la, alinhe três critérios com as equipes de negócio e operações:
- Urgência: quanto atraso o processo tolera antes de afetar uma decisão, uma promessa ou o atendimento ao cliente?
- Validade: até quando o conteúdo ou a ação continua correto? Considere mudanças posteriores de estado, como um cancelamento, um pagamento já resolvido ou uma consulta que já passou.
- Consequências do atraso: qual é o custo de executar depois desse momento? Pode ser uma mensagem confusa, uma atualização incorreta ou uma intervenção manual; também pode ser aceitável concluir uma tarefa interna sem impacto visível.
Compare a janela com o ciclo de vida real do processo. Um aviso relacionado a uma data próxima talvez perca utilidade rapidamente; uma sincronização de catálogo pode tolerar um atraso maior. Não adote um prazo único para todos os eventos apenas porque isso simplifica a configuração. Agrupe-os por classe de serviço quando as consequências forem semelhantes e defina exceções somente quando houver uma justificativa clara.
Se a validade depender de um estado que pode mudar, não basta contar as horas desde a primeira falha. Antes de uma execução tardia, verifique se a ação ainda é permitida. Quando essa verificação não estiver disponível, reduza a janela ou encaminhe o caso para revisão, em vez de presumir que o evento continua válido.
Escolha intervalos e limites sem gerar tempestades de tentativas
Um intervalo constante e curto pode fazer com que muitos eventos sejam tentados novamente ao mesmo tempo durante uma interrupção. Em vez disso, considere aumentar progressivamente o intervalo entre as tentativas e definir um limite total de duração ou de tentativas. A separação progressiva reduz a pressão sobre o serviço afetado e dá a ele tempo para se recuperar. Acrescentar uma variação aleatória aos intervalos pode evitar que grupos de processos sincronizados façam novas chamadas ao mesmo tempo.
Os parâmetros devem refletir o comportamento observado, não um número arbitrário. Avalie a duração das interrupções habituais, a frequência com que as tentativas são recuperadas e o tempo que um evento leva para perder sua utilidade. Estabeleça limites para impedir tentativas infinitas, mas confirme que uma falha breve tenha uma oportunidade razoável de ser resolvida. Se o serviço indicar que ainda não se deve tentar novamente, respeite essa orientação quando a integração permitir.
Também é recomendável separar o limite de tentativas da concorrência. Diante de uma falha ampla, aumentar indiscriminadamente o número de tentativas pode agravar o incidente. Um sinal de alerta é o aumento da idade dos eventos pendentes junto com o crescimento do volume de erros. Nesse cenário, verifique a saúde do serviço e limite a pressão, em vez de acelerar as tentativas.
O que fazer quando a janela termina
A expiração deve levar a um desfecho explícito. Parar de tentar novamente sem registrar o resultado equivale a perder visibilidade. Defina, para cada tipo de evento, qual destas opções se aplica:
- Descartar: para eventos expirados e de baixo impacto, cuja execução já não seja válida. Mantenha informações suficientes para explicar o descarte e identificar padrões.
- Encaminhar para revisão manual: para casos de impacto relevante, causa não resolvida ou resultado ambíguo. A revisão precisa de um responsável, contexto e uma ação possível: corrigir, tentar novamente de forma controlada ou encerrar.
- Iniciar uma compensação: quando o processo exigir a correção de um efeito parcial ou a restauração de um estado acordado. A compensação também deve ter condições, responsável e registro; não é simplesmente mais uma tentativa.
Não transforme a revisão manual em uma fila sem responsável. Defina quem a atende, como prioriza os casos por idade e impacto e o que acontece se ninguém agir dentro do prazo acordado. Se os operadores não conseguem distinguir, com os dados disponíveis, um evento recuperável de um obsoleto, o problema está no desenho da revisão, não na velocidade da equipe.
Registre o necessário para diagnosticar e agir
Para cada evento, mantenha um identificador que permita acompanhá-lo, seu tipo, estado, idade, número e horário das tentativas, causa registrada, próxima ação e decisão tomada na expiração. Inclua o sistema de destino quando houver várias integrações. Evite armazenar dados pessoais ou segredos desnecessários para o diagnóstico; aplique as regras pertinentes de acesso e retenção.
Esses sinais ajudam a distinguir uma política curta demais de um incidente externo: proporção de mensagens recuperadas, tempo até a recuperação, volume de eventos expirados, causas mais frequentes e tamanho e idade da fila de revisão pendente. Analise os indicadores por tipo de evento. Uma taxa alta de tentativas bem-sucedidas não justifica ampliar a janela se os casos recuperados chegam depois de perder o valor.
Lista de verificação para definir a política
- Que efeito de negócio o evento produz e quando ele deixa de ser válido?
- Quais falhas são transitórias, permanentes ou ambíguas em cada integração?
- Qual é a janela máxima e como verificar se o evento continua válido?
- Quais intervalos e limites evitam pressão excessiva e tentativas indefinidas?
- Quando a janela expira, o evento é descartado, revisado ou compensado? Quem é responsável?
- Quais dados e métricas permitem explicar o resultado e melhorar a política?
Em última análise, por quanto tempo tentar novamente mensagens com falha depende de quanto tempo a causa leva para desaparecer e de quanto valor a ação preserva nesse período. Defina janelas conforme o impacto, limite as tentativas, trate as falhas permanentes de forma diferente e estabeleça um desfecho operacional. Depois, revise os eventos que mais expiram ou exigem intervenção: eles costumam revelar as melhores oportunidades para ajustar a classificação, a integração ou o próprio processo.