

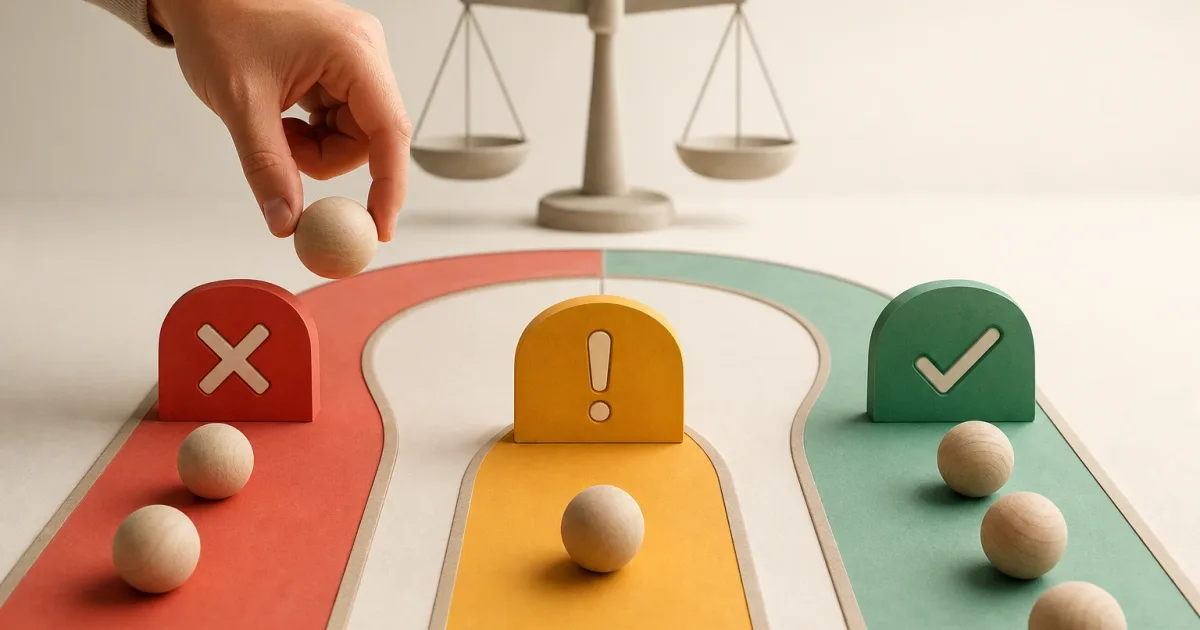
Uma encomenda com uma morada incompleta, um pagamento confirmado que não atualiza o stock ou uma automação que duplica uma comunicação não têm a mesma gravidade nem exigem a mesma reação. Ainda assim, muitas organizações respondem de duas formas extremas: bloqueiam qualquer anomalia e criam fricção operacional, ou permitem que tudo continue até que o dano já seja dispendioso.
Um orçamento de erros aplicado a processos de negócio é um acordo explícito sobre que falhas uma operação pode absorver, durante quanto tempo e sob que controlos. Não consiste em aceitar baixa qualidade. Serve para reservar os bloqueios para os casos que protegem o cliente, o dinheiro, o cumprimento de compromissos e a integridade dos dados; e para tratar os restantes com alertas, filas de revisão e correções rastreáveis.
A decisão deve ser concebida antes de automatizar ou integrar sistemas. Se ficar implícita no código, numa folha de cálculo ou no critério de uma única pessoa, cada incidente será resolvido como uma exceção e o processo perderá consistência à medida que crescer.
Porque nem todos os erros devem parar o processo
Bloquear é uma medida poderosa: impede que um dado inválido se propague e obriga a resolver o problema antes de avançar. Mas também pode interromper encomendas legítimas, gerar trabalho manual, aumentar abandonos e ocultar o volume real de incidentes numa longa fila de casos retidos.
Permitir a continuidade também não é uma opção neutra. Um erro aparentemente menor pode atravessar vários sistemas e transformar-se numa devolução, num ajustamento financeiro ou numa experiência incoerente para o cliente. A questão não é saber se o sistema deve ser rígido ou flexível, mas em que ponto a interrupção reduz mais risco do que acrescenta.
Convém separar a falha técnica da consequência para o negócio. Uma resposta temporariamente falhada de uma API pode ser recuperável através de uma nova tentativa. Em contrapartida, confirmar a um cliente um cancelamento que não foi aplicado pode ter consequências, mesmo que a integração recupere mais tarde. A política deve descrever o efeito observável e a ação esperada, em vez de se limitar a códigos técnicos.
Os cinco critérios para avaliar cada falha
Classifique as falhas com uma matriz simples e repetível. Não é necessário transformar todas as decisões numa pontuação rígida, mas é essencial usar os mesmos critérios entre produto, operações e tecnologia.
- Impacto no cliente e no negócio. Avalie se a falha pode causar uma cobrança incorreta, uma promessa não cumprida, perda de confiança, incumprimento contratual ou uma decisão errada. Um campo interno em falta não equivale a um montante incorreto.
- Reversibilidade. Determine se é possível desfazê-la de forma completa, segura e proporcional. Corrigir uma etiqueta de segmentação costuma ser simples; recuperar uma comunicação enviada ou uma encomenda entregue não é.
- Propagação. Identifique quantos sistemas, equipas ou decisões posteriores consomem o dado. Quanto maior for a dependência a jusante, menor deve ser a tolerância.
- Detetabilidade. Pergunte se o sistema detetará a falha de forma fiável e atempada. Um erro tolerável só é realmente tolerável se existir um sinal que o revele antes de se transformar em dano.
- Urgência temporal. Avalie quanto se reduz a janela de correção. Se houver horas ou dias para rever um caso, pode seguir para uma fila; se uma ação irreversível ocorrer em segundos, pode exigir bloqueio ou uma salvaguarda prévia.
Também é útil distinguir entre dados obrigatórios para executar uma transação e dados desejáveis para a enriquecer. Esta distinção reduz bloqueios desnecessários. Por exemplo, se um processo consegue concluir a operação sem um atributo analítico opcional, a ausência desse atributo deve gerar um alerta e ficar registada, não impedir a ação principal.
Três respostas: bloquear, continuar com alerta ou corrigir depois
Bloquear quando o processo pode causar danos difíceis de reparar
O bloqueio é adequado quando se combinam impacto elevado, baixa reversibilidade, propagação rápida ou falta de deteção fiável. Deve disponibilizar uma saída operacional: uma mensagem clara, um estado do caso e uma forma de o retomar sem repetir ações já realizadas.
- Um pagamento apresenta uma discrepância entre o montante, a moeda ou a identidade esperada.
- O stock disponível não permite confirmar uma encomenda e não existe uma reserva fiável.
- Faltam dados essenciais para cumprir a entrega ou uma obrigação acordada.
- A automação tenta executar uma ação duplicada que poderia cobrar, enviar ou cancelar duas vezes.
Um bloqueio sem alternativa manual nem rastreabilidade pode transferir o risco para outro ponto. Conceba uma fila de exceções, um responsável e regras para impedir que a retoma produza duplicados.
Continuar com alerta quando o dano está limitado e é recuperável
Esta opção permite manter o fluxo principal enquanto ativa um sinal acionável. É útil perante erros transitórios, enriquecimentos não críticos ou sincronizações que podem ser recuperadas. Um alerta não é um registo passivo: deve incluir destinatário, prioridade, prazo de resposta e critério de fecho.
- Uma atualização para um sistema secundário falha, mas a operação principal fica confirmada no sistema de referência.
- Um dado de classificação não crítico não foi calculado.
- Uma comunicação não essencial não pode ser enviada e permite nova tentativa sem duplicação.
Evite alertar para tudo. Alertas sem responsável e sem limiar acabam por ser ignorados. Agrupe falhas repetidas, priorize pelos casos afetados e escale quando for ultrapassada uma janela definida de tempo, volume ou impacto acumulado.
Corrigir posteriormente quando existe controlo e o resultado não é comprometido
A correção diferida serve para defeitos de baixo impacto, reversíveis e detetáveis por reconciliação. Exige uma data-limite e uma fonte de verdade com a qual comparar. Não deve ser usada como desculpa para adiar indefinidamente a qualidade dos dados.
São exemplos habituais um campo descritivo incompleto, uma etiqueta interna incorreta ou um atributo secundário pendente de sincronização. Se esse mesmo atributo começar a condicionar decisões de preço, apoio ao cliente ou cumprimento, deverá mudar de categoria.
Como definir limiares, responsáveis e evidências
Transforme a política em regras compreensíveis, e não numa lista abstrata de princípios. Para cada tipo de falha, documente o evento, o sistema de referência, a ação permitida, o limiar, o responsável e a evidência necessária.
Evento: pagamento confirmado sem atualização de stock
Ação inicial: continuar com alerta
Limiar de escalamento: pendente antes da preparação da encomenda
Responsável: operações de encomendas
Evidência: identificador da encomenda, pagamento, reserva e novas tentativas
Fecho: reconciliação confirmada ou cancelamento rastreável
Os limiares podem ser temporais, quantitativos ou qualitativos. Um exemplo temporal é escalar se uma sincronização não recuperar antes da etapa irreversível seguinte. Um quantitativo é bloquear temporariamente uma integração se surgirem duplicados repetidos. Um qualitativo é escalar de imediato quando o erro afeta montantes, identidade, consentimento ou compromissos comunicados ao cliente.
Defina também a autoridade para aceitar uma exceção. Produto decide o compromisso de experiência; operações conhece a capacidade real de recuperação; tecnologia determina os controlos e limites técnicos; o negócio assume as consequências económicas. Nenhuma destas perspetivas é suficiente por si só.
Exemplo: encomenda, pagamento, stock e comunicação ao cliente
Imagine um fluxo que recebe uma encomenda, confirma o pagamento, reserva stock e envia uma comunicação ao cliente. Se o pagamento falhar, a encomenda deve ser bloqueada: continuar implicaria uma promessa sem suporte. Se o pagamento estiver confirmado, mas a reserva de stock falhar, o caso pode ficar retido antes de confirmar a entrega, com uma revisão prioritária.
Se a reserva for concluída, mas a atualização de um painel interno falhar, a encomenda pode avançar com alerta, desde que o sistema de encomendas mantenha o estado correto e exista reconciliação. Se uma etiqueta interna de campanha falhar, a correção pode ser adiada. Porém, se a comunicação ao cliente contiver uma data de entrega obtida a partir de um dado inconsistente, poderá ser necessário bloquear o envio, mesmo que a encomenda continue em curso: o risco está na promessa, não necessariamente na transação.
Este exemplo mostra porque um mesmo incidente técnico pode gerar respostas diferentes consoante o momento do processo e o efeito que alcança.
Sinais para ajustar a política de tratamento de erros
Reveja a política com dados operacionais, e não apenas após um incidente grave. Há sinais de que uma falha tolerada deve passar a ser bloqueante: surgem reclamações, a correção manual torna-se frequente, o mesmo dado chega a decisões irreversíveis, a deteção acontece demasiado tarde ou as equipas não conseguem fechar a fila dentro do prazo.
Também há sinais de bloqueio excessivo: muitos casos retidos são resolvidos sem alteração relevante, a equipa aplica exceções repetidas, o bloqueio afeta etapas não críticas ou o abandono aumenta sem uma redução equivalente de incidentes. Nesses casos, transfira o controlo para um alerta ou para uma validação posterior, mas apenas se mantiver uma fonte de verdade e uma reconciliação eficaz.
Meça, no mínimo, o volume por tipo de falha, o tempo até à deteção e resolução, os casos que chegam ao cliente, as retomas manuais, as novas tentativas e os duplicados evitados. O objetivo não é chegar a zero alertas; é garantir que cada resposta seja proporcional, verificável e sustentável.
Checklist antes de automatizar ou integrar
- Que resultado de negócio protege cada validação?
- Que ações são irreversíveis ou dispendiosas de desfazer?
- Qual é a fonte de verdade de cada dado relevante?
- Que sistemas recebem o dado se o fluxo continuar?
- Como será detetada a falha e quem receberá o sinal?
- Quanto tempo existe para corrigir antes de o dano aumentar?
- Como se evita repetir uma ação ao tentar novamente ou retomar?
- Que evidência permite investigar, reconciliar e fechar o caso?
- Que limiar transforma um alerta em bloqueio temporário ou escalamento?
- Com que frequência a política será revista segundo a operação real?
Um orçamento de erros bem definido não reduz a exigência: concentra-a onde importa. Permite que os processos digitais avancem perante imperfeições controladas e parem perante riscos que a organização não está disposta a assumir.