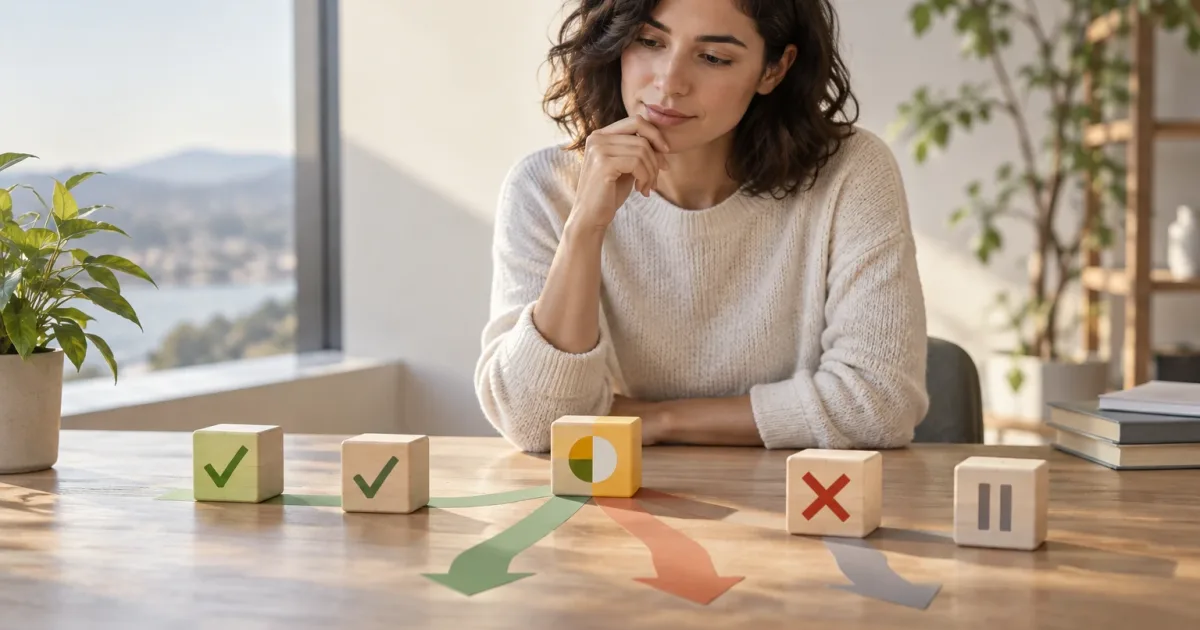
Un processus numérique peut aboutir à certaines étapes et se bloquer à d’autres. Par exemple, une demande peut être enregistrée alors que la notification échoue ; une commande peut être acceptée sans que le paiement soit confirmé ; ou un compte peut être créé sans que le service associé soit activé. Traiter tous ces cas comme une « réussite » ou un « échec » masque souvent des informations importantes et complique la reprise.
Pour décider comment gérer des opérations partiellement réalisées dans un processus numérique, il faut définir quels résultats sont valides, quelles conditions doivent être respectées et quoi faire des effets déjà produits. La réponse ne consiste pas toujours à tout annuler : selon l’activité, il peut être plus sûr de poursuivre, de compenser une action précise ou d’interrompre le flux pour examen.
Pourquoi un processus n’est pas toujours tout ou rien
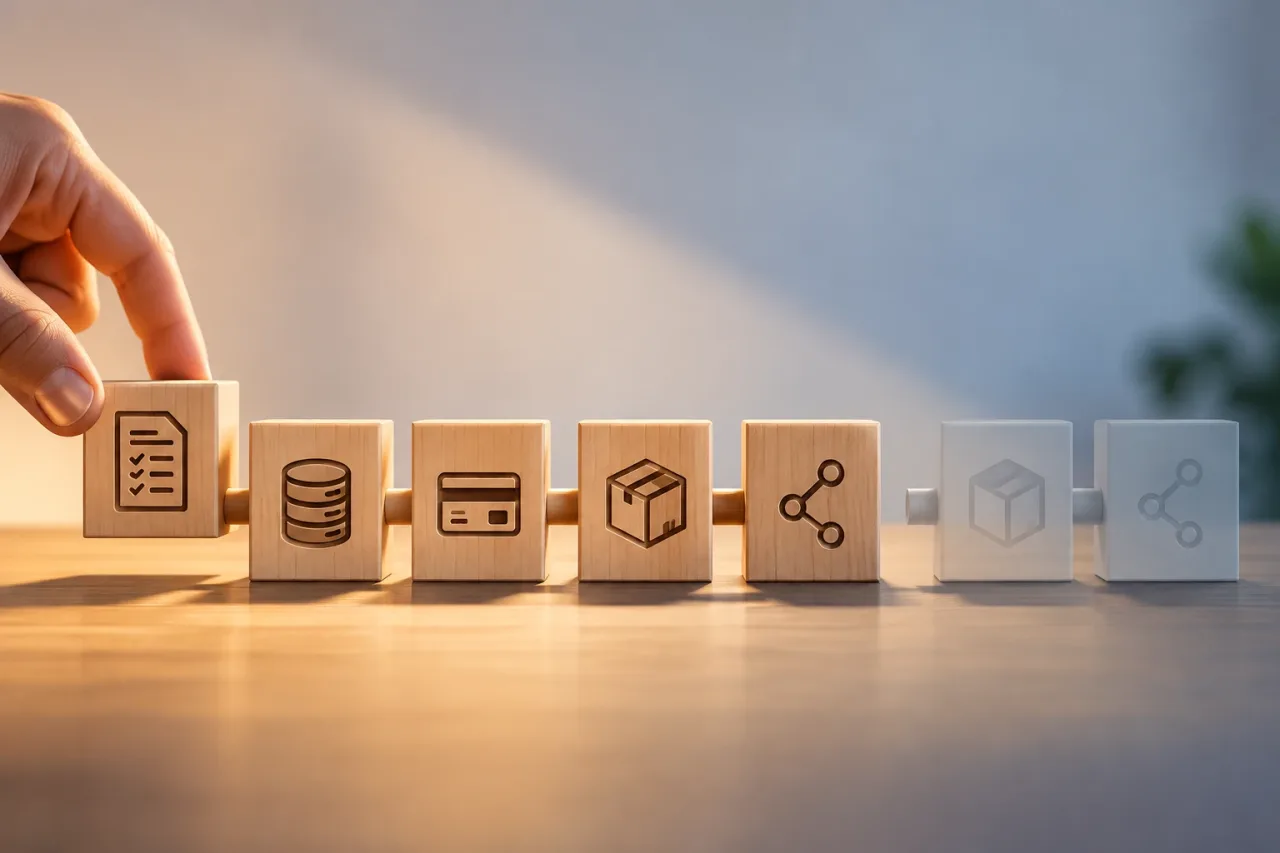
Une opération qui semble unique à une personne peut comporter plusieurs étapes indépendantes : valider des données, enregistrer une entrée, encaisser un paiement, réserver du stock et informer un autre système. Si chaque étape est exécutée dans un composant ou un service distinct, rien ne garantit qu’elles aboutiront toutes ensemble ni qu’une annulation automatique sera possible.
Dans ce type de flux, le système peut connaître le résultat d’une action tout en ignorant celui d’une autre. Un délai d’attente, par exemple, ne prouve pas que le système externe n’a pas reçu la demande : il se peut qu’il l’ait traitée sans que sa réponse soit parvenue. Réessayer à l’aveugle risque de créer un doublon de paiement, de réservation ou de commande.
Il est donc préférable de concevoir le processus en fonction des résultats observables et des règles métier. Une opération partiellement réalisée a besoin d’un état explicite et d’une politique de reprise, et non d’une étiquette d’erreur générique qui efface ce qui s’est passé.
Classez le résultat avant de décider de la suite
Définissez des catégories qui permettent aux équipes produit, opérationnelles et techniques d’interpréter un même cas de la même façon. Une classification utile comprend :
- Réussite complète : toutes les étapes nécessaires et toutes les conditions métier ont été respectées.
- Réussite partielle : certains résultats sont valides, mais une tâche nécessaire reste à accomplir. Le processus doit se poursuivre ou rester en attente d’une action définie.
- Échec récupérable : le processus n’a pas atteint un état final, mais il peut être relancé sans risque ou repris à partir de la dernière étape confirmée.
- Échec nécessitant une intervention : le résultat est incertain, une règle essentielle n’a pas été respectée ou la reprise automatique risque de causer un préjudice.
Il ne suffit pas de nommer les états. Pour chacun, indiquez les éléments qui le confirment, les personnes autorisées à le modifier et les actions permises. Par exemple, si une réponse externe n’est pas arrivée, l’état pourrait être « résultat à confirmer » plutôt que « échec ». Cette distinction évite de répéter une action qui a peut-être déjà été effectuée.
Distinguez les étapes confirmables des invariants métier
Une étape peut être confirmée séparément si son résultat est utile, valide et ne contrevient pas à une règle métier, même si une autre étape échoue. Enregistrer un brouillon avant d’envoyer une notification peut être acceptable. En revanche, marquer une commande comme livrée avant d’avoir confirmé la livraison ne le serait pas.
Pour prendre une décision, commencez par repérer les invariants : les conditions qui doivent toujours être respectées. Ils peuvent concerner des limites de crédit, la disponibilité, le consentement, l’autorisation ou la correspondance entre un paiement et une commande. Demandez-vous ensuite quel état intermédiaire est légitime et quelles conséquences il entraîne pour les personnes, les équipes et les systèmes connectés.
- L’étape déjà exécutée peut-elle être conservée sans induire en erreur ni enfreindre une règle ?
- La tâche en attente est-elle indispensable pour considérer le processus comme terminé ?
- Peut-on répéter l’étape sans produire d’effets en double ?
- Existe-t-il une compensation fiable et autorisée si le processus ne se poursuit pas ?
- Quels éléments permettent de déterminer si le système externe a agi ?
Si vous ne pouvez pas répondre à ces questions, ne présentez pas le flux comme terminé. Définissez d’abord le résultat acceptable et l’autorité habilitée à résoudre les exceptions.
Choisissez entre poursuivre, compenser ou suspendre
Poursuivez lorsque les étapes restantes peuvent être relancées sans risque et que l’état actuel ne compromet aucune règle essentielle. Cette option convient aux tâches en attente qui n’invalident pas les résultats déjà confirmés, à condition d’assurer un suivi et de fixer une limite aux tentatives ou une procédure d’escalade.
Compensez lorsqu’un effet antérieur rend le processus inacceptable et qu’une action inverse est envisageable. Une compensation ne revient pas toujours à effacer ce qui s’est passé : elle peut consister à annuler une réservation, à effectuer un remboursement ou à marquer une demande comme annulée. Vérifiez quels systèmes permettent cette action, quelles sont ses limites et comment en consigner le résultat. Si la compensation échoue elle aussi, il faut prendre une nouvelle décision, et non prétendre à tort que l’annulation a réussi.
Suspendrez le processus pour examen lorsque l’état est ambigu, que l’opération a des conséquences financières ou réglementaires importantes, ou qu’une action automatique risque d’aggraver le problème. La suspension doit créer une tâche attribuée à une personne responsable, avec suffisamment de contexte et un critère de résolution. Laisser un cas en suspens sans responsable ni délai opérationnel ne fait que transformer un incident technique en dette invisible.
Concevez les états et la reprise pour reprendre le flux en toute sécurité
Utilisez des états qui décrivent ce qui s’est produit, et pas seulement ce qui apparaît à l’écran. Selon le flux, ils peuvent comprendre « reçu », « en cours de validation », « confirmé », « en attente d’un tiers », « examen requis », « compensation en cours » et « annulé ». Évitez l’état « terminé » s’il reste une action nécessaire pour tenir la promesse faite à l’utilisateur ou à l’utilisatrice.
Consignez chaque transition avec l’identifiant de l’opération, l’étape, l’heure, le résultat et la référence disponible du système concerné. Distinguez les décisions automatiques des décisions manuelles : savoir qui a autorisé une exception et pourquoi peut être aussi important que le résultat technique. Ne stockez pas de données sensibles inutiles dans les journaux.
Pour reprendre le processus, repérez la dernière étape confirmée et ne répétez que les actions encore en attente. Utilisez une clé d’idempotence ou un mécanisme équivalent lorsque le système destinataire le permet : il sert à éviter qu’une répétition ne produise des effets en double. En l’absence de cette protection, vérifiez l’état distant avant de renvoyer la demande et définissez la marche à suivre si cette vérification est impossible.
Prévoyez également comment détecter les cas bloqués : par exemple, des états qui dépassent le délai opérationnel attendu, des tâches de compensation sans résultat ou des écarts entre les enregistrements de différents systèmes. Une alerte utile débouche sur une action et désigne une personne responsable ; des alertes nombreuses et dépourvues de contexte finissent par être ignorées.
Communiquez le résultat sans masquer les tâches en attente
Le message doit expliquer ce qui s’est effectivement passé, ce qui n’a pas été accompli et ce qui se produira ensuite. Évitez de déclarer une réussite totale lorsqu’une action essentielle manque, mais aussi d’afficher une erreur générique qui laisse penser que rien n’a été enregistré. Si la prochaine étape dépend de l’équipe d’assistance ou d’un examen, dites-le clairement et indiquez un moyen de suivi adapté au processus.
Les outils internes doivent eux aussi présenter des informations exploitables : l’état actuel, les étapes confirmées, la tâche en attente, les éléments disponibles et la personne responsable. Ainsi, les équipes d’assistance et des opérations n’ont pas à reconstituer le cas à partir de messages éparpillés ni à demander à la personne de répéter une opération qui a peut-être déjà produit son effet.
Liste de vérification avant la mise en production du flux
- Énumérez les étapes et les systèmes concernés, y compris ceux qui dépendent de tiers.
- Définissez les états valides, les invariants et les éléments qui confirment chaque transition.
- Décidez quelles étapes peuvent être relancées, lesquelles nécessitent une vérification préalable et lesquelles ne doivent jamais être répétées automatiquement.
- Documentez les compensations, leurs limites et la procédure d’intervention si elles échouent également.
- Testez les délais d’attente, les réponses en double, les interruptions et les résultats incertains, et pas seulement le scénario idéal.
- Désignez les personnes responsables et les signaux de suivi pour les cas en attente ou bloqués.
- Vérifiez que les messages destinés aux utilisateurs et aux équipes décrivent l’état réel et l’étape suivante.
L’objectif n’est pas d’éliminer tous les échecs, mais d’éviter qu’un échec partiel ne devienne un résultat trompeur ou difficile à réparer. Lorsque chaque état a un sens, que chaque effet relève d’une politique et que chaque tâche en attente a une personne responsable, le processus peut être repris sans confondre progression et achèvement.