

Lorsqu’on conçoit une automatisation, il ne s’agit pas de choisir entre « utiliser des règles » et « utiliser l’intelligence artificielle » pour l’ensemble du processus. La décision se prend à chaque étape : quel mécanisme répond le mieux à la tâche, avec quelles limites et que faire lorsque les informations ne permettent pas de répondre de manière fiable. Une règle peut vérifier une condition explicite ; un modèle peut interpréter une description variable. Bien souvent, la solution la plus robuste associe les deux.
Le critère n’est pas le nombre de technologies que l’on peut intégrer, mais le résultat recherché et le risque lié à une erreur. Décomposer les tâches permet d’éviter deux erreurs fréquentes : recourir à l’IA pour des décisions simples, vérifiables par des conditions, ou imposer des règles rigides à des informations ambiguës et changeantes.
Commencez par caractériser chaque étape
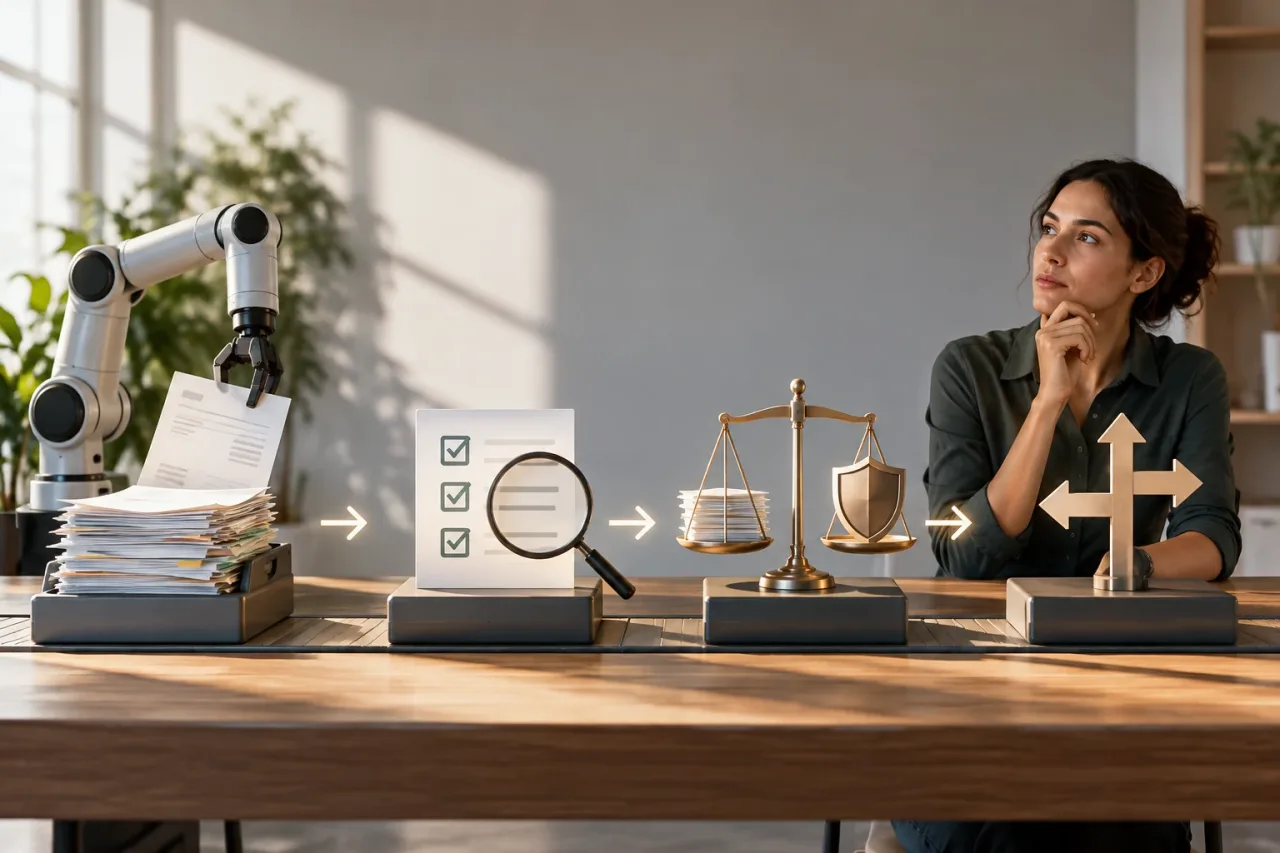
Décrivez chaque étape de l’automatisation à l’aide de quatre questions : que reçoit-elle, que doit-elle produire, quelles preuves doit-elle respecter et que se passe-t-il si elle ne peut pas décider ? Par exemple, « déterminer si une facture dépasse le plafond approuvé » diffère de « comprendre ce qu’une personne demande dans un e-mail ». Même si ces étapes font partie du même flux, leurs entrées et leurs critères ne sont pas identiques.
Les règles sont des instructions explicites : si une condition est remplie, une action est déclenchée. L’IA, en revanche, peut être utile pour interpréter des entrées dont le sens ne s’exprime pas dans une structure fixe. Elle ne dispense pas de définir le résultat attendu, d’examiner les cas incertains ni de décider dans quelles situations le système doit s’abstenir.
Avant de choisir, vérifiez si la tâche peut être divisée. L’IA pourrait, par exemple, proposer une catégorie, tandis qu’une règle vérifie les champs obligatoires et applique la décision finale. Attribuer un mécanisme à chaque tâche, plutôt qu’à l’ensemble du processus, permet souvent de mettre en place des contrôles plus clairs.
Quand les règles suffisent
Les règles sont généralement la solution la plus directe lorsque les données sont structurées, que les critères peuvent être formulés sans ambiguïté et que les résultats sont prévisibles. À titre d’exemples hypothétiques, on peut vérifier qu’un champ est renseigné, calculer un montant selon une formule définie ou orienter une demande en fonction d’un code choisi par l’utilisateur.
Elles conviennent également lorsque chaque décision doit pouvoir être expliquée en termes concrets : « refusée parce que l’identifiant requis était manquant ». Comme les règles sont explicites, il est possible d’en examiner les conditions et d’en modifier une sans devoir interpréter les raisons d’une réponse produite par un modèle. Cela ne les rend pas infaillibles : des données erronées, des conditions incomplètes ou des règles contradictoires peuvent également provoquer des erreurs.
Avant de construire une logique complexe, évaluez le coût de sa maintenance. Une courte liste de conditions stables est facile à gérer ; un nombre croissant d’exceptions peut devenir difficile à comprendre et à tester. Si l’équipe ne peut pas expliquer quelle règle prévaut lorsque deux conditions sont réunies, c’est un signe qu’il faut simplifier ou repenser la conception.
Quand l’IA peut apporter de la valeur
L’IA peut être utile lorsque les entrées sont du texte libre, présentent des variations de langage ou contiennent des informations qui ne correspondent pas à une liste fermée d’options. Elle pourrait, par exemple, proposer une catégorie pour un message formulé de différentes manières ou extraire des données d’un document dont le format varie. Sa valeur réside dans l’interprétation de motifs, et non dans le remplacement de la validation du résultat.
La question pratique consiste à savoir s’il est difficile d’énumérer les variations sans changer le sens recherché. Si chaque nouveau cas oblige à ajouter des mots-clés, des exceptions et des conditions qui se chevauchent, une technique d’interprétation peut être plus adaptée. À l’inverse, si les entrées sont cohérentes et les conditions bien définies, introduire un modèle risque d’ajouter de la complexité sans résoudre de problème réel.
La tolérance aux erreurs compte aussi. Une classification erronée qui ne produit qu’une suggestion soumise à vérification peut présenter un risque différent d’une décision qui déclenche un paiement, rejette une demande ou modifie des données critiques. Définissez les erreurs acceptables, les éléments qui doivent accompagner le résultat et les cas qui ne doivent pas être résolus automatiquement. Le NIST AI Risk Management Framework propose un cadre pour prendre en compte les risques associés aux systèmes d’IA, mais l’évaluation concrète doit correspondre à l’usage prévu.
Critères de choix : précision, explicabilité et exceptions
Comparez les options en considérant l’ensemble de l’opération, et pas seulement leur capacité à produire une réponse. Les critères suivants peuvent aider à structurer la décision :
- Clarté des entrées : les données arrivent-elles dans des champs définis ou sous des formats et des formulations variables ?
- Précision requise : quelles sont les conséquences d’une réponse erronée et peut-on la corriger avant qu’elle n’affecte les étapes suivantes ?
- Explicabilité : faut-il indiquer une condition vérifiable ou une proposition accompagnée de sa source suffit-elle ?
- Exceptions : sont-elles rares et limitées, ou se multiplient-elles au point de rendre les règles difficiles à maintenir ?
- Coût opérationnel : quels efforts faut-il consacrer à la configuration, à la validation, au suivi et à la mise à jour de la solution ?
Il n’existe pas de seuil universel indiquant quand une tâche doit passer des règles à l’IA. Le choix dépend des conséquences des erreurs, de la variabilité réelle des données et de la capacité à gérer les cas que le système ne résout pas. Documentez ces hypothèses : sans elles, il est facile de confondre une préférence technologique avec un besoin opérationnel.
Concevoir une solution hybride avec des limites explicites
Une approche hybride peut confier aux règles le contrôle des conditions objectives et utiliser l’IA pour interpréter les éléments ambigus. Dans un exemple hypothétique d’extraction de données, un modèle pourrait proposer des valeurs repérées dans un texte ; des règles vérifieraient ensuite qu’elles sont présentes, respectent un format valide et se situent dans les limites définies. Si une vérification échoue, le flux ne devrait pas considérer la proposition comme une donnée confirmée.
Pour classer des messages, l’IA pourrait suggérer une catégorie à partir du contenu. Les règles peuvent traiter les catégories qui doivent découler directement de champs structurés et définir la marche à suivre si des informations manquent ou si la proposition n’est pas suffisamment fiable. Dans les deux cas, il faut déterminer qui utilise le résultat, comment il est enregistré et si une action ultérieure peut être annulée.
Fixez des limites qui ne reposent pas sur une interprétation probabiliste : autorisations, plages admises, champs obligatoires et conditions qui empêchent la poursuite du processus. L’IA peut proposer une interprétation ; les règles peuvent empêcher qu’une interprétation incertaine déclenche une opération non autorisée. Si le contrôle humain fait partie du processus, prévoyez un parcours concret plutôt que de le considérer comme une solution vague à tous les échecs.
Tester son choix et reconnaître quand le revoir
Préparez des cas représentatifs avant de considérer une stratégie comme adaptée : entrées courantes, formulations différentes, données incomplètes, formats inattendus et exemples qui ne devraient pas mener à une décision automatique. Évaluez séparément la qualité de l’interprétation et le comportement des validations. Consignez les erreurs par type, par origine des données et par étape concernée.
Une stratégie fondée sur des règles peut nécessiter une couche d’interprétation si les exceptions se multiplient, si les conditions se chevauchent ou si l’équipe consacre toujours plus d’efforts à couvrir les variations de langage. Une solution reposant sur l’IA peut avoir besoin de règles supplémentaires — ou d’un retour à des conditions explicites — si les erreurs concernent des critères clairs, si les résultats dépassent les limites ou si l’explication des décisions est indispensable. Aucun de ces signes n’impose un changement automatique : il faut d’abord en déterminer la cause et l’impact.
Pour documenter la décision, répondez aux questions suivantes :
- Quelle tâche précise cette étape automatise-t-elle et quel résultat doit-elle produire ?
- Quelle partie des entrées est structurée et laquelle nécessite une interprétation ?
- Quelles erreurs coûtent le plus cher et comment les détecter avant de poursuivre ?
- Quelles validations sont obligatoires et quelles situations interrompent le flux ?
- Comment les exceptions seront-elles examinées et quels éléments permettront d’améliorer la conception ?
La solution la plus robuste peut combiner plusieurs mécanismes, mais pas automatiquement. Utilisez des règles lorsque les critères sont explicites et stables, envisagez l’IA lorsque la variabilité complique la rédaction de conditions suffisantes et imposez des validations aux points de contrôle. Chaque étape aura ainsi une justification vérifiable et une procédure à suivre lorsque ses hypothèses ne seront plus valables.