

Automatiser un processus n’oblige pas à automatiser toutes les décisions qu’il contient. Une même opération peut inclure une vérification répétable, une recommandation fondée sur des données et une exception qui exige de comprendre un contexte que le système ne possède pas. Traiter l’ensemble du flux comme s’il exigeait le même niveau d’autonomie crée deux problèmes opposés : des contrôles humains qui ne font qu’ajouter de l’attente et des automatisations qui prennent des décisions aux conséquences que personne ne peut expliquer ni corriger à temps.
La question utile n’est pas de savoir si une personne ou une automatisation réalise mieux un processus complet. Il s’agit de déterminer quelle décision précise est déléguée, dans quelles conditions, avec quelles preuves et comment reprendre le contrôle lorsqu’une situation sort du cadre prévu. Cette approche permet de réduire le travail manuel sans transférer les risques liés à l’activité, au service client, à la conformité ou aux opérations vers une règle opaque.
Distinguer la tâche de la décision
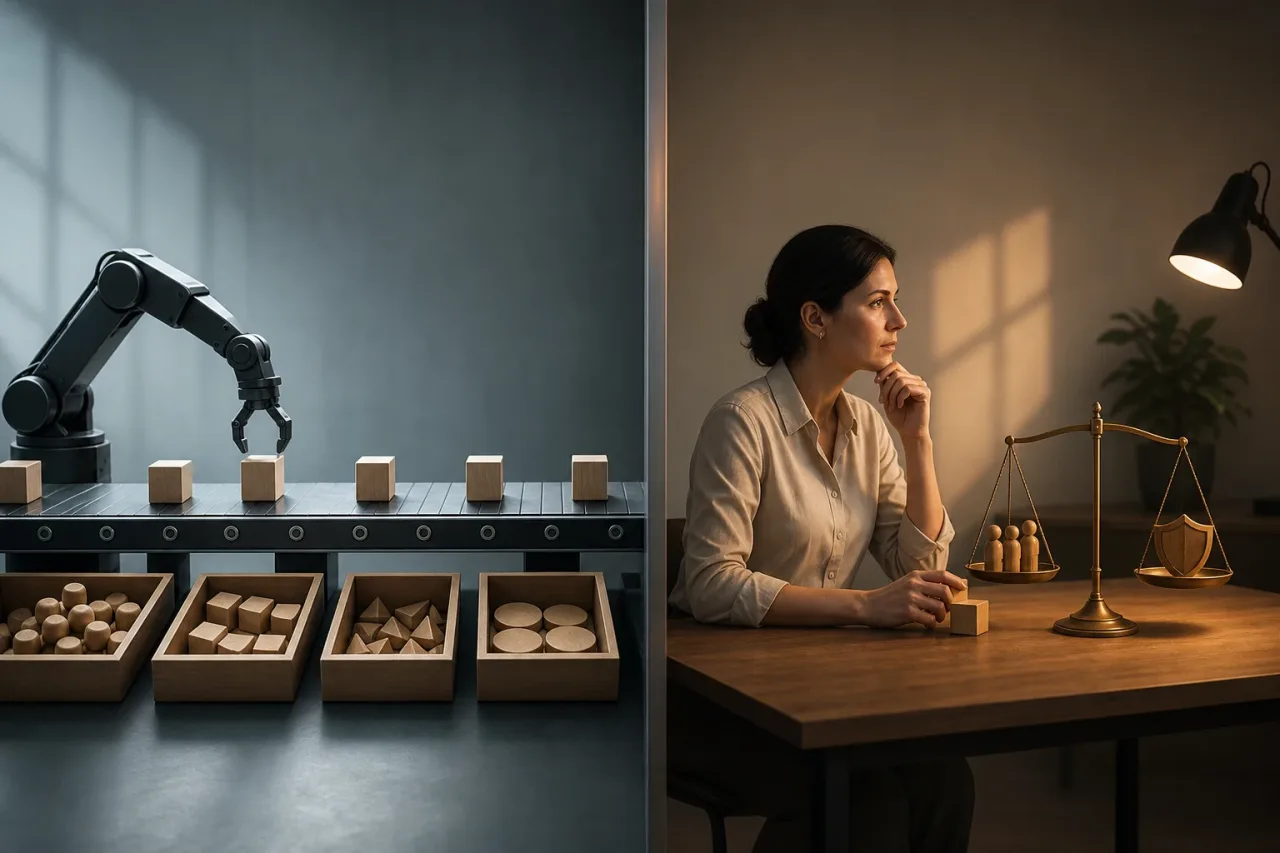
Une tâche est une séquence d’actions : classer une demande, mettre à jour une commande, orienter un dossier ou préparer un paiement. Une décision détermine la conséquence de cette tâche : accepter, refuser, prioriser, attribuer, modifier ou escalader. L’automatisation est généralement adaptée à l’exécution d’étapes définies ; le niveau de prudence doit augmenter lorsqu’elle décide de droits d’un client, de revenus, d’accès à des informations, d’engagements contractuels ou d’exposition à la fraude.
Avant de choisir une technologie, décomposez le processus en décisions observables. Dans la gestion des commandes, par exemple, il ne s’agit pas d’une seule décision consistant à « approuver une commande ». Il peut y avoir la validation de l’adresse, la vérification du stock, la détection de données incomplètes, l’envoi en préparation et l’annulation en raison d’un signal de risque. Chacune présente un impact, des données disponibles et des possibilités d’annulation différents.
- Entrée : quelles données, quels signaux et quels documents sont utilisés.
- Règle ou critère : quelle condition modifie le résultat.
- Sortie : quelle action, communication ou quel enregistrement est produit.
- Conséquence : qui est affecté et quel est le coût d’une erreur.
- Correction : comment une action erronée est corrigée et qui peut le faire.
Cette distinction évite une confusion fréquente : supposer que, parce qu’un système peut classer ou évaluer un dossier, il doit aussi exécuter le résultat correspondant. Un modèle peut détecter qu’une demande semble urgente ; la politique de l’entreprise peut toutefois exiger qu’une personne confirme une priorité qui modifie les engagements pris envers d’autres clients.
Les quatre modes d’intervention
Il n’existe pas de frontière binaire entre travail manuel et automatisation autonome. Concevoir quatre modes intermédiaires aide à choisir des contrôles proportionnés et à rendre visible la personne responsable du résultat.
Informer sans recommander
Le système rassemble des informations, détecte une condition ou présente un résumé, mais ne propose pas de décision. Ce mode convient lorsque l’on explore encore la qualité des données, lorsque le critère n’est pas stabilisé ou lorsque le contexte est déterminant. C’est aussi une manière sûre d’observer des tendances avant d’introduire des règles d’action.
Recommander avec décision humaine
L’automatisation propose une classification, une priorité ou une action suivante et présente les éléments qui l’étayent. La personne accepte, modifie ou rejette la proposition. Ce mode est pertinent dans les cas ayant un impact notable ou une ambiguïté fréquente : exceptions commerciales, demandes sensibles de clients ou évaluations pour lesquelles les données ne reflètent pas toute la situation.
Exécuter avec approbation obligatoire
Le système prépare l’action et demande une autorisation avant de l’appliquer. Utilisez ce mode lorsque l’exécution est coûteuse à annuler, mais que la préparation est répétable. Il peut, par exemple, préparer des modifications de dossiers administratifs et laisser la publication finale à un rôle responsable. L’approbation doit avoir une fonction réelle : accès aux données pertinentes, autorité pour être en désaccord et délai raisonnable pour examiner le dossier.
Exécuter automatiquement avec revue a posteriori
L’automatisation agit dans des limites explicites, enregistre la décision et permet un audit ou un échantillonnage ultérieur. C’est le mode le plus efficace pour les décisions fréquentes, bien définies et réversibles. Il ne signifie pas l’absence de supervision : il exige des alertes, des responsables et un parcours de correction. S’il n’existe aucun moyen pratique de détecter et de réparer les erreurs, l’autonomie est prématurée.
Les cinq critères qui déterminent le niveau d’autonomie
Attribuez un mode d’intervention à chaque décision, et non au processus entier, en évaluant conjointement les critères suivants.
- Impact. Plus la conséquence est importante pour un client, une obligation, la réputation ou les revenus, plus la supervision doit être élevée. Une erreur qui modifie une étiquette interne ne mérite pas le même contrôle qu’une erreur qui annule une relation commerciale.
- Réversibilité. Demandez-vous combien coûte l’annulation de l’action, quel délai est disponible pour le faire et si la personne concernée peut subir une conséquence avant la correction. La possibilité technique d’annuler un enregistrement ne suffit pas si une communication erronée a déjà été envoyée.
- Incertitude des données. Évaluez la couverture, l’actualité, la cohérence et les cas manquants. Des données incomplètes, des changements récents de comportement ou des signaux contradictoires sont des raisons d’escalader le cas, non de forcer une décision.
- Fréquence et volume. Les décisions très répétitives justifient un investissement dans les règles, les contrôles et la surveillance. Toutefois, le volume ne rend pas un critère ambigu sûr ; il ne fait qu’amplifier ses erreurs.
- Besoin de contexte. Conservez l’intervention d’une personne lorsque le résultat dépend de l’intention, d’une relation antérieure, de nuances de langage, de circonstances exceptionnelles ou d’une négociation qui n’est pas représentée dans les systèmes.
Règle pratique : une décision peut être exécutée automatiquement si son impact est limité, si ses données sont fiables, si son résultat est réversible et s’il existe une exception clairement définie. Si deux conditions ou plus ne sont pas remplies, commencez par une recommandation ou une approbation.
Construire une matrice de décision et des règles d’escalade
La matrice n’a pas besoin d’un score d’apparence scientifique pour être utile. Il suffit de documenter un critère cohérent et révisable. Pour chaque décision, définissez le mode initial, les limites opérationnelles et le responsable des exceptions. L’objectif est qu’une personne des opérations, du produit ou de la technologie puisse comprendre pourquoi le système a agi et à quel moment elle doit l’arrêter.
- Contrôle humain : impact élevé, résultat difficile à annuler, éléments probants faibles ou contexte important. Le système peut informer ou recommander.
- Automatisation partielle : règles claires dans la plupart des cas, mais présence de zones d’incertitude, de documents incomplets ou de signaux contradictoires. L’automatisation n’exécute que les cas qui remplissent des conditions strictes.
- Exécution autonome limitée : décision fréquente, faible conséquence individuelle, données validées et mécanisme d’annulation éprouvé. Des échantillons et des indicateurs d’exception sont examinés.
Les seuils doivent exprimer des conditions métier compréhensibles, et non uniquement des valeurs techniques. Une règle telle que si des données requises sont absentes, ne pas exécuter et créer un dossier de revue est plus facile à gouverner qu’une logique qui tente d’inférer silencieusement un résultat. Définissez également ce qui se produit en cas d’échec : arrêter l’automatisation, envoyer le cas dans une file d’attente, appliquer une solution de repli sûre ou avertir un responsable.
Évitez les parcours d’exception sans propriétaire. Chaque escalade doit indiquer une équipe ou un rôle, un délai attendu, les informations qui seront reçues et l’action possible. Sinon, les cas complexes s’accumulent et l’équipe finit par ignorer les alertes ou par approuver des dossiers en bloc.
Appliquer le cadre dans des situations courantes
Dans le service client, une automatisation peut identifier le sujet d’un message et proposer une réponse fondée sur des informations approuvées. Elle peut répondre de manière autonome à des questions simples et répétées si elle ne modifie pas de conditions et ne divulgue pas d’informations sensibles. Elle doit escalader le cas lorsqu’elle détecte une réclamation, une demande hors politique, un éventuel incident de confidentialité ou un langage indiquant un mécontentement important.
Dans les opérations commerciales, elle peut attribuer des contacts selon le territoire ou la disponibilité lorsque les champs nécessaires sont complets et les règles stables. En revanche, une modification des conditions proposées à un client devrait nécessiter une approbation si elle dépend d’une négociation, d’un historique ou d’exceptions à la politique en vigueur.
Dans l’administration interne, une automatisation peut vérifier qu’une demande contient les champs requis, rappeler des documents manquants ou enregistrer une action déjà autorisée. Si elle doit accorder un accès à des systèmes, modifier des données critiques ou approuver un décaissement, il est préférable de séparer la vérification automatisée de l’autorisation humaine, sauf si une politique de faible risque a été expressément définie.
Enregistrer les éléments probants, mesurer les résultats et corriger la conception
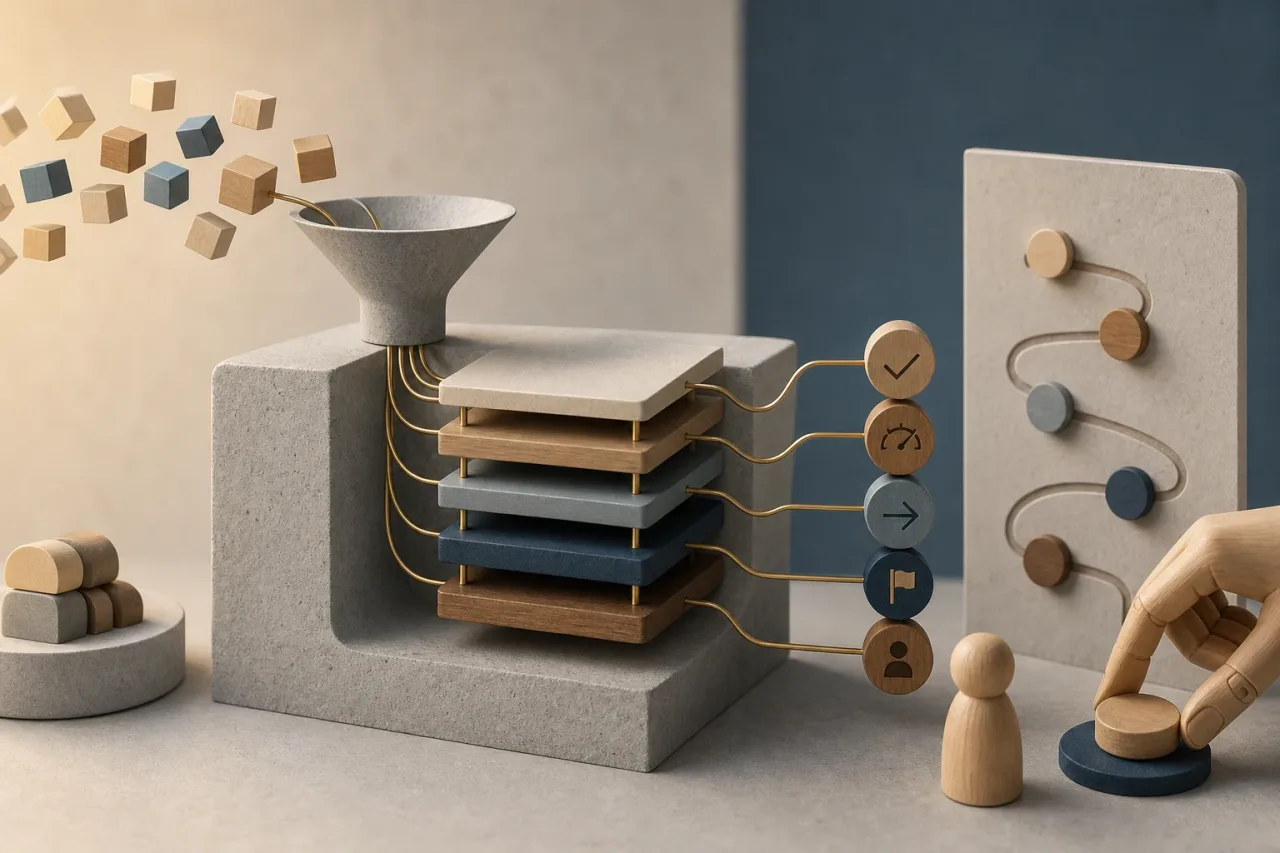
Une décision automatisée doit laisser une trace permettant de répondre à ce qui s’est produit sans reconstituer le dossier de mémoire. Enregistrez la version de la règle ou du modèle appliqué, les données d’entrée pertinentes, le résultat, le niveau de confiance ou la condition de seuil lorsqu’ils existent, l’action exécutée, les exceptions et toute intervention humaine. Il ne s’agit pas de conserver toutes les données sans distinction, mais de garder des éléments probants proportionnés et utiles pour opérer, corriger et rendre compte.
Le NIST AI Risk Management Framework constitue une référence utile pour intégrer l’évaluation et le suivi des risques, notamment lorsque des systèmes d’IA interviennent. La gestion des données est également déterminante : si les définitions, les propriétaires et les contrôles qualité sont ambigus, une automatisation reproduira cette ambiguïté à grande échelle.
Réévaluez le niveau d’autonomie lorsque les signaux suivants apparaissent :
- les corrections ou réouvertures de dossiers exécutés automatiquement augmentent ;
- le pourcentage d’exceptions augmente ou leur typologie change ;
- les personnes acceptent les recommandations sans les examiner, ou les rejettent fréquemment ;
- les politiques, sources de données, intégrations ou conditions de marché sont modifiées ;
- les personnes concernées signalent des résultats difficiles à comprendre ou à corriger.
Avant la mise en production, vérifiez que chaque décision possède un objectif, un responsable, des données définies, des seuils visibles, une voie de sortie en cas d’exception, un enregistrement des éléments probants et un mécanisme d’annulation testé. La meilleure automatisation n’élimine pas le jugement humain : elle le réserve aux cas où il apporte une différence matérielle.