

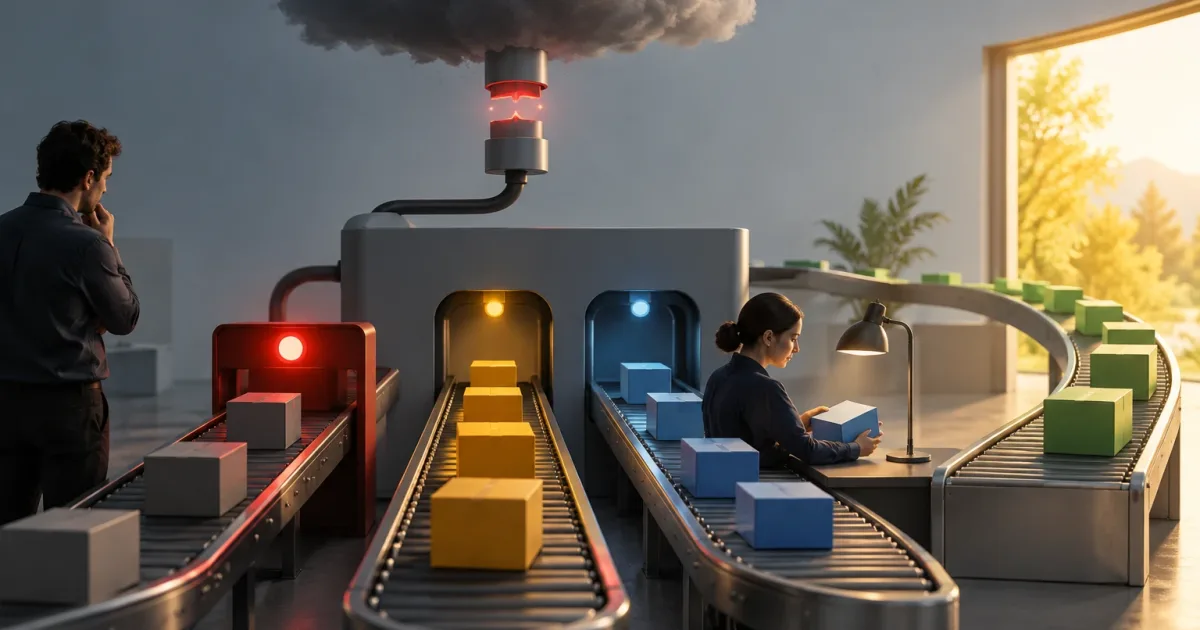
Une automatisation qui dépend d’une API ou d’un autre service externe peut échouer même si le processus interne fonctionne correctement. La question importante n’est pas seulement de savoir comment détecter l’incident, mais aussi ce qui doit se passer tant que la dépendance n’est pas disponible. Une décision uniforme — tout arrêter ou continuer à tout prix — est souvent inadaptée : l’impact dépend de la fonction concernée, des données nécessaires et des conséquences d’une action tardive ou fondée sur des informations incomplètes.
Une politique de continuité traduit ces facteurs en décisions opérationnelles. Elle détermine quand bloquer, quand continuer avec des limitations et quand transmettre le cas à une personne ; elle définit également comment retraiter les tâches en attente. Elle limite ainsi l’improvisation et évite qu’une interruption technique ne se transforme, par accident, en décision métier.
Évaluer l’impact avant de choisir une réponse
Commencez par décrire ce que chaque processus tire de la dépendance. Un même fournisseur peut être indispensable à une opération et facultatif pour une autre. Par exemple, si un service enrichit un enregistrement afin de faciliter une analyse ultérieure, il peut être acceptable de sauvegarder cet enregistrement sans cette donnée. En revanche, s’il vérifie une condition nécessaire à l’autorisation d’une opération, continuer sans réponse peut être risqué ou contraire à une règle interne.
Pour chaque usage, évaluez ce qui se passe si la tâche est arrêtée, retardée ou achevée avec des données incomplètes. Tenez compte à la fois du préjudice potentiel et de la possibilité de le corriger par la suite. Une classification utile distingue les cas suivants :
- Bloquant : continuer sans réponse du service externe peut entraîner une action non autorisée, une perte difficile à annuler ou un résultat erroné aux conséquences importantes.
- Reportable : la tâche peut attendre sans préjudice notable, à condition qu’une personne puisse l’identifier et la traiter dans un délai opérationnel acceptable.
- Dégradable : une partie de la valeur peut être fournie sans le service, dans des limites clairement définies et sans présenter comme complet un résultat qui ne l’est pas.
- À examiner : le système ne dispose pas d’informations suffisantes pour décider en toute sécurité ; il doit donc conserver le cas et demander une intervention humaine.
Ne classez pas uniquement les composants. Consignez le processus, le type d’opération, la donnée concernée et les conséquences de chaque option. Si le résultat a des implications contractuelles, financières, liées à la confidentialité ou à la sécurité, associez les équipes responsables à la décision.
Choisir entre bloquer, dégrader ou transmettre à une personne
Bloquer est approprié lorsque la réponse externe est une condition indispensable et qu’aucune solution de remplacement n’est autorisée. Le blocage doit être explicite : indiquez que l’opération n’a pas abouti, conservez le contexte pour pouvoir la reprendre et évitez les états ambigus qui pourraient laisser croire à une réussite. Précisez ce que l’utilisateur peut faire dans l’intervalle, par exemple enregistrer un brouillon ou réessayer plus tard.
Continuer en mode dégradé est pertinent lorsqu’une fonction secondaire peut être omise sans compromettre le résultat essentiel. Limitez les actions autorisées par le système, signalez les données manquantes et communiquez cette restriction à l’utilisateur ou à l’équipe destinataire. Ne remplacez pas une absence de réponse par une valeur par défaut qui semble valide si cela peut induire en erreur. Il est également utile de distinguer une donnée inconnue d’une donnée dont la valeur négative a été confirmée.
Transmettre le cas à une personne est une option lorsqu’un jugement est nécessaire, mais que la tâche peut encore être résolue. Cette transmission exige une file d’attente visible, des informations suffisantes pour prendre une décision et une indication claire des éléments à examiner. Sans cela, le « mode manuel » ne fait que déplacer le problème vers une boîte de réception désorganisée. Définissez également qui est chargé de traiter les cas et ce qui se passe s’ils ne sont pas examinés à temps.
La réponse peut varier selon l’opération. Il n’est pas nécessaire de choisir un mode unique pour toute l’intégration : une demande d’information peut fonctionner en mode dégradé, tandis qu’une action modifiant un enregistrement sensible doit être bloquée. Documentez les exceptions et évitez que le comportement repose sur des hypothèses implicites dans le code.
Fixer des limites sûres à la solution manuelle
Une procédure manuelle doit rester une exception contrôlée, et non devenir une voie parallèle sans supervision. Avant de l’activer, définissez les rôles autorisés à intervenir, les actions permises et la durée pendant laquelle la procédure peut être utilisée. Les autorisations doivent être proportionnées au risque : toute personne chargée d’examiner un cas n’a pas nécessairement besoin de pouvoir l’approuver ou le modifier.
Déterminez également quelles preuves doivent être consignées. Au minimum, conservez l’opération concernée, les informations disponibles à ce moment-là, la décision prise, l’identité de la personne qui l’a prise et la date. Si une personne saisit une donnée provisoire, précisez son origine et indiquez si elle devra être confirmée ultérieurement. Séparez les faits reçus du service des décisions humaines ; cette distinction facilite l’audit et la correction.
La solution de remplacement doit être assortie d’une limite de temps ou d’une condition de clôture. Par exemple, elle peut cesser d’être utilisée lorsque la file atteint la capacité définie par les équipes opérationnelles, lorsqu’une autorisation expire ou lorsque la dépendance redevient disponible. Ne choisissez pas de seuil universel : adaptez-le au volume, au coût de l’examen et au risque d’accumuler des tâches non résolues. Si les capacités sont insuffisantes, bloquer de nouvelles opérations peut être plus sûr que de créer une dette opérationnelle invisible.
Définir les conditions de reprise et le rapprochement des tâches en attente
Le simple fait qu’une API réponde à nouveau ne prouve pas qu’il soit sûr de traiter tout ce qui s’est accumulé. Définissez des signaux de rétablissement adaptés à la dépendance et au processus : disponibilité maintenue pendant une période définie par l’équipe, réponses valides pour les opérations nécessaires et absence d’écarts qui obligeraient à interrompre la reprise. Le critère doit pouvoir être vérifié et ne pas dépendre d’une impression.
Avant de reprendre le traitement, déterminez quoi faire de chaque état en attente. Certains cas peuvent être retraités automatiquement ; pour d’autres, il faut vérifier si l’opération a été partiellement effectuée ou si une personne l’a résolue manuellement. Évitez les actions en double : identifiez les opérations de manière à ce que le système puisse reconnaître celles qui ont déjà été réalisées et celles qui sont toujours en cours. Si vous ne pouvez pas confirmer l’état final, transmettez le cas pour examen au lieu de supposer qu’une nouvelle tentative est sans risque.
Le rapprochement doit comparer ce qui était attendu à ce qui s’est réellement passé : tâches reçues, décisions manuelles, opérations achevées et erreurs encore ouvertes. Définissez qui valide la clôture et comment corriger les données divergentes. Le rétablissement ne s’achève donc pas lorsque le fournisseur redevient disponible, mais lorsque le processus interne retrouve un état cohérent.
Tester les scénarios et revoir la politique
Testez l’indisponibilité dans un environnement contrôlé et parcourez le processus du point de vue de l’utilisateur et des équipes opérationnelles. Incluez des réponses tardives, des données incomplètes, un rétablissement intermittent et une panne survenant pendant une opération. L’objectif n’est pas de tester une liste générique de défaillances, mais de vérifier que chaque décision documentée est appliquée et que les personnes responsables savent ce qu’elles doivent faire.
Surveillez les signes révélateurs d’un problème de conception : des cas indiqués comme terminés sans réponse valide, des files manuelles qui grossissent sans responsable, des utilisateurs qui répètent une opération faute de connaître son état ou des tâches en attente qui ne sont pas rapprochées après le rétablissement. Examinez également les effets sur les délais de traitement, la qualité des données et la charge de travail supplémentaire. Si une solution de remplacement génère plus de risques ou de coûts que l’attente, modifiez la politique.
Actualisez les décisions lorsque le processus, le fournisseur, les autorisations ou l’impact d’une opération évoluent. Une procédure de continuité adaptée à une fonction informative peut ne plus convenir si celle-ci déclenche désormais une action aux conséquences plus importantes. La révision doit associer les équipes produit, technologie et opérations, ainsi que les autres équipes concernées lorsque le risque l’exige.
Liste de contrôle pour chaque dépendance
- Quels processus et quelles décisions dépendent de ce service externe ?
- Quelles sont les conséquences de l’arrêt, du report ou de l’exécution d’une opération sans toutes les données ?
- Quelles conditions justifient un blocage, un fonctionnement dégradé ou la transmission à une personne ?
- Quelles autorisations, limites de durée et traces la procédure manuelle exige-t-elle ?
- Qui traite les cas en attente et à quel moment la charge doit-elle être escaladée ?
- Quels signaux vérifiables autorisent la reprise du traitement ?
- Comment identifier les doublons, les états partiels et les décisions manuelles ?
- Quels tests et quelles révisions permettent de maintenir la politique à jour ?
Répondre à ces questions permet de transformer une dépendance externe en décision explicite de produit et d’exploitation. La politique appropriée ne supprime pas les pannes : elle en limite les effets, rend les exceptions visibles et fournit un moyen vérifiable de reprendre le travail normalement.