

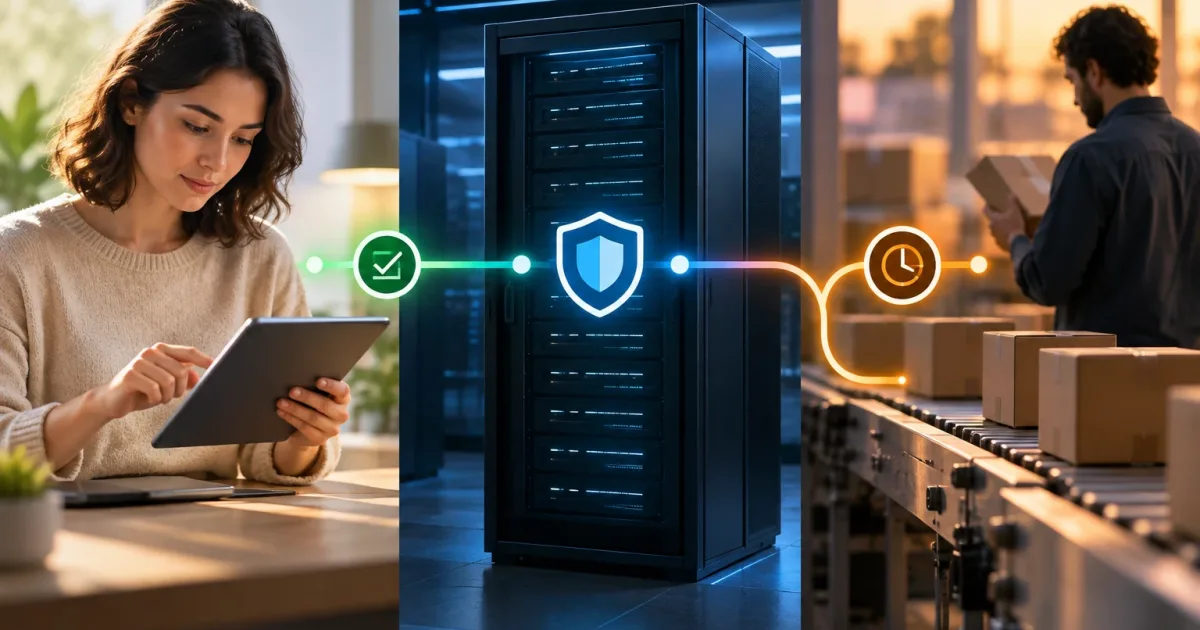
Choisir où valider les données n’est pas qu’une décision technique : cela influe sur l’expérience utilisateur, l’intégrité métier et le coût d’exploitation de l’application. Afficher une erreur rapidement facilite le remplissage d’un formulaire, mais ne garantit pas qu’une opération soit valide. À l’inverse, reporter toutes les vérifications au serveur peut protéger les données, sans éviter les attentes et les frustrations inutiles.
La solution la plus solide consiste à confier chaque règle à la couche qui dispose des informations et de l’autorité nécessaires pour l’appliquer. L’interface guide la saisie ; le serveur protège les règles métier ; les processus asynchrones prennent en charge les vérifications lentes ou dépendantes de services externes. Dans de nombreux parcours, ces trois couches collaborent.
Pourquoi une seule couche ne suffit généralement pas
Une validation effectuée uniquement dans l’interface peut être rapide et claire, mais elle peut être contournée en appelant directement une API, en modifiant la requête ou en utilisant un autre client. Elle ne doit donc jamais constituer l’unique protection d’une règle qui préserve les données ou les décisions métier.
À l’inverse, tout vérifier après l’envoi oblige les personnes à attendre pour découvrir des erreurs simples, comme un champ obligatoire laissé vide ou une adresse e-mail mal formatée. Certaines vérifications prennent aussi plus de temps qu’une requête classique ou dépendent de systèmes momentanément indisponibles.
La bonne question n’est pas « quelle couche valide les données ? », mais « quelle couche offre le meilleur équilibre entre rapidité, autorité et contexte pour chaque règle ? » Par exemple, une règle de longueur peut être signalée dans le navigateur, puis vérifiée à nouveau par le serveur. L’interface améliore l’interaction ; le serveur reste celui qui accepte ou rejette la donnée.
Interface : un retour immédiat, pas une autorité finale
La validation dans l’interface sert à repérer rapidement les problèmes que l’on peut expliquer sans consulter de sources externes : champs vides, limites de caractères, formats simples ou combinaisons élémentaires. Elle réduit les tentatives infructueuses et aide à comprendre ce qu’il faut corriger avant d’envoyer le formulaire.
Pour être utile, le message doit apparaître près du champ concerné ou dans un récapitulatif accessible. Il doit expliquer le problème et proposer une manière de le résoudre. Évitez les erreurs prématurées qui interrompent une personne alors qu’elle est encore en train de saisir son texte. Une pratique raisonnable consiste à vérifier le champ lorsque la personne le quitte ou lorsqu’elle envoie le formulaire, puis à actualiser le message si la valeur change.
L’interface peut aussi rappeler des contraintes connues, comme le format attendu pour une date. Toutefois, une action ne doit pas être considérée comme valide simplement parce que le formulaire l’accepte. Le navigateur peut être obsolète, le client peut être modifié et la requête peut arriver par un autre moyen.
- Utilisez-la pour fournir un retour rapide et appliquer des règles simples qui facilitent la saisie.
- N’en dépendez pas pour l’autorisation, les permissions, les prix définitifs ou l’intégrité des enregistrements.
- Expliquez clairement les limites et évitez les messages qui exposent des informations sensibles.
Serveur : l’autorité en matière de règles métier
Le serveur doit revérifier toute condition dont la violation pourrait modifier les données, accorder un accès indu ou entraîner une décision incorrecte. Cela inclut de vérifier que la personne est autorisée à effectuer l’opération, que les valeurs correspondent au contexte permis et que les changements d’état sont acceptables.
La vérification doit avoir lieu au moment où la donnée est acceptée ou modifiée, et non uniquement dans un écran particulier. Si plusieurs applications utilisent la même API, le serveur fournit une politique commune. Il doit également gérer les problèmes de concurrence : deux requêtes peuvent se disputer une ressource ou tenter de modifier le même enregistrement.
La validation côté serveur ne dispense pas de fournir des messages compréhensibles. Lorsque cela ne présente pas de risque, la réponse doit distinguer une donnée mal formée, une règle métier non respectée et un défaut d’autorisation. Évitez de renvoyer des détails internes, des requêtes, des traces ou des informations susceptibles de faciliter une attaque. Les recommandations de l’OWASP concernant la validation des entrées constituent une référence utile : les données reçues doivent être considérées comme non fiables.
Règle pratique : si le résultat protège une décision ou l’intégrité du système, le serveur a le dernier mot, même si l’interface applique une vérification équivalente pour simplifier le parcours.
Processus asynchrones : dépendances externes et résultats différés
Certaines règles ne peuvent pas être vérifiées localement ou au moyen d’une seule requête rapide. La vérification d’une adresse par un service externe, l’analyse d’un fichier ou un examen qui demande du temps peuvent laisser la demande initiale en attente.
Dans ce cas, séparez l’acceptation de la demande de son résultat définitif. Le système peut confirmer qu’il a reçu l’opération et indiquer qu’elle est en cours, sans affirmer qu’elle est déjà valide. Une fois la vérification terminée, il doit mettre à jour l’état et communiquer le résultat par un moyen adapté au produit, par exemple une page de suivi ou une notification.
Prévoyez aussi les scénarios d’échec : que se passe-t-il si le service externe ne répond pas, renvoie un résultat non concluant ou revient en ligne après une interruption ? Définissez des délais d’attente, des tentatives de nouvelle exécution raisonnables et une procédure de vérification ou de reprise. Un dépassement du délai ne prouve pas que la donnée est invalide ; il peut simplement signifier que la vérification n’a pas pu aboutir.
Si le résultat peut arriver après que la personne a quitté l’écran, l’état doit rester consultable. Évitez qu’une réponse tardive remplace une modification plus récente : associez le résultat à l’opération ou à la version qui a été vérifiée.
Déterminer où appliquer chaque règle
Pour chaque validation, posez-vous quatre questions : combien coûte une erreur ? De quelles informations la vérification a-t-elle besoin ? Dans quel délai ces informations sont-elles disponibles ? Qui a l’autorité nécessaire pour trancher ? Ces questions aident à distinguer des règles souvent confondues dans un même formulaire.
- Expérience : si la vérification est simple et que l’erreur peut être corrigée immédiatement, affichez-la dans l’interface.
- Sécurité et intégrité : si elle concerne les permissions, des données enregistrées ou une décision financière, appliquez-la sur le serveur.
- Dépendances et latence : si elle nécessite un service distant ou une analyse longue, indiquez que le traitement est en attente et gérez le résultat par la suite.
- Coût de l’erreur : plus les conséquences d’une valeur incorrecte sont importantes, plus les contrôles et la traçabilité sont nécessaires.
Une règle peut nécessiter plusieurs couches, mais chacune n’a pas besoin de l’appliquer avec le même niveau de détail. L’interface peut vérifier qu’un champ n’est pas vide ; le serveur peut également appliquer des restrictions liées au contexte et aux permissions. Cette redondance est utile si chaque vérification répond à un objectif clair.
Assurer la cohérence sans faire diverger les règles
Répéter une règle présente un risque : elle peut être mise à jour dans une couche, mais pas dans une autre. L’interface peut alors accepter une valeur que le serveur rejette, ou bloquer une valeur pourtant valide. Pour limiter ces écarts, définissez les règles métier à partir d’une source de référence identifiable et établissez des contrats clairs entre le client et l’API.
Lorsque l’architecture le permet, des schémas ou des composants de validation peuvent être partagés entre le client et le serveur. Cela ne fait pas du client une autorité : le serveur doit exécuter la vérification à sa propre frontière de confiance. Si le partage de l’implémentation est impossible, documentez les critères, les cas limites et les réponses attendues, puis ajoutez des tests des deux côtés.
Accordez une attention particulière aux règles qui évoluent ou qui dépendent de l’utilisateur, de la région, de l’état d’un compte ou de la disponibilité d’une ressource. Ne codez pas en dur dans l’interface des décisions que le serveur peut modifier. Si des contraintes informatives sont transmises au client, considérez-les comme des indications potentiellement obsolètes.
Des erreurs qui indiquent la marche à suivre
Un message d’erreur utile désigne la donnée concernée, explique le problème sans jargon et propose une prochaine étape. Si la correction est possible avant l’envoi, associez le message au champ concerné. Si l’opération est déjà en cours, expliquez son état général et indiquez comment consulter le résultat ou relancer l’action. Pour éviter les doublons lors d’une nouvelle tentative, prévoyez le cas où la première requête a été traitée, mais où sa réponse n’est pas parvenue au client.
N’utilisez pas un message associé à un champ pour une situation qui dépend de l’état général du processus. Par exemple, si une ressource n’est plus disponible, expliquez ce qui a changé et proposez des solutions de remplacement, plutôt que de signaler uniquement un format de champ incorrect. S’il n’est pas prudent de révéler la raison exacte, fournissez une explication neutre et un moyen de poursuivre.
Liste de contrôle avant le lancement
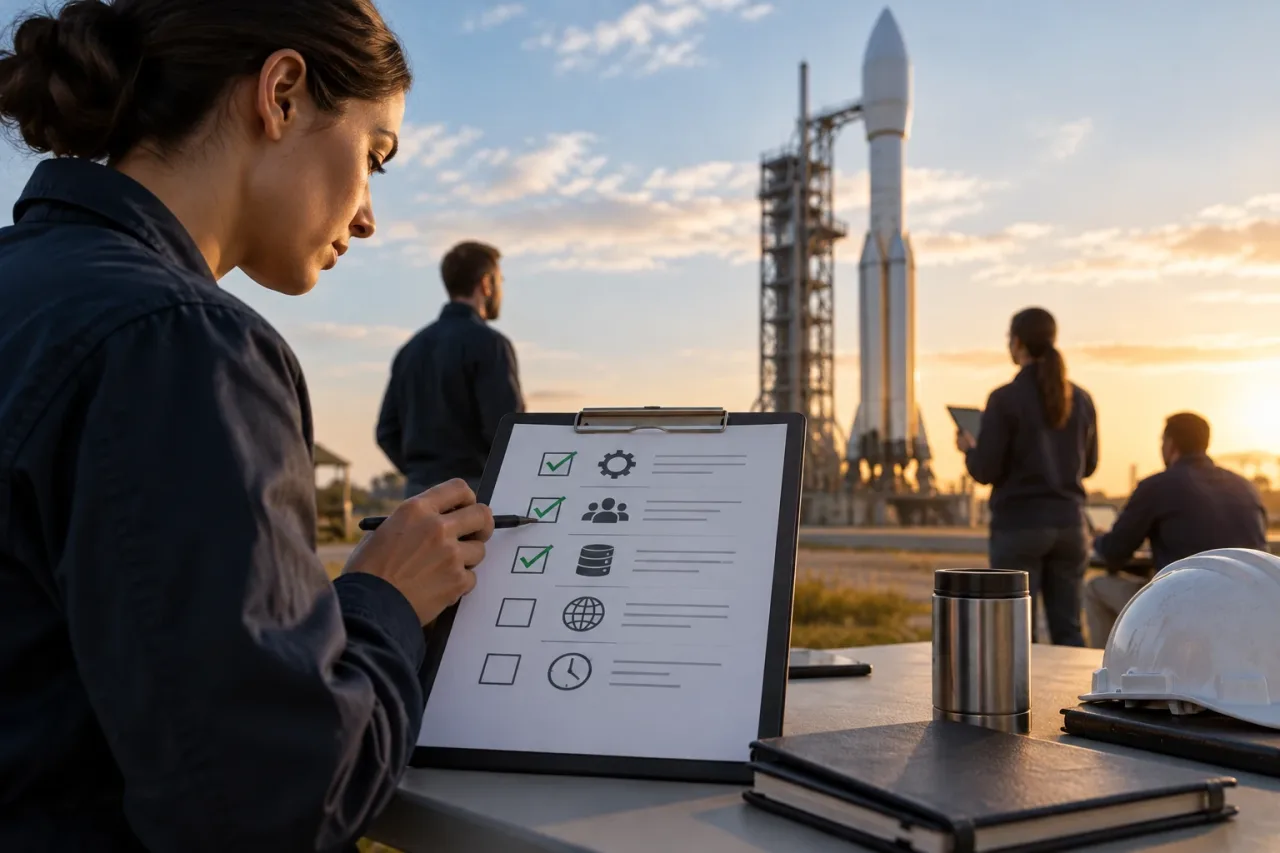
- Énumérez les règles et indiquez si elles concernent le format, les affaires, l’autorisation ou une dépendance externe.
- Vérifiez que chaque règle critique est contrôlée par le serveur avant l’acceptation de la modification.
- Assurez-vous que les messages de l’interface sont opportuns, accessibles et permettent de corriger le problème.
- Définissez les états d’attente, les échecs temporaires, les nouvelles tentatives et la gestion des réponses tardives.
- Testez les appels directs à l’API, les valeurs limites, les permissions et les modifications concurrentes.
- Vérifiez que les erreurs n’exposent pas de données internes et indiquent la prochaine étape.
- Désignez les personnes chargées de mettre à jour les règles partagées lorsque le produit évolue.
La meilleure conception ne consiste ni à tout valider partout, ni à toujours attendre le serveur. Associez un retour rapide à une autorité clairement définie et à une gestion explicite des vérifications différées. L’application est ainsi plus facile à comprendre et plus résistante aux données invalides, aux changements de contexte et aux défaillances des dépendances.