

Quand un produit évolue, la manière dont il représente ses données peut elle aussi changer : un champ est renommé, une entité est divisée ou une nouvelle règle métier est introduite. La décision n’est pas uniquement technique. Il faut choisir entre mettre à jour les enregistrements existants, adapter les données à chaque consultation ou conserver les deux formats pendant une période de transition.
La question utile est de savoir quand migrer les données et quand les transformer à la lecture. La réponse dépend des personnes et des systèmes qui consomment les informations, du niveau de cohérence dont le produit a besoin et du coût de maintenance de la solution. Aucune approche n’est universellement meilleure : l’objectif est de rendre leurs compromis explicites et de définir comment vérifier leur efficacité.
Ce qui change selon l’approche choisie
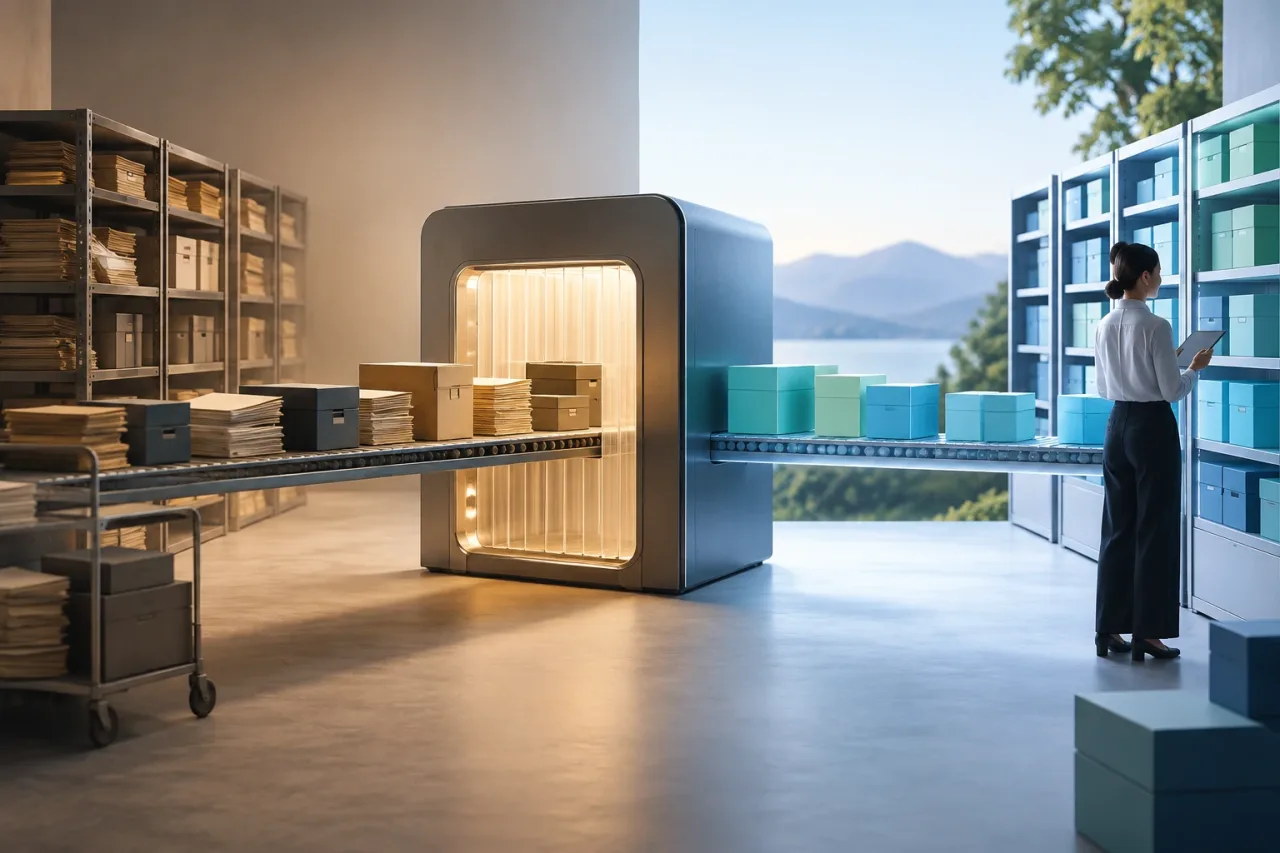
Une migration persistante modifie les données stockées afin de les rendre conformes au nouveau modèle. Elle peut être exécutée lors d’une opération contrôlée ou par lots, selon le volume, l’infrastructure et les exigences de disponibilité. Ensuite, les requêtes utilisent la nouvelle représentation, même si elles doivent parfois reconnaître les anciens enregistrements pendant la transition.
La transformation à la lecture conserve les données d’origine et les adapte au moment de les restituer. Une couche d’accès, un service ou une requête peut convertir l’ancien format en structure attendue par le consommateur actuel. Cette méthode assure une compatibilité sans imposer immédiatement une modification massive, mais elle alourdit les lectures et ajoute une logique qu’il faudra maintenir.
Il existe aussi une solution intermédiaire : conserver temporairement les deux formats et procéder à une migration progressive. Par exemple, l’application peut lire le nouveau format et, s’il n’existe pas, convertir l’ancien ; les nouvelles écritures utilisent déjà le format mis à jour. Cette stratégie nécessite des règles claires afin d’éviter que chaque consommateur implémente sa propre variante.
Les critères de décision
Avant de choisir, décrivez le changement sous la forme d’un besoin observable : quelles données évoluent, qui les utilise et quel comportement doit être préservé ? Évaluez ensuite les critères suivants :
- Cohérence : si tous les consommateurs doivent voir les mêmes valeurs et appliquer les mêmes règles, une représentation persistante commune peut réduire les divergences. Si la conversion est propre à une interface ou à un consommateur, une couche de lecture peut être plus adaptée.
- Fréquence et coût des lectures : une transformation répétée sur un parcours très utilisé peut augmenter la latence et la consommation de ressources. Si les lectures sont rares ou le jeu de données limité, ce coût peut être acceptable ; mesurez-le dans son contexte réel.
- Volume et exploitation : une migration complète peut demander du temps, une gestion des erreurs et une capacité à traiter les enregistrements sans interrompre le service. Pour les grands volumes, envisagez des lots et un suivi de progression plutôt que de supposer qu’une opération unique sera sans risque.
- Nombre de consommateurs : avec plusieurs services, applications, rapports ou intégrations, une modification du stockage peut entraîner des effets en chaîne. Identifiez les dépendances au schéma et vérifiez si tous les systèmes peuvent être mis à jour de manière coordonnée.
- Réversibilité : la transformation à la lecture conserve les données sources, ce qui peut faciliter le retour au comportement précédent. Une migration destructive exige une sauvegarde ou un mécanisme de récupération éprouvé, ainsi qu’un plan couvrant les changements ultérieurs.
- Règles métier : si la conversion dépend de décisions susceptibles d’évoluer, conserver les données d’origine permet de les réévaluer. Si la nouvelle forme représente un fait stable, nécessaire à tous, la persistance peut simplifier le système.
Ne comparez pas seulement le coût d’exécution de la migration à celui de la création d’un adaptateur. Prenez aussi en compte les coûts récurrents : requêtes plus complexes, observabilité, tests, prise en charge des anciennes versions et retrait futur de la compatibilité.
Quand privilégier une migration
Une migration persistante devient souvent intéressante lorsque le nouveau modèle doit rester la représentation principale pendant une longue période, lorsque de nombreux consommateurs ont besoin de la même transformation ou lorsque le travail d’adaptation a un effet mesurable sur la latence. Elle peut également être préférable si la logique de lecture s’est dispersée à plusieurs endroits et qu’il n’existe plus de définition unique et fiable.
À l’inverse, une transformation à la lecture peut convenir si le changement est temporaire, si l’ancien format doit être conservé, si peu de consommateurs sont concernés et contrôlés, ou si les règles du nouveau modèle sont encore en cours de validation. Cette approche peut aussi être utile lorsque le coût ou le risque d’une écriture massive en production dépasse le bénéfice immédiat, à condition que les performances restent acceptables et que la compatibilité soit limitée.
Certains signes montrent qu’une solution temporaire se transforme en dette : des conditions spécifiques à chaque version historique, des requêtes qui mélangent les formats sans règle commune, des erreurs différentes selon les consommateurs et des tests qui ne couvrent pas toutes les variantes. Dans ce cas, ajouter une nouvelle exception ne suffit pas. Il faut décider quel format fera foi et fixer une date ou une condition vérifiable pour retirer les anciens formats.
Organiser une transition progressive
Une migration progressive réduit les risques en séparant le déploiement de l’application du traitement de l’ensemble des enregistrements. Un plan pratique peut suivre ces étapes :
- Inventorier les dépendances. Repérez les producteurs, les consommateurs, les tâches planifiées, les rapports et les contrats d’intégration qui utilisent le modèle concerné. Précisez qui est responsable de chacun.
- Définir la compatibilité. Documentez les formats acceptés, la source de vérité et le comportement attendu lorsqu’un champ manque ou qu’une valeur inattendue apparaît. Évitez les déductions silencieuses qui masquent des données invalides.
- Déployer des lecteurs compatibles. Vérifiez que l’application sait traiter les anciennes et les nouvelles données avant de commencer à écrire le nouveau format. Vous éviterez ainsi qu’une version antérieure échoue face à des enregistrements mis à jour.
- Modifier les écritures. Faites en sorte que les nouvelles opérations produisent le format cible. Si deux représentations sont écrites pendant une période, définissez laquelle prévaut et comment les divergences seront détectées.
- Traiter les données existantes. Exécutez la migration de façon contrôlée en consignant la progression et les erreurs. Adaptez la taille des lots au système et concevez l’opération pour qu’elle puisse reprendre sans produire d’effets en double.
- Retirer la compatibilité. Supprimez la prise en charge de l’ancien format uniquement lorsque les métriques et les vérifications confirment qu’aucun consommateur ni enregistrement n’en dépend encore.
L’ordre exact peut varier. Dans les systèmes soumis à de fortes exigences de disponibilité, les étapes de lecture et d’écriture sont généralement déployées de manière compatible avant la modification des données. La décision doit tenir compte du comportement des anciennes versions susceptibles de rester actives pendant le déploiement.
Valider les résultats et préparer le retour arrière
Avant de migrer l’ensemble des données, testez la conversion sur un échantillon représentatif et comparez les résultats. Vérifiez les décomptes, les champs obligatoires, les valeurs limites, les relations entre entités et les règles métier. Un nombre d’enregistrements identique ne prouve pas à lui seul que la transformation est correcte : comparez aussi les valeurs et le comportement pour les cas pertinents.
Si possible, commencez par une comparaison qui ne modifie pas le résultat visible par l’utilisateur. Consignez les différences entre l’ancienne et la nouvelle représentation, classez les écarts et fixez des seuils d’acceptation avant d’étendre le traitement. Surveillez les erreurs, la latence et la charge pendant l’opération, et déterminez clairement qui peut décider de la suspendre.
Le retour arrière doit prendre en compte les écritures effectuées après le changement. Restaurer une sauvegarde antérieure peut supprimer des mises à jour valides ; déterminez donc s’il est possible de revenir à l’ancien lecteur sans restaurer les données, ou s’il faut une stratégie de rapprochement des changements. Testez cette procédure avant de vous y fier.
Liste de vérification pour prendre une décision
- Le format de référence et la source de vérité sont-ils identifiés ?
- Combien de consommateurs dépendent du schéma et qui est responsable de chacun ?
- L’effet de la transformation à la lecture sur la latence et les ressources a-t-il été mesuré ?
- La logique temporaire est-elle centralisée, testée et assortie de conditions de retrait ?
- La migration peut-elle être suspendue, reprise et contrôlée pour repérer les enregistrements en échec ?
- Les comparaisons, les seuils d’acceptation et les responsables de la validation des résultats sont-ils définis ?
- Existe-t-il un retour arrière sûr qui prend en compte les nouvelles écritures ?
Choisissez la transformation à la lecture lorsque la compatibilité est limitée, réversible et acceptable sur le plan opérationnel. Choisissez la migration lorsque le nouveau modèle doit être commun, persistant et plus simple à utiliser, et qu’un plan sûr permet de mettre les données à jour. Si des incertitudes subsistent, adoptez une transition temporaire avec des métriques, un responsable et un critère de sortie : reporter une migration peut être une décision valable ; la reporter sans échéance ni contrôle rend la compatibilité permanente.