

Lorsqu’un CRM, un ERP, une boutique en ligne et plusieurs automatisations partagent des informations, il ne suffit pas de décider quel système fait foi. Cette décision peut indiquer où consulter une donnée, mais elle ne précise pas toujours qui est autorisé à la modifier, à quel moment ni ce qui se passe si un autre système l’a déjà changée.
Le problème se manifeste dans les opérations quotidiennes : une intégration importe à nouveau une ancienne adresse, une automatisation remplace une correction manuelle ou deux processus mettent à jour le statut d’une commande selon des interprétations différentes. Pour prévenir ces situations, il faut définir les responsabilités pour chaque donnée et chaque processus, plutôt que d’accorder une autorité sans distinction à une application entière.
L’objectif est que chaque modification obéisse à une règle compréhensible : quel système ou quelle personne peut modifier le champ, sous quelles conditions, comment traiter les exceptions et quelles informations conserver pour comprendre ce qui s’est passé.
Pourquoi une source de vérité ne suffit pas à éviter les conflits
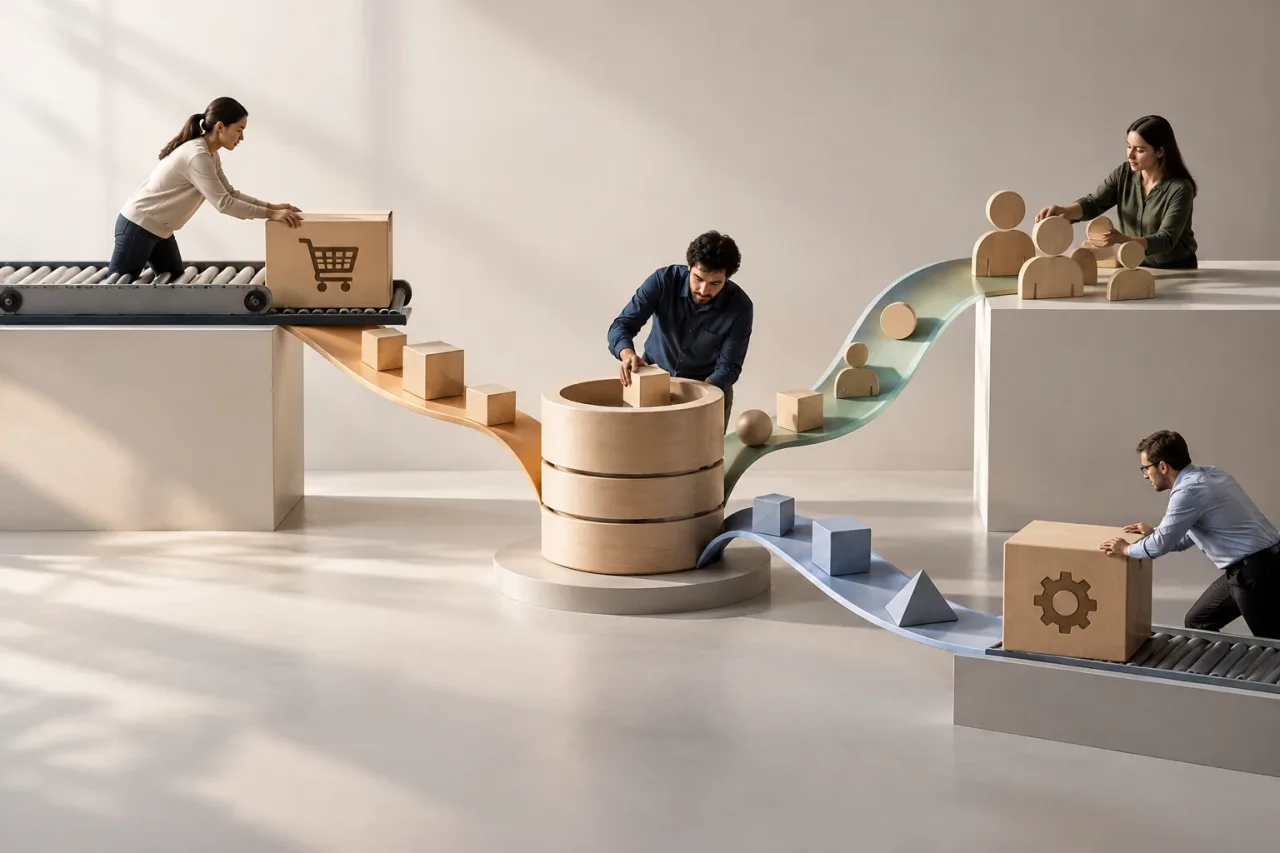
Une source de vérité désigne l’emplacement de référence pour une donnée ou un ensemble de données. Cependant, elle peut recevoir des informations de plusieurs systèmes sans préciser quelle mise à jour doit prévaloir. Les systèmes peuvent aussi remplir des fonctions différentes : le commerce en ligne enregistre une demande, le CRM gère la relation client et l’ERP contrôle la facturation.
Il est donc utile de distinguer trois questions :
- Où consulter la donnée officielle ? Cette question définit la référence que les autres processus doivent lire.
- Qui peut la modifier ? Elle définit l’autorité d’écriture, qui peut varier selon le champ.
- Quelle version est affichée dans chaque interface ? Elle concerne la présentation de la donnée, qui ne signifie pas nécessairement que l’application est autorisée à la modifier.
Une application peut afficher une adresse de livraison et permettre à une personne de la modifier sans être responsable de l’adresse de facturation. Une autre peut recevoir cette modification et la valider avant de la transmettre. Confondre ces fonctions favorise des règles trop générales, comme « le CRM l’emporte toujours », même si le changement n’a pas été effectué dans le CRM.
Attribuer l’autorité par champ et par étape du processus
En pratique, la décision ne concerne pas seulement le système : elle porte sur le champ à une étape précise du processus. L’acheteur peut, par exemple, modifier l’adresse de livraison avant la préparation de la commande ; cette adresse peut ensuite être verrouillée lorsque le colis est en cours d’expédition. L’autorité dépend du contexte et du moment, et pas uniquement du nom du champ.
Documentez chaque donnée importante dans une matrice comprenant notamment les éléments suivants :
- Champ : la donnée exacte, avec une définition partagée et, si nécessaire, son format.
- Responsable de l’écriture : le système, le rôle ou le processus autorisé à la modifier.
- Condition : l’étape, le statut ou la validation nécessaires pour accepter la modification.
- Systèmes lecteurs : les systèmes qui reçoivent ou affichent la valeur.
- Exceptions et résolution : la marche à suivre en cas de correction manuelle, de conflit ou de donnée invalide.
- Journalisation : les informations minimales nécessaires pour reconstituer la modification.
Commencez par les champs ayant le plus fort impact opérationnel : identifiants, statuts de commande, prix, données de facturation, adresses et consentement à être contacté. Il n’est pas nécessaire de définir dès le premier jour une politique exhaustive pour chaque champ secondaire. Il faut toutefois éviter toute ambiguïté pour les données dont la modification peut affecter les paiements, la livraison, la conformité ou le service client.
Pour chaque champ, formulez une règle vérifiable : « L’ERP peut modifier le statut de facturation après validation du paiement ; le commerce en ligne l’affiche, mais ne le remplace pas. » Si la règle comprend des expressions vagues comme « en général » ou « le système le plus récent », précisez comment déterminer ce que ces termes signifient.
Autorisations, exceptions et corrections manuelles
Une bonne politique ne cherche pas à supprimer toutes les exceptions. Elle précise qui peut les autoriser et comment préserver la cohérence par la suite. Une équipe d’assistance pourrait, par exemple, corriger une donnée après vérification d’une demande. Cette possibilité doit être délimitée selon le rôle, le champ et l’état du processus. Accorder des droits d’écriture à toute l’équipe ou à l’intégralité de l’intégration transforme une exception en source permanente de conflits.
Avant d’autoriser une correction manuelle, déterminez :
- Quelle identité ou quel rôle peut l’effectuer et quelles vérifications sont requises.
- Quels champs peuvent être modifiés et lesquels nécessitent une approbation.
- Si la modification est propagée automatiquement ou doit être examinée.
- Quels systèmes doivent être mis à jour et comment signaler un échec de propagation.
- Quelle marche à suivre adopter si le processus a déjà avancé et que la modification n’est plus sûre.
Il est également utile de distinguer la valeur d’origine, la valeur corrigée et le motif de l’intervention. Si une modification manuelle ne peut pas être propagée, ne la supprimez pas silencieusement et ne marquez pas le processus comme terminé. Conservez le statut d’erreur et désignez une personne responsable de sa résolution.
Gérer les modifications simultanées et les mises à jour tardives
Les mises à jour peuvent arriver dans le désordre : une connexion lente transmet une ancienne modification après une mise à jour plus récente, ou deux systèmes modifient le même champ avant de recevoir la mise à jour de l’autre. Choisir automatiquement « le dernier message reçu » peut conduire à une erreur, car l’ordre de réception ne prouve pas quelle modification est valide.
Définissez une stratégie adaptée au niveau de risque :
- Un seul système d’écriture : limitez les modifications à un seul système ou processus. C’est la solution la plus simple lorsqu’un responsable est clairement identifié et qu’une modification distribuée n’est pas nécessaire.
- Priorité selon le statut : n’acceptez les modifications qu’aux étapes autorisées. Cette approche est utile lorsque l’autorité passe d’un processus à un autre, par exemple lors de la confirmation ou de l’expédition d’une commande.
- Contrôle de version : rejetez ou mettez en examen une mise à jour fondée sur une version antérieure. Cette méthode suppose que les systèmes puissent comparer une version ou un état précédent.
- Résolution supervisée : consignez le conflit et demandez une décision humaine. Cette option convient lorsque le coût d’écrasement d’une donnée légitime est supérieur à celui de son examen.
La politique peut combiner plusieurs méthodes. Une adresse peut être modifiée par le client avant la préparation de la commande, puis nécessiter une intervention. L’essentiel est de définir ce qui se passe lorsque la condition n’est pas remplie : rejeter la modification, la garder en attente, déclencher une alerte ou demander une approbation. Évitez de transformer une règle de gestion des conflits en remplacement silencieux.
Consigner l’origine et le motif pour faciliter le diagnostic
Lorsqu’une valeur change de manière inattendue, l’équipe doit pouvoir déterminer qui l’a modifiée, quel système l’a transmise et quelle règle a permis de l’accepter. Selon les besoins et les capacités disponibles, consignez le champ concerné, l’ancienne et la nouvelle valeur, l’horodatage, la source, l’identité ou le processus responsable, le résultat de la validation et, le cas échéant, le motif.
Ce journal ne sert pas uniquement à examiner les incidents. Il aide à repérer les intégrations qui renvoient des informations obsolètes, les automatisations qui écrivent dans des champs au mauvais stade et les équipes qui recourent fréquemment aux exceptions. Définissez qui peut consulter ces journaux et combien de temps ils sont conservés, en fonction des besoins opérationnels et des obligations applicables.
Liste de contrôle avant d’activer une intégration
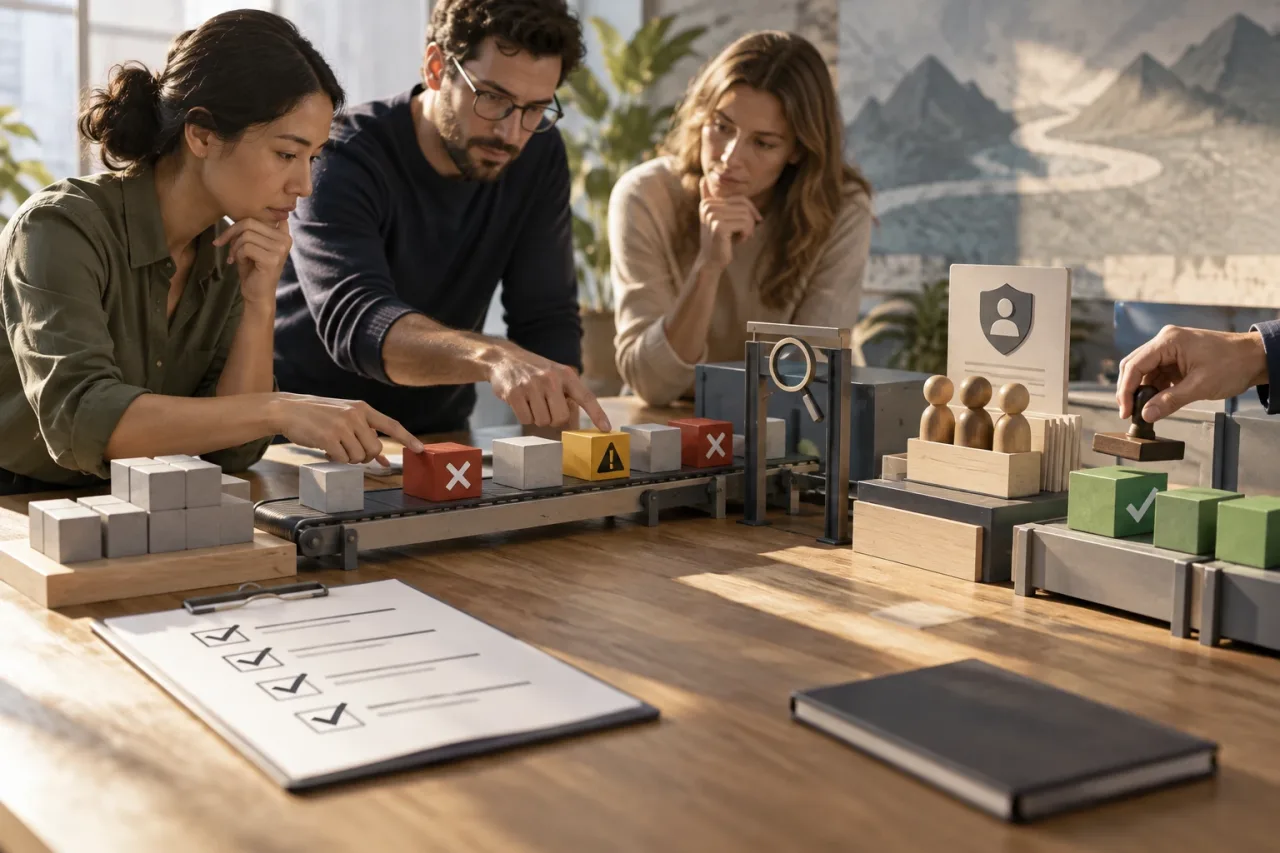
- Chaque champ critique et sa signification sont-ils définis pour toutes les équipes ?
- La distinction est-elle claire entre le système qui affiche la donnée et celui qui est autorisé à la modifier ?
- La règle précise-t-elle le système responsable de l’écriture, la condition et l’étape du processus ?
- Les corrections manuelles, leurs responsables et leurs contrôles sont-ils délimités ?
- La marche à suivre est-elle définie pour les données en double, invalides ou reçues dans le désordre ?
- Les modifications rejetées ou en attente donnent-elles lieu à un statut visible et à la désignation d’un responsable ?
- Est-il possible de reconstituer l’origine et le motif des modifications importantes ?
- Une révision est-elle prévue pour actualiser les règles lorsque les systèmes ou le processus changent ?
Commencez par un projet pilote portant sur les champs les plus risqués et observez les rejets, les conflits et les corrections. Si une équipe doit intervenir à répétition, vérifiez si l’autorité a été attribuée au mauvais processus ou si une exception documentée fait défaut. Le but n’est pas d’empêcher les données de changer, mais de garantir que chaque modification s’effectue selon une autorité, un contexte et des conséquences définis.