

Choisir entre une intégration unidirectionnelle ou bidirectionnelle ne consiste pas seulement à tracer une flèche entre deux applications. C’est une décision concernant la propriété des données, les responsabilités opérationnelles et la tolérance au risque. Une connexion apparemment simple entre un CRM, un ERP, un site e-commerce ou une plateforme de service client peut produire des doublons, des écrasements et des erreurs d’état si les deux systèmes modifient la même information sans règles explicites.
La règle initiale est simple : ne synchronisez dans les deux sens que lorsqu’un processus réel exige que les deux systèmes modifient le même domaine de données. Le fait que deux applications puissent échanger des informations ne signifie pas qu’elles doivent le faire. Réduire le nombre de flux et de champs modifiables diminue généralement le coût de maintenance, les incidents et les décisions manuelles ultérieures.
Ce qui change entre une intégration unidirectionnelle et bidirectionnelle
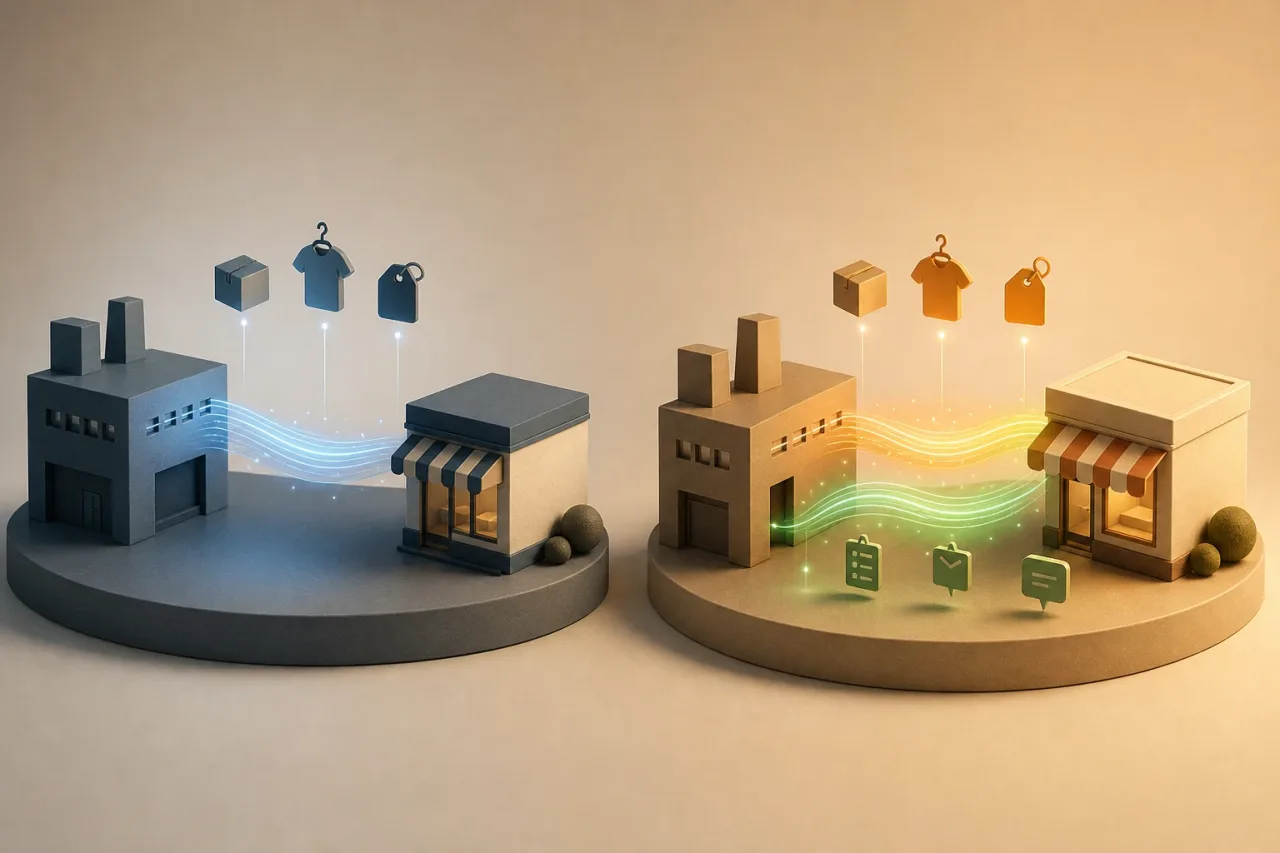
Dans une intégration unidirectionnelle, un système publie ou envoie des informations et l’autre les reçoit, les réplique ou les consulte. Par exemple, un ERP peut envoyer le catalogue, la disponibilité et les prix vers un site e-commerce. Le site e-commerce reçoit ces valeurs, mais ne les corrige pas et ne les renvoie pas à l’ERP.
Dans une intégration bidirectionnelle, chaque système peut générer des modifications qui se répercutent dans l’autre. Un cas typique est la commande : le site e-commerce la crée, l’ERP met à jour sa préparation ou sa facturation, et le site e-commerce doit refléter cet état pour informer le client. La bidirectionnalité peut être appropriée pour cet objet, mais cela n’implique pas que tous ses champs doivent l’être.
Il convient d’éviter une classification globale du type « l’intégration est bidirectionnelle ». La décision utile se prend par entité, champ et opération :
- Entité : client, commande, produit, facture, ticket ou stock.
- Opération : créer, mettre à jour, annuler, archiver ou consulter.
- Champ : adresse e-mail, adresse de livraison, statut, prix, identifiant fiscal ou consentement.
Ainsi, une intégration peut être unidirectionnelle pour les prix, bidirectionnelle pour les statuts de commande et en consultation seule pour les factures. Ce niveau de détail évite qu’une modification légitime sur un canal écrase une information qui appartient à un autre.
Commencez par la propriété des données, pas par l’API disponible
Avant d’évaluer les webhooks, les tâches planifiées ou les capacités d’une API, l’équipe doit établir une cartographie de la propriété. Pour chaque donnée importante, déterminez qui la crée, qui peut la modifier, où elle est validée et quelle application doit l’afficher.
- Identifiez le système maître. Il s’agit de la source de référence en cas de divergence. Ce n’est pas nécessairement le système où la donnée est affichée le plus souvent.
- Séparez les données maîtres et les données opérationnelles. Un ERP peut être maître des références, des taxes et de la disponibilité, tandis que le site e-commerce est maître du canal d’achat, du panier et de l’adresse confirmée lors du paiement.
- Définissez le besoin de retour. Demandez-vous quelle décision ou quelle tâche est bloquée si la modification ne revient pas dans le système d’origine.
- Documentez les exceptions. Certains champs d’une même entité peuvent avoir des propriétaires distincts. Une équipe commerciale peut mettre à jour le téléphone dans le CRM, alors que l’adresse de livraison valide provient de la commande.
Un signal d’alerte apparaît lorsque la réponse à la question « qui décide pour ce champ ? » est « cela dépend ». Cela n’empêche pas l’intégration, mais impose de transformer ce « cela dépend » en une règle vérifiable : selon le statut, le canal, la date, le type de client ou l’autorisation de l’utilisateur.
Quand un seul sens est suffisant et plus sûr
La synchronisation unidirectionnelle est préférable lorsqu’il existe une source claire, que le destinataire doit surtout consommer les données et que le retour ne déclenche pas une action indispensable. Elle est également adaptée lorsque la donnée est sensible, fortement régulée en interne ou difficile à réconcilier.
Les cas fréquents comprennent le catalogue de l’ERP vers le site e-commerce, les segments du CRM vers une plateforme de communication, ou les tickets clôturés vers un système d’analytique. Dans ces situations, autoriser la modification dans le système destinataire crée une promesse difficile à tenir : que toute modification locale sera conservée et aura un sens en dehors de ce contexte.
Signaux pratiques pour choisir un flux unidirectionnel
- Un système réalise des validations, des approbations ou des calculs que l’autre ne peut pas reproduire.
- Le destinataire a seulement besoin de visibilité, de recherche, de rapports ou de l’exécution d’une tâche ultérieure.
- Les modifications dans la destination sont locales, temporaires ou ne doivent pas affecter l’enregistrement maître.
- Un conflit aurait un impact financier, juridique, opérationnel ou sur le service client.
- L’information change peu ou peut être mise à jour par lots sans affecter le processus.
Le principal avantage n’est pas uniquement technique. Un flux à sens unique permet d’expliquer clairement pourquoi une valeur apparaît à l’écran et où elle doit être corrigée. Si l’opérateur constate un prix erroné sur le site e-commerce, il sait qu’il doit le corriger dans l’ERP, et non modifier une copie qui sera remplacée lors de la prochaine synchronisation.
Quand la synchronisation bidirectionnelle est justifiée
La bidirectionnalité est justifiée lorsque deux équipes travaillent dans des applications différentes et que chacune doit accomplir une partie légitime du même processus. Il doit exister un besoin opérationnel précis, et pas seulement l’envie de « tout garder à jour ».
Un exemple courant relie le site e-commerce, l’ERP et le service client. Le site e-commerce crée la commande et capture l’adresse de livraison. L’ERP confirme la préparation, l’expédition ou l’annulation. Le service client peut enregistrer un incident ou une demande de modification. Toutefois, tous ne devraient pas modifier les mêmes éléments :
- Le site e-commerce est maître des données saisies et confirmées pendant l’achat.
- L’ERP est maître des statuts logistiques, des documents opérationnels et de la disponibilité engagée.
- L’application de service client peut créer un dossier et proposer une action, mais ne devrait pas modifier directement un statut logistique sans passer par la règle établie dans l’ERP.
Cette conception préserve une expérience coordonnée sans transformer trois systèmes en autorités équivalentes. La bidirectionnalité doit comporter des limites d’écriture, et pas seulement des autorisations de lecture.
Risques des deux sens et règles de résolution des conflits
Les défaillances typiques d’une synchronisation bidirectionnelle ne sont généralement pas des erreurs de connexion isolées. Ce sont des ambiguïtés métier exprimées sous forme d’erreurs de données. Les plus courantes sont les boucles de mise à jour, les écrasements, les doublons, les modifications reçues dans le désordre et les statuts sans équivalence entre les systèmes.
Une boucle se produit lorsque le système A met à jour B, que B renvoie la même modification à A, puis que le cycle continue. Un écrasement survient lorsque deux utilisateurs modifient un champ depuis des emplacements différents avant que l’intégration ne propage les deux versions. Des doublons apparaissent si chaque plateforme crée des enregistrements sans reconnaître l’identifiant de l’autre.
Pour les prévenir, définissez une politique de conflit avant de construire l’intégration :
- Priorité par champ : l’ERP prévaut pour le stock ; le site e-commerce prévaut pour l’adresse de livraison confirmée.
- Priorité par statut : tant qu’une commande est en attente, elle peut être modifiée sur le site e-commerce ; après sa préparation, les modifications nécessitent un flux contrôlé.
- Dernière mise à jour : utilisez cette règle uniquement lorsque l’horloge, le fuseau horaire et la sémantique de la modification sont fiables. Ce n’est pas une règle universelle.
- Révision manuelle : envoyez les cas à fort impact dans une file avec un responsable, un motif et les données comparées.
- Rejet explicite : n’appliquez pas une modification incompatible ; renvoyez une erreur exploitable et conservez les éléments de preuve.
Il est également utile de modéliser les statuts. « Annulée », « remboursée », « expédiée » et « clôturée » ne représentent pas toujours la même chose dans chaque application. Créez une table de correspondance et déterminez quelles transitions sont autorisées. Si un système n’accepte pas une transition, ne forcez pas une équivalence qui masquerait une exception opérationnelle.
Conception technique minimale pour une intégration exploitable
L’architecture doit prendre en charge la politique de données, et non s’y substituer. Au minimum, chaque enregistrement synchronisé nécessite un identifiant interne stable et l’identifiant du système externe. N’utilisez pas une adresse e-mail, un nom ou une référence visible comme clé unique s’ils peuvent changer ou se répéter.
- Marques d’origine : enregistrez le système qui a produit la modification afin d’éviter qu’elle soit à nouveau traitée comme nouvelle.
- Versions ou dates de modification : elles aident à détecter les événements en retard et les mises à jour simultanées.
- Idempotence : répéter un message ne doit pas créer une commande, un client ou un ticket supplémentaire.
- Journal traçable : conservez les identifiants, le sens du flux, le résultat, l’erreur et le moment du traitement.
- Nouvelles tentatives contrôlées : distinguez les erreurs temporaires des validations définitives et limitez les nouvelles tentatives.
origine: ecommerce
entite: commande
id_externe: EC-10452
version: 7
operation: mettre_a_jour_statut
cle_idempotence: ecommerce-EC-10452-7
Ce type d’information permet d’enquêter sur les raisons pour lesquelles une modification n’est pas arrivée, est arrivée deux fois ou a été écartée. Sans traçabilité, l’équipe finit par comparer des écrans et corriger les données manuellement, une pratique qui aggrave la divergence.
Testez les scénarios de conflit et approuvez le flux avec une checklist
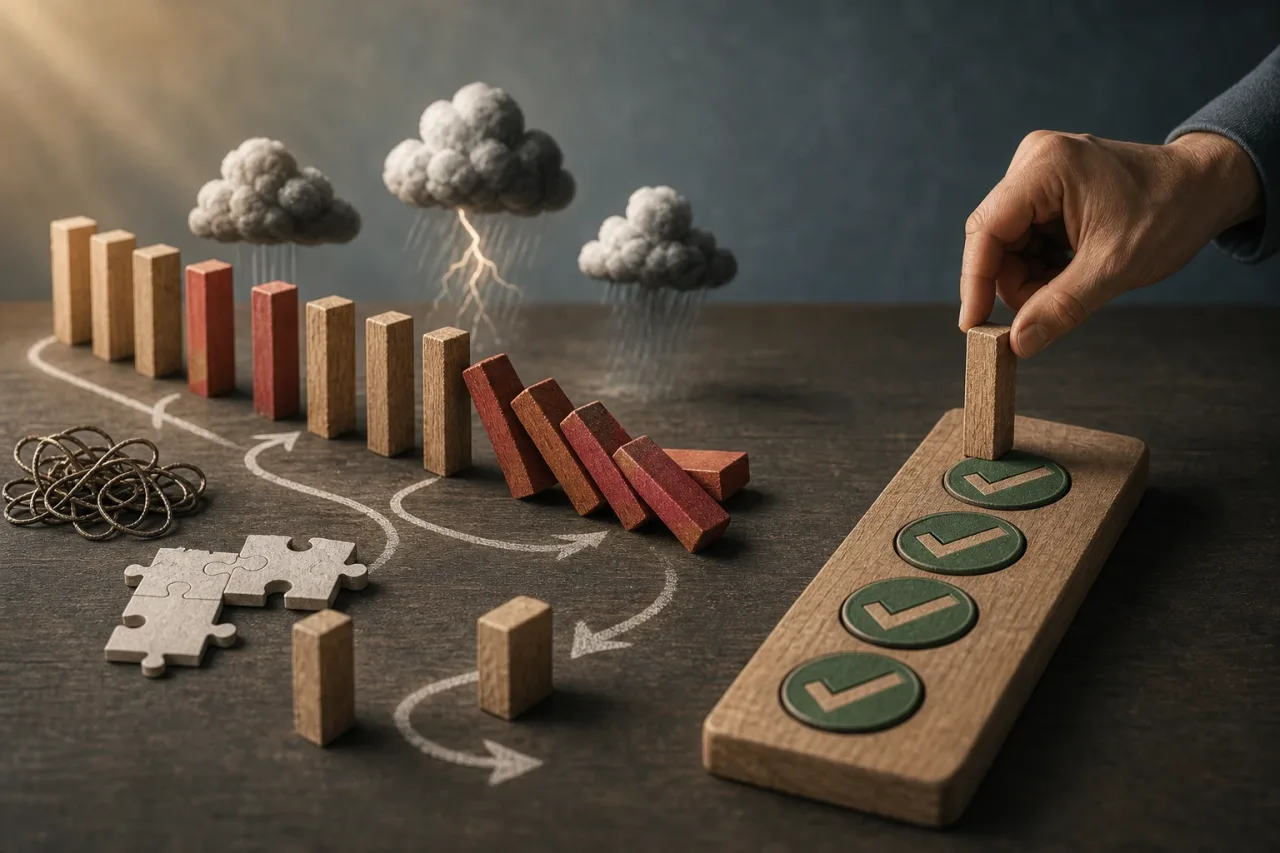
Ne validez pas une intégration uniquement avec des créations et des mises à jour correctes. Les tests doivent inclure des modifications simultanées, des enregistrements incomplets, des événements dupliqués, des erreurs réseau, des autorisations insuffisantes et une indisponibilité prolongée de l’un ou l’autre système.
Avant d’approuver la mise en production, confirmez les points suivants :
- Chaque entité et chaque champ important disposent d’un système maître et d’un responsable métier.
- Le sens de chaque flux répond à un besoin opérationnel documenté.
- Des règles de priorité, de rejet et de révision manuelle existent pour les conflits.
- Les identifiants externes, l’origine de la modification et l’idempotence sont mis en œuvre.
- Les statuts incompatibles font l’objet d’un traitement explicite, et non d’une conversion implicite.
- Des alertes et une procédure existent pour examiner les échecs, les nouvelles tentatives et les enregistrements en attente.
- Les équipes savent où corriger une donnée et quelles modifications elles ne doivent pas effectuer localement.
La meilleure intégration n’est pas celle qui déplace le plus de données dans les deux sens. C’est celle qui préserve une source de vérité compréhensible, fournit l’information lorsque le processus en a besoin et rend visibles les exceptions avant qu’elles ne deviennent des incidents pour le client.