

Connecter un CRM, un ERP, un e-commerce et des applications internes soulève une question apparemment simple : comment savoir que deux enregistrements représentent la même entité ? La réponse ne peut pas reposer par défaut sur un nom, une adresse e-mail ou une référence visible. Ces valeurs changent, peuvent être dupliquées et obéissent souvent à des règles différentes dans chaque système.
Une mauvaise décision concernant les identifiants entraîne des doublons, des mises à jour appliquées au mauvais enregistrement, des commandes sans client associé et des rapprochements manuels qui deviennent récurrents. Une décision solide ne consiste pas à trouver un identifiant universel magique, mais à définir quel système reconnaît quelle entité, avec quelle clé, pendant combien de temps et selon quelles règles de changement.
Ce cadre aide à choisir entre ID internes, références métier, ID externes et tables de correspondance, sans exposer d'informations inutiles ni coupler les systèmes de manière fragile.
Pourquoi les champs visibles ne résolvent pas la question de l'identité
Le nom d'une entreprise peut être écrit de plusieurs façons, changer après une fusion ou être partagé par différentes organisations. Le nom d'une personne présente encore davantage de risques de collision. L'adresse e-mail peut être modifiée, réutilisée, appartenir à un compte partagé ou manquer dans certains flux. Même une référence commerciale peut n'être unique qu'au sein d'une filiale, d'un canal ou d'une période.
Ces champs restent utiles pour rechercher, afficher et proposer des correspondances, mais ils doivent rarement constituer la clé technique d'une intégration. La distinction importante est la suivante :
- Identité : l'enregistrement précis qu'un système considère comme une entité.
- Attributs : les données qui décrivent cette entité, comme le nom, l'adresse e-mail, le téléphone ou l'adresse postale.
- Référence métier : un code ayant une signification opérationnelle, tel qu'un numéro de commande ou un code client.
Confondre ces niveaux est une source fréquente d'erreurs. Par exemple, une adresse postale n'identifie pas nécessairement un client : une même personne peut avoir plusieurs adresses et plusieurs personnes peuvent en partager une. De même, une commande identifie une transaction, non l'acheteur de façon permanente.
Types d'identifiants et utilité de chacun
Avant de concevoir des messages ou des endpoints, il est utile de classer les clés disponibles. Chaque type présente des avantages et des limites.
- ID interne : clé générée et contrôlée par un système, généralement stable et dépourvue de signification métier. C'est la meilleure option pour opérer dans son propre domaine.
- Référence métier : code lisible ou opérationnel, comme une référence de commande. Elle facilite le support et le rapprochement, mais son format peut changer, sa numérotation peut redémarrer selon les séries ou elle peut être réutilisée.
- ID externe : identifiant qu'un système destinataire conserve afin de mémoriser l'enregistrement provenant d'un système émetteur. Il est utile lorsqu'il existe une relation claire de provenance.
- Identifiant composé : combinaison de valeurs, par exemple
source + type d'entité + id. Il est indispensable lorsqu'un ID n'est unique qu'au sein d'un système. - Identifiant temporaire : clé de corrélation pour un processus qui n'est pas encore consolidé. Il doit expirer et ne pas devenir accidentellement une identité permanente.
Une règle pratique consiste à conserver l'ID interne de chaque application comme autorité locale. Lors de l'échange de données, l'identifiant minimal sûr est généralement une valeur dont l'espace de noms est explicite. Par exemple :
{
  "entity_type": "customer",
  "source_system": "ecommerce",
  "source_id": "C-48291"
}
La valeur C-48291 seule n'est pas nécessairement unique à l'échelle mondiale. Le contexte d'origine évite qu'un autre système interprète une correspondance textuelle comme une identité partagée.
Questions auxquelles répondre avant de partager un ID
Ne choisissez pas une clé par commodité d'implémentation. Définissez d'abord le modèle de propriété et le cycle de vie. Ces questions permettent de déterminer si un identifiant peut circuler entre les systèmes :
- Quel système crée l'entité et lequel est la source de vérité pour chaque attribut ?
- La valeur est-elle unique dans toute l'organisation ou seulement dans une application, un pays, un canal ou un type d'entité ?
- Peut-elle changer ? Si oui, l'ancienne valeur est-elle conservée et l'événement est-il publié ?
- Peut-elle être réutilisée après une suppression, une annulation ou une période de conservation ?
- Contient-elle des données personnelles, des informations commerciales sensibles ou des motifs faciles à deviner ?
- Un enregistrement peut-il être fusionné avec un autre ou scindé en plusieurs enregistrements ?
- Quel comportement le destinataire doit-il adopter lorsqu'il ne trouve aucune correspondance ?
Un ID partagé doit être stable, unique dans son contexte, non réutilisable et suffisamment opaque pour l'usage prévu. Si une référence métier ne répond pas à ces conditions, utilisez-la comme attribut vérifiable, et non comme clé de mise à jour.
Il faut également distinguer l'identité technique de l'autorisation. Connaître un identifiant ne doit pas permettre de lire ou de modifier une entité. Les API doivent vérifier que l'appelant est autorisé à agir sur cette ressource et éviter d'utiliser des ID prévisibles comme unique mécanisme de protection.
Quand propager l'ID d'origine et quand utiliser une table de correspondance
Propager l'ID d'origine est pertinent lorsqu'une entité naît dans un système clairement faisant autorité et que les autres systèmes doivent seulement la reconnaître. Par exemple, l'e-commerce peut créer une commande et l'ERP peut stocker l'identifiant de la commande e-commerce en tant que référence externe. Ce modèle réduit l'ambiguïté et permet de retracer la provenance.
Toutefois, tous les domaines ne disposent pas d'une autorité unique. Un client peut être introduit par les ventes, l'e-commerce, le support ou des importations historiques. Dans ces cas, imposer l'ID de l'un des systèmes comme clé universelle crée une dépendance et peut transformer une future migration en projet à haut risque.
Une table de correspondance est préférable lorsqu'il existe plusieurs systèmes maîtres, une consolidation progressive, des fusions d'enregistrements ou des règles d'identité complexes. Elle doit conserver au minimum le type d'entité, le système, l'ID local, l'ID canonique s'il existe, l'état du lien, la date de création et la preuve ou la règle qui justifie la relation.
Évitez une table qui relie seulement deux colonnes sans contexte. La même valeur peut exister pour des types distincts, et un lien peut être confirmé, provisoire, rejeté ou remplacé après une fusion. Considérez ce mappage comme une donnée opérationnelle avec auditabilité, et non comme une configuration invisible dans le code.
Créations, doublons et fusions : concevoir pour les cas difficiles
Lorsqu'une création arrive sans identifiant commun, le destinataire ne doit pas supposer qu'il s'agit d'une nouvelle entité ni qu'une correspondance par adresse e-mail est définitive. Il doit appliquer une politique explicite :
- Créer un nouvel enregistrement et le laisser non lié lorsqu'il n'existe pas suffisamment de preuves.
- Proposer une correspondance lorsque plusieurs attributs cohérents dépassent un seuil défini par les métiers.
- Exiger une vérification humaine pour lier des enregistrements ayant des conséquences financières, contractuelles ou de relation client.
- Consigner la décision, la règle appliquée et les ID concernés.
La déduplication automatique est particulièrement risquée lorsque le coût d'un rapprochement erroné dépasse celui du maintien de deux enregistrements en attente. Fusionner par erreur deux clients peut mélanger des factures, des consentements ou des communications. À l'inverse, un doublon détecté peut être traité dans une file de révision.
Les fusions exigent une sémantique propre. Définissez un enregistrement survivant, conservez les ID historiques sous forme d'alias ou de redirections, puis publiez le changement afin que les systèmes consommateurs mettent à jour leurs liens. Ne supprimez pas immédiatement l'ID absorbé : les processus asynchrones, les nouvelles tentatives et les enregistrements historiques peuvent encore le référencer.
Changements, suppressions et réactivations sans rompre la traçabilité
Dans l'idéal, un identifiant technique ne change pas. Si une référence métier doit changer, l'événement doit communiquer à la fois l'ancienne et la nouvelle valeur, ainsi que la raison du changement. N'interprétez jamais le silence comme une suppression : il peut s'agir de retards, d'échecs de livraison ou de filtres de synchronisation.
Pour les suppressions, utilisez des statuts explicites tels qu'actif, inactif, annulé, supprimé ou fusionné, selon le domaine. La suppression physique peut être nécessaire en raison d'exigences de confidentialité, mais elle doit être conçue conjointement avec la traçabilité : il peut être possible de conserver un marqueur technique non identifiable ou une preuve qu'un lien ne doit plus être recréé.
Ne réutilisez pas des références qui ont déjà été émises, même si l'enregistrement est inactif. La réutilisation transforme des données historiques correctes en ambiguïté future. Si une réactivation concerne la même entité, conservez l'ID ; si elle concerne une nouvelle entité, attribuez-en un nouveau et documentez la relation uniquement si elle apporte une valeur opérationnelle.
Conception des API, messages et contrôles opérationnels
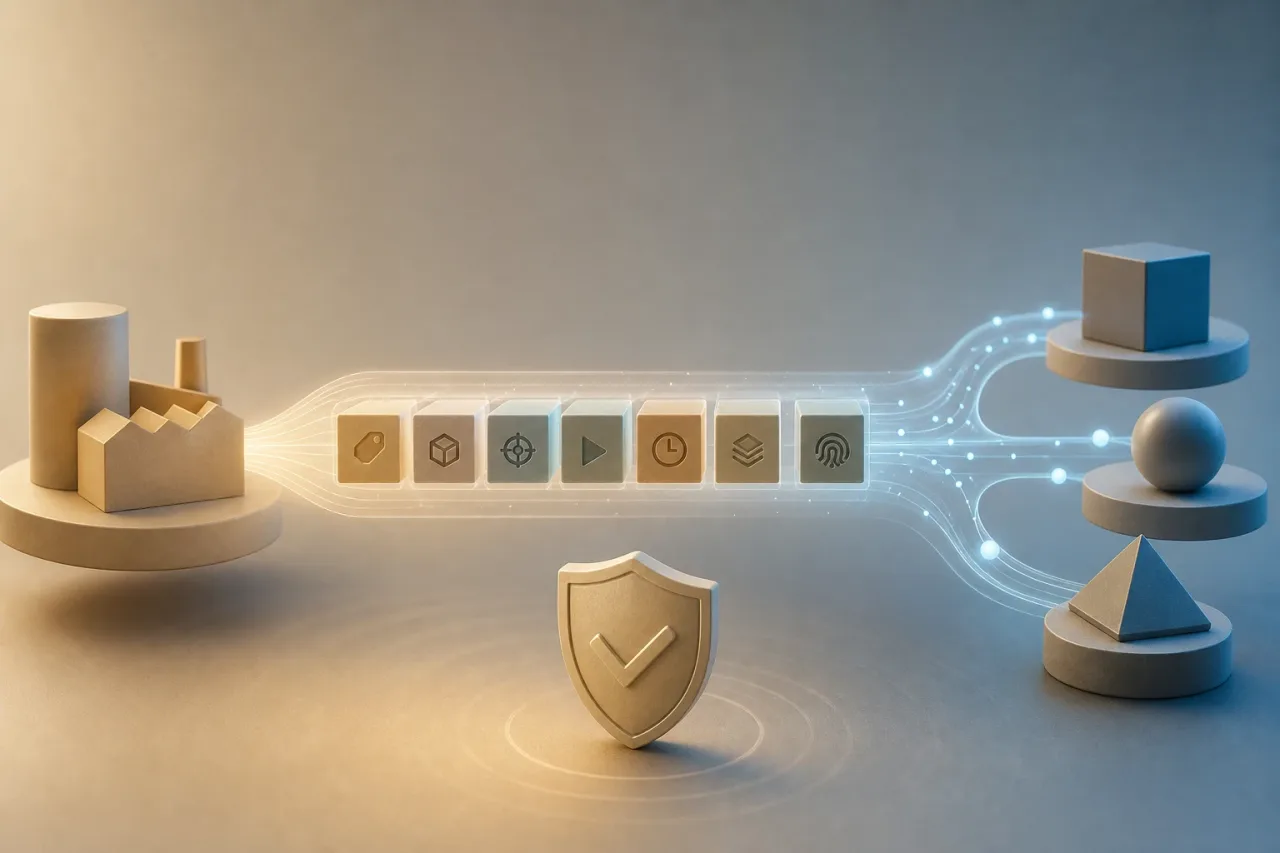
Un contrat d'intégration doit transporter un contexte suffisant, sans inclure plus de données que nécessaire. Incluez le type d'entité, le système d'origine, l'ID d'origine, l'opération, l'horodatage, la version ou la séquence lorsque cela s'applique, ainsi qu'un identifiant d'événement pour gérer les nouvelles tentatives. L'idempotence évite de créer plusieurs fois la même entité lorsqu'une livraison est répétée.
Pour les mises à jour, privilégiez une opération qui indique clairement la clé utilisée. Si la recherche par référence métier est autorisée, traitez un résultat multiple comme une erreur contrôlée, et non comme une invitation à choisir le premier enregistrement.
Les contrôles opérationnels doivent transformer les problèmes d'identité en signaux visibles :
- alertes sur les correspondances ambiguës et les messages sans correspondance ;
- files d'attente pour les liens en attente et les vérifications de fusion ;
- indicateurs sur les doublons créés, les liens rompus et les erreurs récurrentes par système ;
- rapprochements périodiques entre les volumes, les statuts et les liens attendus ;
- journaux incluant les ID techniques et de corrélation, sans exposer d'attributs personnels inutiles.
Avant de construire, documentez pour chaque entité son système faisant autorité, son ID local, les clés externes acceptées, les règles d'unicité, la politique de changement, les statuts de suppression et la stratégie de déduplication. Cette décision réduit le couplage aujourd'hui et rend plus gérable une future migration, un audit ou l'ajout d'un nouveau canal.