

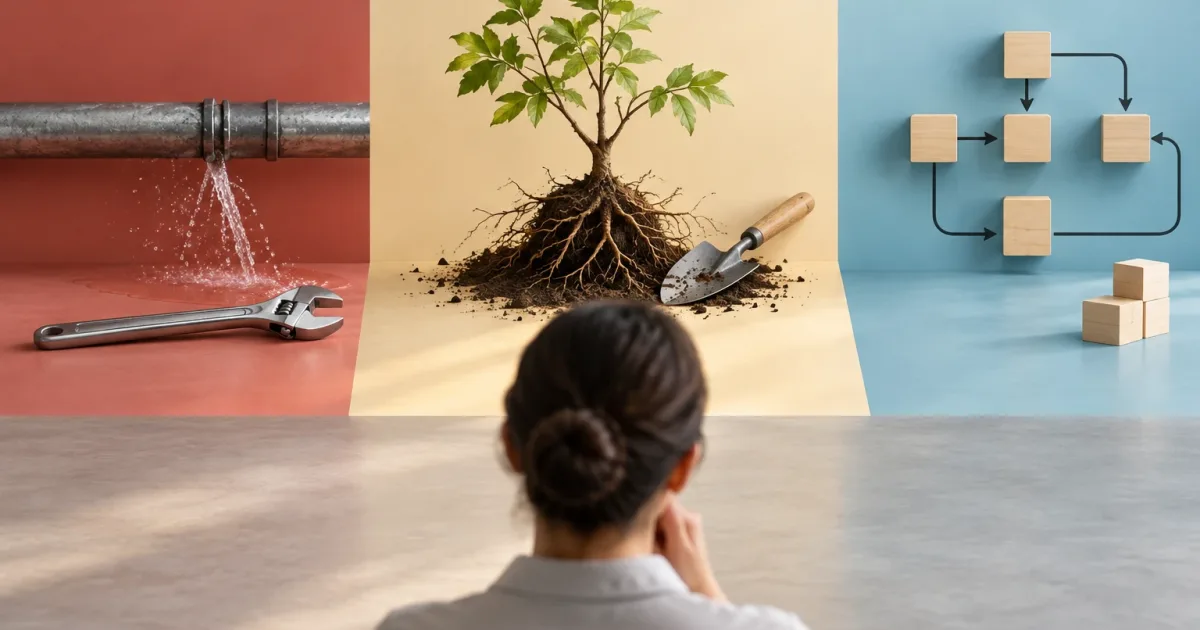
Lorsqu’un incident se reproduit, la réponse la plus rapide n’est pas toujours la plus appropriée. Corriger le cas peut rétablir le service tout en laissant intacte la cause du problème. À l’inverse, repenser un processus entier pour éviter un incident isolé mobilise des ressources et peut créer de nouveaux risques. Pour prendre une décision utile, il faut distinguer le symptôme, mesurer la portée du problème et choisir une intervention proportionnée.
Ce cadre aide les responsables produit, technologie et opérations à choisir entre trois réponses : traiter le cas, éliminer une cause technique ou modifier la manière de travailler. Il n’est pas nécessaire d’attendre d’avoir toutes les données, mais il convient de consigner les éléments connus, d’expliciter les incertitudes et de définir comment le résultat sera vérifié.
Distinguer le symptôme de la cause
Un incident est l’événement visible : une opération reste incomplète, une donnée ne correspond pas ou une tâche nécessite une intervention manuelle. La cause est le mécanisme qui rend ce résultat possible. Il peut s’agir d’un défaut logiciel, d’une intégration, d’une règle ambiguë, d’une exception mal gérée ou d’une combinaison de facteurs.
Avant de choisir une solution, décrivez le problème en termes observables :
- Ce qui s’est passé : quel résultat incorrect ou quel blocage a été constaté.
- Où et quand : quelle étape, quel système ou quelle condition était concerné.
- Qui ou quoi est affecté : les personnes, opérations, données ou services impliqués.
- Les éléments disponibles : journaux, messages, entrées ou séquences reproductibles.
- Ce qui reste inconnu : les hypothèses qui doivent être vérifiées.
Évitez de transformer la première explication plausible en diagnostic. Par exemple, le fait qu’une personne ait saisi une donnée incorrecte ne prouve pas que la cause soit une erreur individuelle : une étiquette peut prêter à confusion, une validation peut manquer ou les instructions peuvent se contredire. Une bonne enquête cherche à comprendre quelles conditions ont permis le résultat, et pas seulement qui a effectué la dernière étape.
Classer les incidents avant d’investir des efforts
Évaluez chaque incident selon quatre critères. Il n’est pas nécessaire de créer une notation complexe dès le départ ; il suffit de consigner les critères et de comparer les cas de façon cohérente.
- Fréquence : s’agit-il d’un cas isolé, d’un problème récurrent dans une condition précise ou d’un phénomène présent dans plusieurs parties des opérations ?
- Impact : quelles sont les conséquences pour les clients, le chiffre d’affaires, la conformité, la qualité des données, la charge de travail ou la continuité du service ?
- Portée : le problème touche-t-il une personne ou une transaction, un segment, plusieurs équipes ou l’ensemble du flux ?
- Réversibilité : peut-on annuler la correction en toute sécurité si elle se révèle erronée ? Peut-elle avoir des effets durables sur les données ou les décisions ultérieures ?
Tenez également compte du degré de certitude du diagnostic. Un incident à fort impact dont la cause reste incertaine peut d’abord nécessiter une mesure de confinement et la collecte d’éléments. En revanche, un défaut reproductible et circonscrit permet d’évaluer plus tôt une correction durable. Distinguez l’urgence de la solution définitive : contenir immédiatement un risque ne signifie pas que le problème de fond est résolu.
Quand une correction ponctuelle suffit
Une correction ponctuelle est généralement raisonnable lorsque le cas est exceptionnel, que son impact est limité, que la cause semble circonstancielle et que le résultat peut être réparé sans risque. Il peut s’agir de terminer une opération, de rétablir une valeur ou d’appliquer une exception autorisée. Cette intervention ne doit toutefois ni masquer une tendance ni créer une dette opérationnelle invisible.
Consignez chaque cas à l’aide d’une catégorie commune, de la date, du contexte, de l’impact, de l’action menée et d’une référence aux éléments disponibles. Indiquez également si la cause est confirmée ou si elle reste une hypothèse. Si chaque équipe décrit le même problème avec des mots différents, il sera plus difficile de repérer les récurrences ; une taxonomie courte et partagée facilite leur regroupement.
Lors de la correction, vérifiez les dépendances : si d’autres processus utilisent la donnée ou le résultat concerné, une réparation locale peut laisser des états incohérents. Prévoyez une procédure de révision et précisez qui est habilité à autoriser des exceptions. Si le cas se répète, la correction ponctuelle ne constitue plus une stratégie suffisante, même si elle reste nécessaire pour traiter chaque occurrence.
Les signes qu’il faut éliminer une cause profonde
Recherchez une solution durable lorsque les incidents partagent le même mécanisme, se reproduisent dans des conditions connues, entraînent régulièrement du travail manuel ou exposent à un risque inacceptable. En informatique, la réponse peut consister à corriger une validation, à gérer correctement une réponse inattendue ou à renforcer une intégration. Dans les opérations, elle peut passer par la clarification d’une règle ou la suppression d’une transition qui laisse circuler des données incomplètes.
Une intervention durable doit répondre à une cause vérifiée, et non simplement au symptôme le plus fréquent. Avant sa mise en œuvre, définissez :
- L’hypothèse sur la cause et les éléments qui l’étayent.
- Le changement minimal permettant d’empêcher ou de détecter le défaut.
- Les flux, données et utilisateurs susceptibles d’être affectés.
- Un test du cas initial et des scénarios proches qui ne devraient pas être perturbés.
- Un mécanisme de retour arrière ou de confinement si des effets secondaires apparaissent.
Si vous ne pouvez pas encore expliquer le problème, investissez d’abord dans l’observabilité ou dans la reproduction du cas. Ajouter une alerte peut aider à détecter le problème, mais ne revient pas à l’éliminer. De même, une modification du code qui empêche un cas précis risque de masquer une règle métier mal définie. La solution doit couvrir le comportement attendu, y compris les limites et les exceptions pertinentes.
Quand changer le processus plutôt que le système
L’origine du problème peut se trouver dans les règles, les responsabilités ou l’enchaînement des tâches. Envisagez un problème de processus si différentes applications présentent le même défaut, si les équipes interprètent chacune les règles à leur manière, si les exceptions reposent sur des connaissances informelles ou si l’erreur survient lors d’un transfert entre services.
Dans ce cas, examinez qui décide, qui exécute et qui vérifie chaque étape. Clarifiez les conditions d’entrée et de sortie, éliminez les doublons et précisez la marche à suivre lorsqu’une condition n’est pas remplie. Ne transformez pas chaque variation en formulaire ou en approbation supplémentaire : tout contrôle a un coût en temps et peut déplacer le problème. Échangez avec les personnes qui effectuent le travail, car elles connaissent souvent des exceptions absentes du schéma formel.
Les changements de processus nécessitent une communication et un suivi, pas seulement de la documentation. Lorsque c’est possible, testez la nouvelle méthode sur un flux limité, recueillez les questions et ajustez les consignes avant de la généraliser. Si le processus comporte des étapes manuelles destinées à compenser une limite technique, consignez cette dépendance : elle peut être temporaire, mais elle doit avoir un responsable et un critère de révision.
Matrice de décision et vérification des résultats
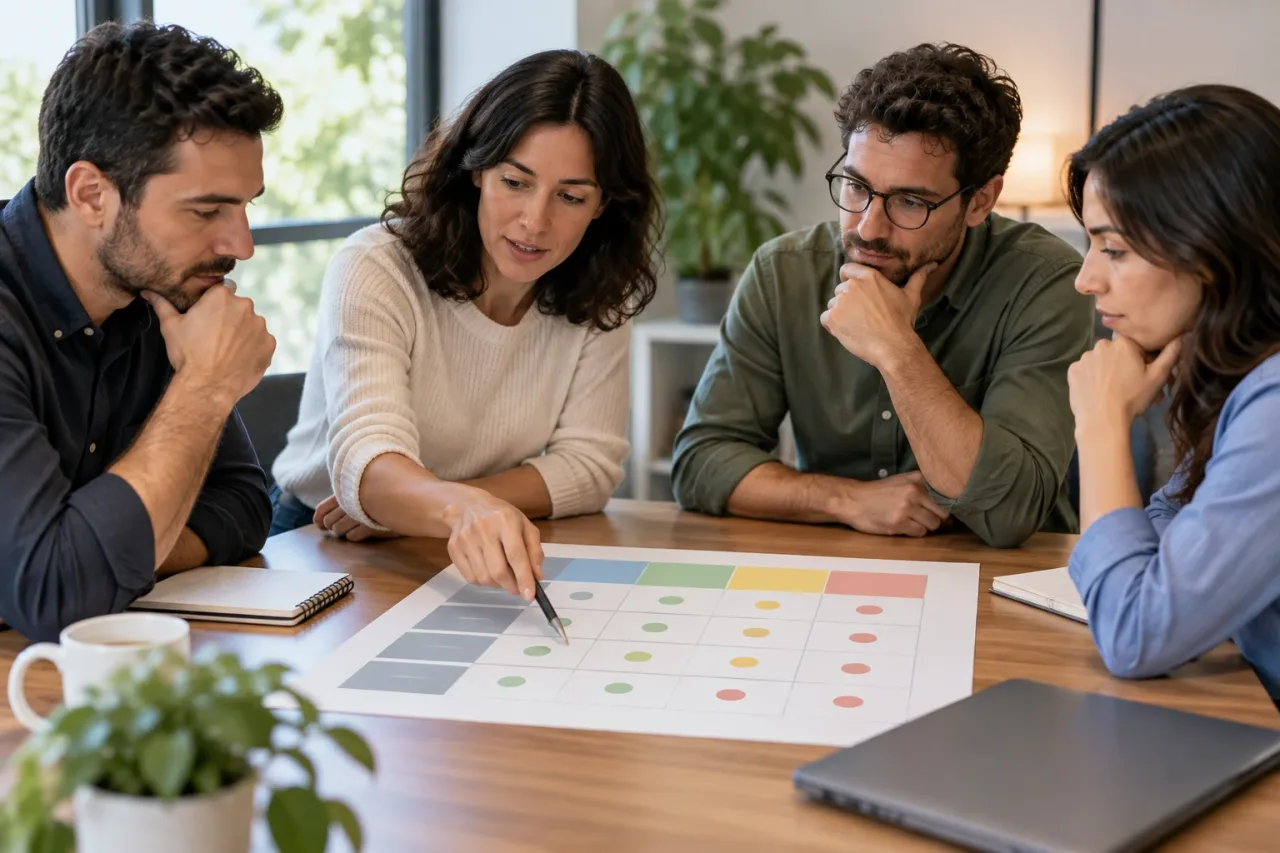
La matrice suivante constitue un point de départ, pas un substitut au jugement de l’équipe. Ces exemples sont hypothétiques et doivent être vérifiés au regard du contexte réel.
- Cas isolé, faible impact et réparation réversible : corrigez le cas et consignez son contexte afin de repérer d’éventuelles répétitions.
- Problème reproductible dans un système ou une intégration, à portée connue : contenez les effets et donnez la priorité à l’élimination de la cause technique, avec des tests de régression.
- Résultats différents selon l’équipe ou étape ambiguë : examinez la règle, les responsabilités et la séquence avant d’automatiser la réponse.
- Impact élevé ou données difficiles à restaurer, avec une cause incertaine : limitez l’exposition, approfondissez l’enquête et évitez les modifications irréversibles tant que les dépendances ne sont pas comprises.
Avant la modification, définissez l’indicateur qui permettra de confirmer une amélioration : diminution des cas d’une même catégorie, baisse des corrections manuelles, réduction du temps de résolution ou diminution du nombre d’opérations affectées. Choisissez une période d’observation adaptée au rythme du processus et comparez des conditions équivalentes ; une baisse temporaire peut s’expliquer par une activité moins importante, et non par la solution.
Examinez aussi les signes d’effets indésirables : refus légitimes, nouvelles erreurs, retards, transferts supplémentaires ou multiplication des exceptions. Si les incidents diminuent mais que le travail manuel augmente, la mesure a peut-être déplacé le coût au lieu de résoudre le problème. Décidez alors de la maintenir, de l’ajuster ou de la retirer, et consignez votre décision. L’examen périodique des incidents regroupés permet de détecter quand une correction ponctuelle devient un schéma récurrent et appelle une réponse de plus grande portée.
En résumé, traitez le cas s’il est exceptionnel et maîtrisable, éliminez la cause lorsque le mécanisme est identifié et modifiez le processus lorsque les règles ou les transferts sont à l’origine du problème. Si le diagnostic reste incertain, contenez le risque et recueillez des éléments avant de vous engager dans une solution difficile à annuler.