

Les données de test influent à la fois sur la qualité des logiciels et sur l’exposition d’informations sensibles. Un jeu trop simple peut masquer des erreurs ; une copie de production sans contrôles peut divulguer des données personnelles ou commerciales. Il ne s’agit pas seulement de choisir entre données réelles et fictives : il faut équilibrer réalisme, sensibilité, effort de maintenance et objectif de chaque environnement.
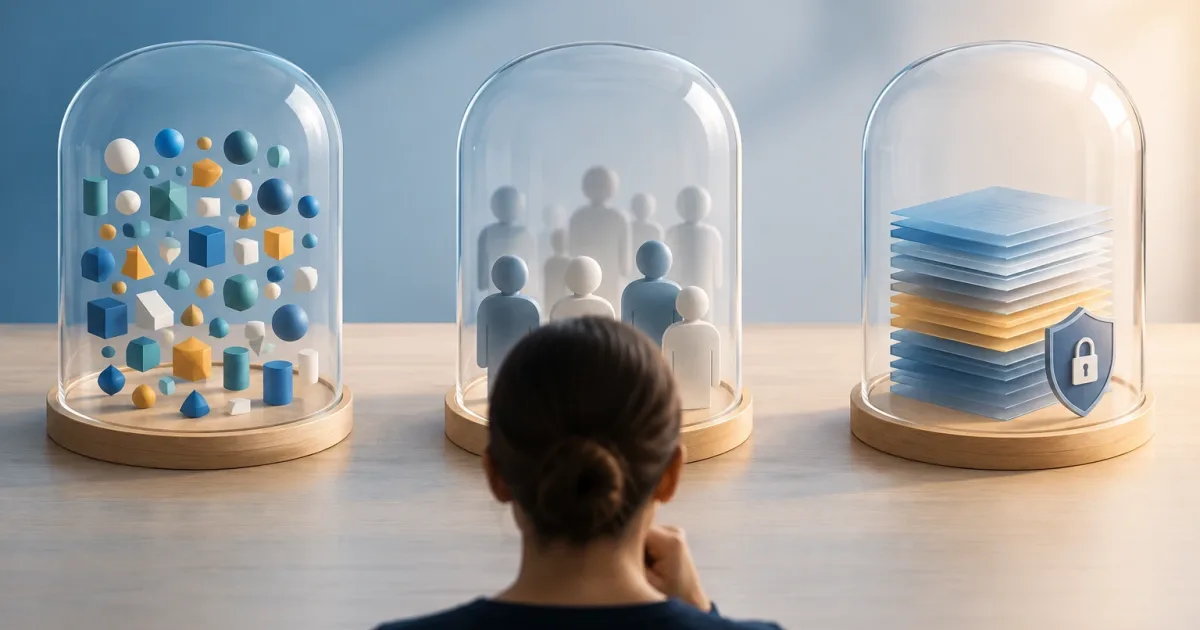
Ce guide compare trois approches — données synthétiques, données anonymisées et copies contrôlées — et présente des critères pratiques pour le développement, les tests et les démonstrations. La solution adaptée peut varier d’une équipe à l’autre, voire d’un test à l’autre au sein d’un même produit.
Pourquoi les données déterminent la qualité et le risque
Une application se comporte en fonction des données qu’elle traite. Le volume, les combinaisons, les valeurs manquantes, les doublons et les relations entre enregistrements peuvent activer des parcours que des exemples minimaux ne couvrent pas. Si les tests portent uniquement sur le cas idéal, ils risquent de manquer des défauts de validation, de calcul, d’autorisation, d’intégration ou de migration.
Parallèlement, les environnements hors production comptent souvent davantage d’utilisateurs disposant d’un accès, d’outils de débogage et de cycles de vie moins stricts qu’en production. Y inclure des informations identifiantes par commodité accroît les conséquences d’un compte compromis, d’une exportation accidentelle ou d’un environnement laissé à l’abandon. L’objectif est de conserver les caractéristiques nécessaires aux tests, et non de copier plus d’informations que nécessaire.
Avant de choisir une méthode, précisez ce que vous souhaitez valider : une règle métier, une migration, les performances, l’expérience utilisateur ou une démonstration. Sans objectif défini, « données réalistes » reste une exigence imprécise et peut inciter à collecter des détails qui n’apportent aucune valeur.
Trois approches, trois niveaux de fidélité
Données synthétiques
Elles sont générées de toutes pièces à l’aide de règles, de modèles ou d’outils internes. Elles peuvent inclure de faux noms, des dates, des états et des relations cohérentes, ainsi que des cas limites conçus délibérément. Comme elles ne proviennent pas d’enregistrements réels, elles évitent le transfert direct de données de production. Elles ne sont toutefois pas automatiquement sûres si elles contiennent des valeurs réelles, des secrets ou des exemples copiés.
Elles conviennent au développement, aux tests automatisés, à la formation et aux démonstrations lorsque la structure et le comportement attendus peuvent être décrits. Leur principal coût consiste à créer et à maintenir des générateurs qui reflètent les règles métier, les distributions et les combinaisons utiles. Un jeu synthétique trop régulier ne révélera pas les problèmes dus aux irrégularités des données historiques.
Données anonymisées
Elles sont obtenues en transformant des données sources de manière à empêcher l’identification des personnes. Le résultat peut conserver des tendances utiles pour certains tests, mais le risque dépend du contexte, des champs préservés et de la possibilité de croiser ces informations avec d’autres sources. Remplacer les noms ou les adresses électroniques ne suffit pas nécessairement : les dates, les lieux, les identifiants indirects et les relations rares peuvent également révéler une identité.
Cette approche nécessite de vérifier le résultat, et pas seulement d’exécuter une transformation. Si le test ne requiert que des tendances agrégées, il peut être préférable de réduire le niveau de détail. S’il requiert des relations entre enregistrements, la transformation doit préserver leur cohérence sans conserver d’identifiants inutiles. L’anonymisation ne garantit pas automatiquement que toute utilisation ultérieure est sans risque.
Copies contrôlées de données de production
Une copie contrôlée conserve une partie sélectionnée des données réelles ou une version transformée et limitée. Elle peut servir à analyser des incidents difficiles à reproduire, à valider des migrations complexes ou à évaluer le comportement à partir de distributions authentiques. Elle concentre aussi les risques : elle peut transporter des informations sensibles, contenir des secrets opérationnels et devenir rapidement obsolète.
Réservez cette solution aux cas où les autres options n’offrent pas le niveau de réalisme nécessaire. Définissez les champs extraits, la personne qui autorise la préparation, l’emplacement de stockage, les accès et la date de suppression. Une copie ne doit pas devenir le choix par défaut simplement parce qu’elle est plus commode.
Choisir en fonction du test et du risque
Appuyez-vous sur les critères suivants pour prendre une décision explicite :
- Développement et tests unitaires : privilégiez des données synthétiques limitées, prévisibles et faciles à réinitialiser. Elles doivent couvrir les valeurs valides, invalides et les limites des règles.
- Tests d’intégration : combinez des données synthétiques cohérentes avec les contrats des systèmes connectés. Si une dépendance exige un réalisme historique, évaluez un extrait transformé et limité.
- Tests de charge ou de performance : reproduisez le volume, la distribution et les relations nécessaires. Ne partez pas du principe que des identités réelles sont indispensables ; vérifiez si une génération synthétique peut produire le même profil opérationnel.
- Analyse d’incidents : commencez par reproduire le problème avec des données synthétiques. Si cela ne suffit pas, utilisez une copie contrôlée dont la portée, les accès et la durée de conservation sont définis.
- Démonstrations : des données synthétiques préparées à cet effet sont généralement adaptées. Évitez qu’une démonstration publique ou partagée hérite d’enregistrements, de commentaires ou de pièces jointes réels.
La sensibilité des données compte également. Plus les informations sont délicates et les accès étendus, plus il faut privilégier les données synthétiques ou une transformation qui élimine les détails superflus. La décision devrait consigner la raison pour laquelle le réalisme supplémentaire justifie l’effort et le risque.
Représentativité, cas limites et réidentification
Être représentatif ne signifie pas reproduire chaque enregistrement. Il s’agit de conserver les propriétés qui influent sur le test. Repérez des dimensions comme la fréquence des états, la distribution des tailles, les relations entre entités, l’ancienneté et les valeurs manquantes. Comparez ensuite le jeu de test à ces dimensions, sans inclure de champs inutilisés.
Ajoutez les cas rares susceptibles de mettre en échec certaines hypothèses : enregistrements en double, séquences incomplètes, formats inattendus, fuseaux horaires ou transitions d’état inhabituelles. Les données synthétiques permettent de créer ces situations volontairement, alors qu’un échantillon de production peut ne pas les contenir.
Pour évaluer le risque de réidentification, demandez-vous ce qui pourrait être déduit en combinant les champs conservés avec des informations disponibles ailleurs. Vérifiez les identifiants directs et indirects, les valeurs rares et les liens entre tables. Si vous ne pouvez pas justifier la nécessité d’un attribut, supprimez-le ou généralisez-le, puis vérifiez que le scénario de test reste utile.
Contrôler le cycle de vie du jeu de données
La protection ne s’arrête pas à la création du jeu de données. Définissez des contrôles simples et vérifiables pour sa préparation et son utilisation :
- Inventorier : identifiez les jeux de données, leur objectif, leur origine, leurs champs et l’environnement où ils seront utilisés.
- Limiter : n’extrayez que les enregistrements et attributs nécessaires ; séparez les données de test des identifiants, jetons et secrets opérationnels.
- Restreindre les accès : attribuez les permissions selon les besoins professionnels et vérifiez qui peut télécharger, copier ou exporter les données.
- Encadrer les mises à jour : documentez la méthode de génération de chaque version, la personne responsable de sa maintenance et les changements de schéma ou de règles qui nécessitent une nouvelle génération.
- Fixer une date d’expiration : définissez quand le jeu de données et ses copies de travail seront supprimés, y compris les exportations connues.
- Vérifier le résultat : assurez-vous qu’il ne contient pas de données réelles ni de champs sensibles inattendus et que les tests couvrent toujours les scénarios prévus.
Un jeu de test réutilisable devrait avoir un responsable et un objectif, comme tout autre actif de l’équipe. Si personne ne sait d’où il vient ni quand il doit être retiré, considérez-le comme une dette opérationnelle et décidez de son sort avant de continuer à le diffuser.
Erreurs fréquentes et liste de vérification
Deux extrêmes posent souvent problème. Le premier consiste à utiliser des données réelles par commodité : cela réduit le travail initial, mais multiplie les copies et complique le contrôle des accès et de la suppression. Le second consiste à utiliser des données artificielles trop propres : l’exposition diminue, mais un faux sentiment de confiance peut s’installer si les formats, les relations et les cas limites pertinents ne sont pas représentés. Il ne faut pas choisir entre fidélité et sécurité de manière absolue, mais adapter le jeu à la question à résoudre.
Avant d’approuver des données pour un environnement hors production, vérifiez les points suivants :
- L’objectif du test et les caractéristiques de données nécessaires sont-ils définis ?
- Peut-on utiliser des données synthétiques ? Sinon, quel aspect du réalisme manque-t-il ?
- Les champs, les enregistrements et les relations ont-ils été réduits au strict nécessaire ?
- Les valeurs rares et les combinaisons susceptibles de faciliter une réidentification ont-elles été examinées ?
- Les accès, l’emplacement, les mises à jour, la responsabilité et la date de suppression sont-ils définis ?
- Le jeu couvre-t-il les cas limites et peut-il être régénéré lorsque le produit ou le schéma évolue ?
La décision la plus solide relie chaque type de données à un besoin de test et à un contrôle concret. Commencez par des données synthétiques, passez à une transformation ou à une copie contrôlée uniquement lorsqu’un manque de fidélité est démontré, puis réévaluez votre choix si l’objectif, les données ou les accès changent.