

Déployer une application dans plusieurs régions peut sembler être un moyen direct de réduire les interruptions ou de rapprocher le service de ses utilisateurs. Mais répartir l’infrastructure entraîne aussi de nouvelles décisions : comment les données sont répliquées, ce qui se passe si une région est isolée et qui peut exploiter l’ensemble. La question n’est pas de savoir combien de régions sont possibles, mais quel problème concret une deuxième région permettrait de résoudre et si l’équipe peut faire fonctionner cette solution dans la durée.
La décision dépend des objectifs du service, de ses dépendances et des conséquences d’une interruption. Une architecture simple, bien surveillée et dont la reprise a été testée peut être plus adaptée qu’une configuration multirégion que personne n’a mise à l’épreuve. Ce guide propose des critères pour comparer les options et avancer progressivement.
Ce que signifie un déploiement dans une ou plusieurs régions
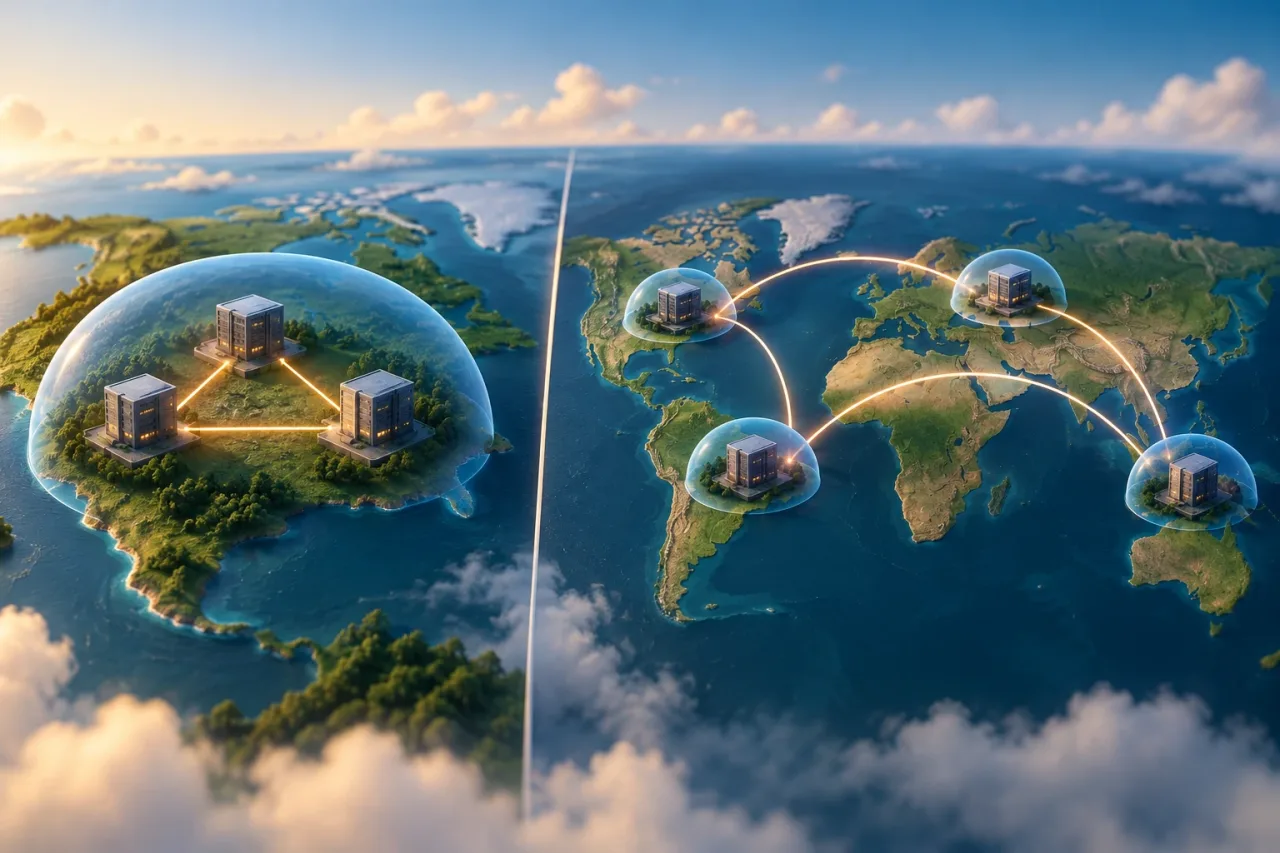
Une région est un emplacement géographique au sein d’une infrastructure cloud. Une application déployée dans une seule région y concentre ses principaux composants, même si ceux-ci peuvent être répartis entre différentes zones de disponibilité. Plusieurs zones au sein d’une région contribuent à se protéger contre certaines défaillances locales, mais elles ne sont pas équivalentes à une deuxième région préparée à prendre le relais.
Dans un déploiement multirégion, des composants de l’application fonctionnent, ou peuvent fonctionner, depuis différents emplacements géographiques. La configuration varie : une région peut gérer le trafic habituel tandis qu’une autre reste prête à assurer la reprise ; les deux peuvent aussi être actives et recevoir des requêtes. Ces options n’impliquent pas les mêmes exigences en matière de données, de routage et d’exploitation.
Il convient de commencer par définir le périmètre. Une application peut disposer de serveurs dans plusieurs régions tout en dépendant d’une base de données, d’un système d’identité ou d’une intégration qui ne fonctionne que dans l’une d’elles. Dans ce cas, répartir la couche applicative ne signifie pas que le service complet peut continuer à fonctionner en cas de perte d’une région.
Identifiez le problème avant de choisir l’architecture
Les raisons les plus courantes d’envisager plusieurs régions correspondent à trois objectifs. Chacun exige des tests et des décisions différents :
- Continuité : maintenir ou rétablir le service si une région devient indisponible. Il faut préciser la durée maximale de l’interruption et la quantité de données qui pourrait être perdue ou devoir être reconstruite.
- Latence : réduire le temps de réponse pour des utilisateurs géographiquement dispersés. Le bénéfice dépend de leur emplacement et de la possibilité de traiter localement les opérations essentielles, notamment les données et les dépendances.
- Localisation des données : respecter des exigences de résidence, de traitement ou d’accès aux informations. Héberger des copies dans différents lieux peut compliquer les obligations applicables, plutôt que les résoudre ; celles-ci doivent être vérifiées pour chaque type de donnée.
Formuler l’objectif de manière mesurable évite d’adopter une solution par intuition. Pour la continuité, convenez d’objectifs de reprise pour le service et ses données. Pour la latence, mesurez les parcours réels des utilisateurs. Pour la résidence des données, déterminez quelles données doivent rester dans quels emplacements et quels composants les traitent.
Quand une région bien exploitée peut suffire
Une seule région peut suffire lorsque l’impact d’une interruption est acceptable, que les utilisateurs sont concentrés dans une zone ou que la latence actuelle répond aux besoins du produit. Cela peut également être l’option la plus raisonnable si l’équipe ne dispose pas encore des processus nécessaires pour tester et exploiter un deuxième emplacement.
Avant d’ajouter des régions, examinez les mesures de résilience disponibles dans l’architecture actuelle. Elles peuvent inclure la redondance entre zones, les sauvegardes, une procédure de restauration documentée, la surveillance des dépendances et une stratégie de déploiement réversible. Une sauvegarde ne protège que si elle peut être restaurée et si l’on a vérifié que le résultat permet de rétablir le service.
Analysez les incidents et les interruptions précédents : étaient-ils dus à une défaillance régionale, à une modification logicielle, à une dépendance externe ou à un problème de configuration ? Si le risque principal n’est pas régional, ajouter un autre emplacement pourrait accroître la charge de travail sans corriger la cause. Notez également le temps nécessaire à une reprise manuelle et les tâches qui dépendent encore d’une personne en particulier.
Coûts et risques liés à la répartition du service
La complexité multirégion ne se limite pas à la gestion de ressources supplémentaires. L’application peut nécessiter des choix concernant la réplication, la résolution des conflits, l’ordre des opérations et le comportement en cas de perte de connectivité. Si deux emplacements acceptent des modifications portant sur les mêmes informations, la conception doit préciser quelle est la source de vérité et comment traiter les écritures simultanées.
La cohérence est un choix de produit et d’architecture. Un délai de réplication peut amener un utilisateur à lire un état antérieur ou provoquer un conflit entre deux opérations. Ce comportement peut être acceptable dans certains cas, mais il ne faut pas supposer que toutes les fonctionnalités le tolèrent. Définissez les actions qui exigent une réponse cohérente immédiate et celles qui pourraient fonctionner temporairement avec des données retardées.
Il faut aussi examiner les dépendances externes, la gestion des identités, les files d’attente, le stockage, le DNS ou le routage, l’observabilité et les processus de déploiement. Chaque élément peut devenir un point de défaillance unique ou nécessiter une configuration par région. Les coûts d’exploitation comprennent les tests, les astreintes, l’analyse des incidents et la maintenance des procédures, en plus de l’infrastructure.
Évaluez si les parcours essentiels peuvent fonctionner dans chaque région
Cartographiez les actions essentielles des utilisateurs, de la requête initiale à la confirmation finale. Pour chaque parcours, notez les services et les données concernés, leur emplacement et ce qui se passerait si la région principale cessait de répondre. L’unité d’analyse est le parcours complet, et non un serveur isolé.
- Classez les fonctionnalités : distinguez celles qui sont indispensables au fonctionnement de celles qui peuvent être dégradées ou temporairement indisponibles.
- Cartographiez les dépendances : incluez les services internes, les systèmes externes et les processus opérationnels absents du schéma d’infrastructure.
- Décrivez la défaillance : analysez la perte totale, la connectivité partielle et la reprise. Précisez qui détecte le problème et comment est décidée la redirection du trafic.
- Validez les données : déterminez quelles écritures doivent être disponibles, quel délai est acceptable et comment les doublons ou les conflits seront résolus.
- Vérifiez le résultat : assurez-vous que les opérations visibles par l’utilisateur aboutissent, et pas seulement que les composants répondent.
Cette analyse permet de déterminer s’il existe une réelle indépendance entre les régions ou si le deuxième emplacement dépend de ressources qui restent dans la première. Elle permet aussi de privilégier une amélioration ciblée, comme rendre récupérable une dépendance critique, plutôt que de répliquer toute la plateforme.
Région secondaire ou service actif dans plusieurs régions
Une région secondaire destinée à la reprise vise généralement à rétablir le service en cas de défaillance de la région principale. L’équipe doit décider de ce qui reste prêt, de la manière dont cette région est activée et des données qui seront disponibles lors de la reprise. Le basculement peut nécessiter une intervention ; les délais réels doivent donc être testés plutôt que déduits de la conception.
Un service actif dans plusieurs régions peut gérer habituellement du trafic depuis plusieurs emplacements. Cette approche peut favoriser la latence ou la continuité, mais elle exige de résoudre les questions de routage, de répartition de charge et de comportement des données entre les régions. Cela ne signifie pas nécessairement que toutes les opérations sont indépendantes ni que le basculement en cas de défaillance sera automatique et correct.
Le choix dépend des objectifs convenus et de la capacité opérationnelle. Si le service tolère une reprise planifiée, une région secondaire peut suffire. S’il doit fonctionner en parallèle pour répondre aux exigences de disponibilité ou de rapidité, une configuration active peut être pertinente, à condition que ses règles de gestion des données et ses tests soient réalisables.
Décidez en vous appuyant sur des éléments concrets et progressez par étapes
Réunissez les équipes produit, technique et opérationnelle pour répondre à quatre questions : quel serait l’impact d’une interruption ? Où se trouvent les utilisateurs et les données ? Quelle reprise est acceptable ? Qui peut exploiter et tester l’architecture ? Consignez les hypothèses et les incertitudes. Si une question critique reste sans réponse, ce manque d’information constitue un risque à traiter avant d’étendre le déploiement.
Validez ensuite l’option la plus limitée qui permette d’apprendre. Il peut s’agir de mesurer la latence selon l’emplacement, de restaurer une sauvegarde dans un environnement séparé ou de tester la reprise d’une dépendance. Pour tester un basculement, définissez le périmètre, les responsables, les conditions de déclenchement et les critères de réussite ; examinez aussi comment revenir à la situation habituelle et réconcilier les données.
Réexaminez la décision si le profil des utilisateurs, les exigences relatives aux données, l’impact d’une interruption ou la composition du service évoluent. L’architecture adaptée est celle qui répond à des objectifs explicites et dont l’équipe peut démontrer la capacité de reprise. Plusieurs régions peuvent être la solution, mais elles ne constituent pas un objectif en soi : leur intérêt réside dans une amélioration vérifiable par rapport à une option plus simple.