

Un pilote numérique n’est ni une version réduite d’un déploiement complet ni une démonstration destinée à confirmer une décision déjà prise. Il s’agit d’un test contrôlé visant à réduire une incertitude précise : déterminer si une solution peut s’intégrer aux opérations, apporter une valeur mesurable et être maintenue avec un effort raisonnable.
Le périmètre détermine la qualité de l’apprentissage. Un pilote trop restreint peut fonctionner parce qu’il évite les conditions difficiles des opérations réelles. Un pilote trop large accumule les dépendances, les cas limites et la coordination jusqu’à devenir un déploiement déguisé. L’objectif consiste à sélectionner un échantillon qui représente le processus et ses frictions pertinentes, sans exposer toute l’organisation à un changement qui n’est pas encore validé.
Pour les responsables produit, métier, opérations et technologie, la décision clé n’est pas le nombre de personnes à inclure. Il s’agit de déterminer quelle hypothèse le pilote doit résoudre et quelles preuves suffiront pour prendre la décision suivante.
Commencez par la décision que le pilote doit permettre de prendre
Avant de choisir les utilisateurs ou les fonctionnalités, formulez la décision qui sera rendue possible à la fin du test. En l’absence de décision concrète, le pilote aura tendance à recueillir des avis généraux, des indicateurs sans lien entre eux et des demandes d’élargissement du périmètre.
Les décisions courantes consistent à étendre la solution à davantage d’équipes, à corriger une conception avant l’extension, à suspendre le projet jusqu’à la résolution d’une dépendance ou à écarter l’alternative évaluée. Chacune exige des preuves différentes. Par exemple, un pilote d’automatisation peut démontrer qu’il réduit le temps de traitement, sans nécessairement prouver que les données d’entrée sont d’une qualité suffisante pour passer à l’échelle.
Transformez l’initiative en hypothèses vérifiables
- Valeur : le nouveau flux réduit le temps, les erreurs, les contacts répétés ou le travail manuel dans un cas défini.
- Adoption : les participants peuvent accomplir la tâche sans recourir systématiquement à des canaux alternatifs.
- Faisabilité technique : les autorisations, les données et les intégrations se comportent de manière stable dans des conditions réelles.
- Exploitabilité : le support et les responsables peuvent détecter, traiter et résoudre les incidents sans improvisation.
- Sécurité et contrôle : les accès et le traitement des données respectent les règles applicables avant d’élargir l’exposition.
Évitez des objectifs tels que « valider l’outil » ou « tester l’expérience ». Ils sont trop larges. Une formulation utile serait : vérifier si l’équipe des opérations peut traiter des demandes standard au moyen du nouveau flux, avec une qualité égale ou supérieure au processus actuel et sans augmenter la charge de support.
Définissez une unité de test représentative
Le périmètre d’un pilote peut être délimité par les utilisateurs, le processus, le canal, la région, le type de cas, la source de données ou l’intégration. N’essayez pas de faire varier toutes ces dimensions simultanément. Sélectionnez une unité principale et maintenez les autres suffisamment stables pour pouvoir interpréter les résultats.
Si le risque principal concerne l’adoption, il est préférable de conserver un processus connu et de tester des profils d’utilisateurs différents. Si l’incertitude se concentre sur une intégration, limitez les participants et exposez la solution à des données et à des événements réels. Si vous évaluez un nouveau canal, gardez les types de demandes et le modèle opérationnel dans un périmètre limité.
Choisissez les participants selon leur diversité fonctionnelle, et non leur disponibilité
Les volontaires très motivés apportent des signaux précoces, mais représentent rarement le comportement quotidien. Incluez des participants qui reflètent la variabilité pertinente du processus : fréquence d’utilisation, niveau d’expérience, volume de travail, besoin d’approbation et dépendance envers d’autres systèmes.
- Incluez des utilisateurs habituels du processus afin de vérifier l’efficacité et la qualité dans des conditions normales.
- Incluez quelques profils moins expérimentés afin de détecter les problèmes de compréhension, de formation ou de conception.
- Incluez des responsables opérationnels capables d’évaluer les exceptions, l’impact sur les files d’attente et les changements de charge.
- Évitez de concentrer le pilote sur une seule équipe, un seul poste ou un seul responsable si le déploiement futur doit couvrir des conditions différentes.
- Excluez temporairement les groupes pour lesquels un incident aurait des conséquences disproportionnées, tant qu’une procédure de rétablissement n’a pas été validée.
La représentativité n’exige pas de reproduire toute l’organisation. Elle exige de couvrir les différences susceptibles de modifier la décision. Documentez les raisons du choix de ces participants et les segments qui restent exclus ; vous éviterez ainsi de présenter un résultat partiel comme une preuve universelle.
Incluez le flux principal et sélectionnez les exceptions avec discernement
Une erreur fréquente consiste à ne tester que le « parcours idéal » : données complètes, demandes standard, utilisateurs formés et systèmes disponibles. Le pilote doit inclure le flux qui génère la majeure partie de la valeur, mais également un ensemble limité de situations qui mettent ses limites à l’épreuve.
Classez les cas en trois groupes. Cette distinction protège les opérations et évite que la liste des exceptions ne transforme le pilote en projet sans fin.
- Cas essentiels : situations fréquentes, à fort volume ou critiques pour démontrer la proposition de valeur. Ils doivent être présents dès le départ.
- Cas diagnostiques : situations moins courantes susceptibles de révéler une faiblesse importante, comme une information incomplète, une approbation supplémentaire ou un changement de statut. Incluez-les lorsqu’une réponse sûre existe.
- Cas différés : exceptions rares, à fort impact, réglementées ou dépendantes de systèmes qui ne sont pas encore prêts. Excluez-les de la première phase, mais consignez leur volume, leur impact et leur traitement actuel.
Ne pas inclure une exception ne signifie pas l’ignorer. Un critère d’exclusion, une voie alternative et une date ou condition de réexamen doivent exister. Par exemple, si une demande nécessite une validation manuelle que l’intégration ne prend pas encore en charge, le participant doit savoir à quel moment la transmettre et qui prend le cas en charge.
Concevez des limites opérationnelles avant d’activer le test
Tout pilote nécessite des règles d’entrée et de sortie claires. Définissez quelles transactions, quels utilisateurs ou quelles données peuvent utiliser la nouvelle solution ; qui peut l’arrêter ; quels signaux déclenchent le retour en arrière ; et quelle est l’alternative manuelle sûre. Cette dernière ne doit pas être une note informelle : elle doit avoir été testée, être accessible et avoir un responsable.
Fixez également des limites de charge. Si le système traite des demandes, déterminez un volume initial maximal et une manière de contrôler la file d’attente. S’il automatise des décisions, limitez le type de décision, le montant, l’impact ou l’ensemble de données jusqu’à l’observation de résultats cohérents. Une limite explicite est un outil d’apprentissage, et non un signe de manque de confiance.
Résolvez les dépendances minimales qui rendent le résultat interprétable
Un pilote qui échoue peut révéler une solution inadaptée, mais aussi des autorisations mal configurées, des données incomplètes, une intégration instable ou un manque de suivi opérationnel. Il est impossible d’éliminer tous les risques, mais il est possible de séparer les blocages connus des hypothèses à évaluer.
Préparez une courte revue de préparation avec les équipes produit, opérations et technologie. Elle doit couvrir au minimum :
- Données : origine, qualité attendue, données obligatoires, traçabilité et traitement des informations sensibles.
- Accès : profils autorisés, principe du moindre privilège, ajout et retrait des participants.
- Intégrations : systèmes concernés, comportement en cas d’erreur, nouvelles tentatives, doublons et responsable de chaque interface.
- Support : canal d’aide, horaires, niveaux de priorité, délais de réponse et circuit d’escalade.
- Observabilité : événements, erreurs, changements de statut et indicateurs nécessaires à l’analyse d’un incident.
- Responsabilité : une personne responsable de la décision métier et une autre de la continuité technique et opérationnelle.
Lorsqu’une dépendance n’est pas prête, trois options sont valables : repousser le démarrage, réduire le périmètre pour l’éviter ou introduire une intervention manuelle contrôlée. La mauvaise option consiste à la masquer et à attribuer ensuite ses effets à l’expérience utilisateur ou à la performance de la solution.
Mesurez l’apprentissage, pas seulement l’usage ni la satisfaction
L’activité seule ne confirme pas la valeur. Un pilote peut enregistrer de nombreuses connexions tout en transférant le travail vers une autre équipe, en générant des reprises ou en fonctionnant grâce à une attention exceptionnelle. Combinez des indicateurs quantitatifs avec une analyse qualitative des cas.
- Adoption : proportion de participants qui terminent le flux et fréquence d’utilisation par rapport au processus précédent.
- Qualité : erreurs, corrections, doublons, abandons et respect des règles du processus.
- Temps : durée de la tâche, attente entre les étapes et délai total jusqu’à la résolution.
- Effort opérationnel : interventions manuelles, contacts avec le support, heures de suivi et charge transférée.
- Fiabilité : échecs d’intégration, disponibilité perçue, rétablissements et récurrence des incidents.
Établissez une référence avant de commencer. En l’absence de données historiques fiables, mesurez un échantillon du processus actuel sur une période limitée. Définissez ensuite un rythme de revue : un suivi fréquent des incidents et une revue de décision à la fin de la période ou après avoir atteint un volume de cas suffisant.
Appliquez des critères de sortie et approuvez le périmètre avant le démarrage
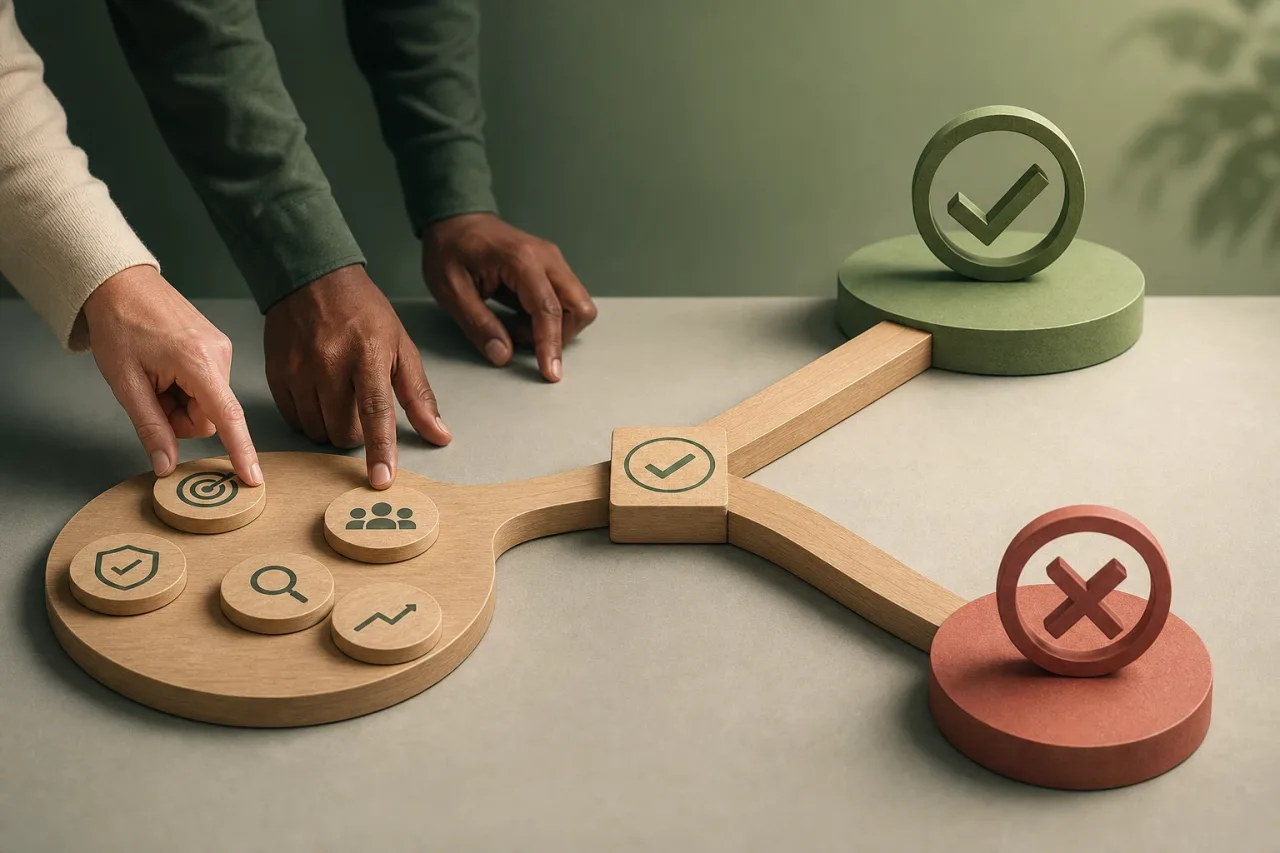
Les critères de sortie doivent être convenus avant de connaître le résultat. Il n’est pas nécessaire de fixer un chiffre artificiel pour chaque indicateur, mais il faut définir quelle combinaison de signaux justifierait chaque orientation.
- Étendre : le flux principal apporte de la valeur, les participants l’utilisent de façon durable, les erreurs restent gérables et les opérations peuvent absorber l’augmentation.
- Reconcevoir : il existe un intérêt ou une valeur potentielle, mais des frictions répétées liées à l’expérience, aux données, à la formation ou à l’intégration empêchent une extension sûre.
- Suspendre : une dépendance critique, un risque de sécurité ou une charge opérationnelle imprévue empêche d’obtenir des preuves valides.
- Écarter : même dans des conditions contrôlées, la solution n’améliore pas le processus ou exige un effort supérieur au bénéfice attendu.
Avant d’activer le pilote, confirmez qu’il existe une hypothèse prioritaire, un groupe représentatif, des cas essentiels et diagnostiques définis, des exclusions documentées, des responsables désignés, un support actif, une alternative manuelle testée, des indicateurs avec une référence et une réunion de décision planifiée. Si l’un de ces éléments manque, le périmètre n’est pas encore prêt.
Un bon pilote ne cherche pas à démontrer que tout fonctionnera. Il vise à révéler rapidement, avec un risque limité, ce qui doit être conservé, corrigé ou écarté avant de passer à l’échelle.