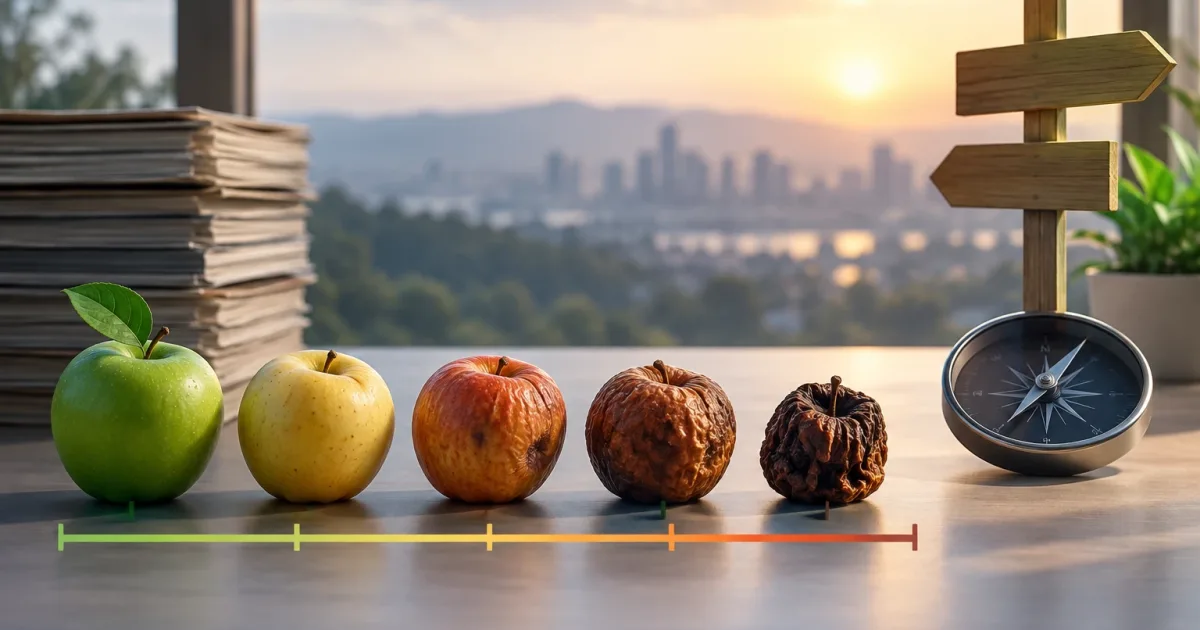
Une donnée peut être exacte et pourtant conduire à une mauvaise décision si elle arrive trop tard. Un tableau de bord des ventes actualisé toutes les heures peut suffire à analyser des tendances, mais pas forcément à gérer les stocks ou à déclencher une action automatique. Déterminer quand un chiffre n’est plus fiable ne consiste donc pas à imposer une fréquence unique à toute l’entreprise : il faut mettre en relation l’ancienneté de l’information et l’usage qui en sera fait.
Une politique de fraîcheur transforme cette relation en critères opérationnels. Elle définit le retard acceptable, la manière de le détecter et de le signaler, ainsi que la conduite à tenir si le seuil est dépassé. L’objectif n’est pas seulement de disposer de données plus récentes, mais aussi de prendre de meilleures décisions et de permettre aux équipes de savoir quand faire confiance aux informations, émettre une réserve ou interrompre un processus.
La fraîcheur dépend de la décision, pas du système
La question utile n’est pas « à quelle fréquence cette table est-elle actualisée ? », mais « quelle décision prend-on à partir de ces données et quelles conséquences peut avoir l’utilisation d’informations anciennes ? ». Un même jeu de données peut alimenter un rapport de planification, une vue de suivi et une opération exécutée sans contrôle humain. Chacun de ces usages peut nécessiter une tolérance différente.
Commencez par identifier les décisions et les processus qui dépendent de chaque jeu de données. Notez qui agit, à quelle fréquence et ce qui se passe si les données arrivent en retard ou ne sont pas disponibles. Tenez compte à la fois des conséquences d’une action erronée et du coût de l’attente : interrompre un processus au moindre retard peut aussi générer du travail inutile.
- Décisions exploratoires : elles tolèrent souvent davantage de retard si les utilisateurs connaissent la date d’actualisation et ne prennent pas le chiffre pour un état en temps réel.
- Opérations quotidiennes : l’actualisation doit être adaptée au rythme auquel les tâches, commandes ou incidents sont examinés.
- Actions automatisées ou à fort impact : elles nécessitent des seuils explicites, des contrôles supplémentaires et une réponse définie en cas de données en retard.
Ne partez pas du principe que « plus rapide » signifie toujours « meilleur ». Des mises à jour fréquentes peuvent accroître la charge, les coûts ou les échecs d’intégration sans améliorer la décision. Recherchez la fréquence minimale qui permet de maintenir l’usage à un niveau de risque acceptable.
Distinguez le moment de l’événement de celui où la donnée devient disponible
Les désaccords sur la fraîcheur commencent souvent parce que les équipes désignent des moments différents par le terme « actualisation ». Il est utile de distinguer au moins trois horodatages :
- Heure de l’événement : moment où le fait s’est produit dans le système source, par exemple lorsqu’une vente a été enregistrée.
- Heure de mise à jour : moment où la source ou le processus d’intégration a modifié ou traité l’enregistrement.
- Moment de disponibilité : moment où la donnée est devenue accessible dans le rapport, le produit ou le processus qui l’utilise.
L’écart entre ces moments aide à localiser le retard. Si l’événement est enregistré tardivement dans la source, le problème ne vient pas nécessairement du transfert. Si la source est à jour, mais pas le tableau de bord, il faut examiner le processus qui achemine les informations jusqu’à leur utilisateur. Sans cette distinction, une fréquence technique peut être respectée alors que la personne concernée consulte toujours un état ancien.
Définissez également ce que signifie « donnée à jour » pour chaque utilisateur. La fin d’un processus ne garantit pas toujours que tous les enregistrements sont complets ou disponibles. En cas de synchronisations par lots, de fenêtres de chargement ou de dépendances entre systèmes, documentez ces limites et évitez de présenter un chiffre comme instantané s’il ne l’est pas.
Fixez les tolérances en fonction de l’impact, de la variabilité et des délais attendus
Le seuil doit tenir compte des conséquences d’une décision fondée sur des informations dépassées et du comportement réel du flux de données. Analysez le délai habituel d’arrivée des données, sa variabilité et le retard que le processus peut tolérer. Un chiffre isolé ne suffit pas : une mise à jour généralement rapide, mais souvent défaillante, présente un risque différent d’une mise à jour plus lente, mais stable et prévisible.
Pour chaque usage, consignez trois repères pratiques : le retard attendu, le retard maximal tolérable et le moment où une intervention devient nécessaire. Le retard maximal tolérable est la limite au-delà de laquelle la donnée ne peut plus servir à la décision concernée. Le moment d’intervention peut être antérieur s’il est préférable de donner l’alerte avant d’atteindre cette limite.
Vérifiez ces limites avec les équipes métier et opérationnelles. Demandez quelle décision changerait si la donnée avait une heure de plus, quelles seraient les conséquences d’une erreur et s’il existe une autre source. Lorsque l’impact est important, ne vous appuyez pas uniquement sur une tolérance temporelle : ajoutez une validation de la donnée ou une confirmation humaine avant de déclencher une action.
Évitez de reprendre le même seuil pour tous les rapports par simple commodité. Deux processus peuvent partager une source tout en présentant des risques différents : ils doivent pouvoir suivre des règles distinctes. De même, une donnée peu critique peut nécessiter un avertissement clair, même si son retard ne compromet pas une opération sensible.
Rendez l’état visible et définissez la réponse en cas de dépassement
Il ne suffit pas de mesurer la fraîcheur en interne : les personnes qui prennent les décisions doivent pouvoir savoir si les informations sont à jour. Dans l’interface ou le rapport, affichez une indication compréhensible, telle que « mis à jour à 10 h 15 » ou « données en retard ». Évitez les expressions ambiguës comme « en temps réel » si vous ne pouvez pas les garantir tout au long du parcours de la donnée.
Définissez des états simples qui indiquent la conduite à tenir, et pas seulement ce qui s’est passé :
- À jour : la donnée respecte la tolérance et peut être utilisée pour l’objectif prévu.
- À risque ou en retard : la fenêtre d’actualisation attendue est dépassée ; l’utilisateur en est informé et sait s’il doit vérifier les données avant d’agir.
- Obsolète ou indisponible : la limite tolérable est atteinte ; la donnée n’est pas présentée comme valide pour la décision concernée.
La réponse au dépassement dépend du niveau de risque. Pour une analyse de suivi, un avertissement accompagné de l’heure de la dernière actualisation peut suffire. Un processus opérationnel peut recourir à une autre source préalablement validée. Une automatisation susceptible d’avoir des conséquences importantes peut suspendre l’action et la soumettre à un contrôle humain. La réponse doit être décidée avant l’incident, et non improvisée alors que le système utilise déjà des données anciennes.
Exemple hypothétique : un tableau de bord et une action opérationnelle
Imaginons qu’une équipe utilise les ventes dans un tableau de bord de suivi et pour déclencher un réapprovisionnement automatique. Le tableau de bord sert à observer l’évolution et à préparer des réunions : il peut tolérer un retard connu, à condition d’afficher clairement l’heure de l’actualisation et de ne pas être utilisé comme un état instantané des stocks.
Le réapprovisionnement, en revanche, dépend d’un niveau de stock susceptible de changer rapidement. Si les informations dépassent la tolérance convenue, le système peut s’abstenir de générer automatiquement la commande et demander une vérification. La donnée source est identique, mais le coût d’une erreur et la réponse appropriée diffèrent. Les valeurs précises du seuil doivent être convenues avec les personnes qui gèrent le processus, et non reprises d’un exemple.
Attribuez les responsabilités et révisez la politique
Une politique est efficace lorsque les responsabilités sont clairement attribuées. L’équipe responsable du processus définit la décision à protéger et le retard qu’elle peut tolérer. Le responsable des données ou de l’intégration convient de la manière de mesurer leur parcours et de diagnostiquer les incidents. Les équipes produit ou opérationnelles veillent à présenter l’état de façon compréhensible et à appliquer la réponse prévue. Dans une petite équipe, une même personne peut assumer plusieurs fonctions ; l’essentiel est qu’aucune responsabilité ne reste sans titulaire.
Réexaminez les seuils en cas d’évolution du processus, de la fréquence des décisions, des sources ou des conséquences d’une erreur. Il est également utile de les analyser après des retards répétés : le seuil est peut-être mal calibré, l’intégration ne tient pas ses engagements ou le processus ne devrait plus dépendre de cette source. Une pratique cohérente de gestion des données, telle que celle abordée par DAMA International dans son corpus de connaissances, aide à traiter les définitions, les responsabilités et la qualité comme des éléments de l’exploitation, et non comme une documentation isolée.
Liste de contrôle pour définir la fraîcheur
- Énumérez les décisions et les processus qui utilisent la donnée.
- Identifiez les personnes qui prennent les décisions et les conséquences d’une action fondée sur des informations en retard.
- Distinguez l’heure de l’événement, l’actualisation dans la source et la disponibilité pour l’utilisateur.
- Consignez le retard habituel, le maximum tolérable et le moment où intervenir.
- Définissez comment l’état sera mesuré et où sera affichée l’heure de la dernière actualisation.
- Convenez de la conduite à tenir : avertir, vérifier, utiliser une autre source ou suspendre le processus.
- Attribuez les responsabilités et déterminez quand réexaminer les critères.
Si l’équipe ne peut pas préciser qui utilise la donnée, combien de temps elle reste fiable et ce qui se passe lorsqu’elle arrive en retard, sa fraîcheur n’est pas encore définie. Répondre à ces trois questions permet de passer d’une fréquence technique à une règle métier vérifiable et utile.