

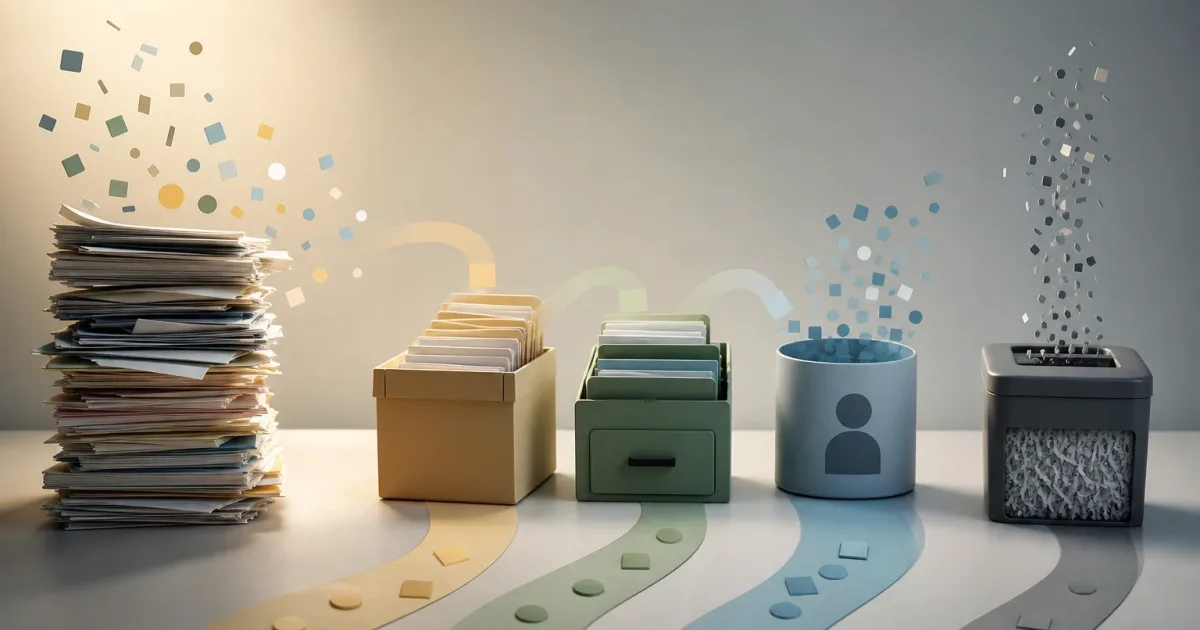
Conserver les données par défaut peut sembler une décision prudente : elles pourraient être utiles plus tard, aider à traiter un incident ou permettre de mieux comprendre les utilisateurs. Pourtant, une accumulation sans règles transforme les bases de données, les entrepôts analytiques, les journaux techniques et les outils d’assistance en charge opérationnelle. Les coûts de stockage et de migration augmentent, les possibilités d’accès se multiplient et il devient plus difficile de distinguer une preuve utile d’une information obsolète.
Une politique de conservation des données utile ne consiste pas à fixer une durée universelle. Il s’agit d’un ensemble de décisions vérifiables sur les informations nécessaires, le processus auquel elles servent, la personne qui en est responsable, la durée pendant laquelle elles peuvent être accessibles et la façon de les retirer sans affecter le produit. L’objectif n’est ni de supprimer au plus vite ni de conserver indéfiniment : il est de ne garder que ce qui est nécessaire, avec une traçabilité suffisante et un retrait maîtrisé.
Le problème de conserver les données par inertie
Les données sont créées à de nombreux endroits dans le produit : formulaires, événements d’utilisation, commandes, conversations d’assistance, intégrations, erreurs applicatives, sauvegardes et exportations manuelles. Lorsque chaque équipe décide de manière isolée, des répliques aux cycles de vie incompatibles apparaissent. Un enregistrement peut avoir été supprimé du système transactionnel tout en restant disponible dans un outil d’analytique, un index de recherche ou une sauvegarde restaurable.
Cette situation génère des risques concrets. Les équipes d’assistance peuvent consulter des informations qui ne reflètent plus la réalité. Les rapports peuvent combiner des périodes historiques avec des définitions qui ont changé. Les migrations s’allongent parce qu’elles déplacent des tables et des fichiers qui n’ont plus de valeur actuelle. Et une demande de suppression devient difficile à exécuter parce que personne ne connaît tous les emplacements de la donnée.
Le premier signe à diagnostiquer est que personne ne peut répondre avec précision à la question de savoir où vit une donnée, quel service la consomme ou qui approuve sa suppression. D’autres signes fréquents sont :
- des tables, champs ou tableaux de bord sans propriétaire identifié ;
- des copies d’exportations partagées pour répondre à des besoins ponctuels ;
- des journaux techniques contenant des identifiants personnels pendant des périodes indéfinies ;
- des processus de suppression manuels, exceptionnels ou dépendant d’une seule personne ;
- des métriques historiques impossibles à reproduire, car leur source ou la transformation appliquée est inconnue.
Ce que signifie réellement conserver une donnée
Avant d’attribuer des durées, il est utile de séparer des catégories souvent confondues. Une donnée active permet d’exploiter le service actuel : une adresse de livraison valide, le statut d’une commande ou une préférence nécessaire à une fonctionnalité. Un historique enregistre des faits passés pertinents pour l’analyse, l’assistance ou le rapprochement. Une preuve documente une action ou une modification et peut être nécessaire pour démontrer la manière dont une opération s’est produite.
Il existe aussi des sauvegardes et des journaux techniques. Une sauvegarde est conçue pour rétablir la disponibilité ou l’intégrité après un incident ; elle ne devrait pas devenir un dépôt destiné à la consultation courante. Les journaux techniques aident à diagnostiquer des défaillances, à enquêter sur des comportements anormaux et à mesurer la santé des systèmes, mais ils peuvent contenir des identifiants, paramètres ou messages exigeant des contrôles spécifiques.
La distinction est importante, car chaque catégorie appelle une réponse différente. Supprimer une donnée du produit ne signifie pas nécessairement qu’elle disparaît instantanément de toutes les sauvegardes, mais ce délai doit être défini, limité et ne pas permettre un accès opérationnel normal. De même, conserver une métrique agrégée ne requiert pas de garder le détail individuel qui l’a produite si ce détail n’est plus nécessaire.
Les cinq questions pour décider du cycle de vie
Pour chaque ensemble de données, posez les mêmes questions. Cela évite les décisions fondées sur l’intuition et permet de comparer différents systèmes dans un langage commun.
- Quelle est la finalité précise ? Décrivez le processus, et non une formule générique telle que « au cas où ». Par exemple : résoudre des incidents liés à des commandes, prévenir les doublons, calculer une métrique mensuelle ou restaurer le service après une défaillance.
- Quelle dépendance opérationnelle existe ? Identifiez les services, rapports, intégrations, automatisations et équipes qui utilisent cette donnée. Distinguez une dépendance confirmée d’une possibilité non validée.
- Quel niveau de détail est nécessaire ? Le processus a peut-être besoin d’un identifiant pseudonymisé, d’un état agrégé ou d’une date, mais pas du contenu complet d’une conversation ni de tous les attributs d’un profil.
- Que se passe-t-il si la donnée est conservée ou supprimée ? Évaluez l’impact sur les opérations, la sécurité, l’expérience utilisateur, l’analyse et la restauration. Si la suppression empêche une fonction essentielle, la conservation doit être justifiée ; si elle n’apporte qu’un confort hypothétique, une réduction est envisageable.
- Comment le retrait sera-t-il exécuté et vérifié ? Définissez le mécanisme technique, le traitement des répliques, le journal d’exécution et la preuve qui confirme le résultat.
Si une finalité n’a ni responsable ni processus associé, elle ne devrait pas justifier une conservation indéfinie. Lorsqu’il existe des exigences contractuelles, légales ou réglementaires applicables, elles doivent être traduites en règles concrètes et examinées par les personnes responsables de la conformité ou du conseil juridique. La politique opérationnelle ne remplace pas cet examen ; elle permet de l’appliquer de manière cohérente.
Classer selon la finalité, la sensibilité et l’accès
Une classification légère est plus durable qu’une taxonomie excessivement détaillée. Elle peut associer trois axes : la finalité opérationnelle, la sensibilité et le mode d’accès. La finalité établit pourquoi la donnée existe ; la sensibilité détermine les contrôles et la minimisation nécessaires ; l’accès indique si elle est consultée quotidiennement, exceptionnellement ou uniquement pour la restauration.
Par exemple, les données clients peuvent comprendre l’identité, les coordonnées, les préférences et l’activité. Les commandes peuvent nécessiter une trace transactionnelle pendant une période définie. Les conversations d’assistance peuvent être utiles tant qu’un incident ou une relation d’assistance existe, mais leur contenu ne doit pas nécessairement être conservé aussi longtemps que les métriques de volume des demandes. Dans les journaux applicatifs, remplacer les identifiants directs par des références techniques ou appliquer un filtrage des champs peut réduire l’exposition sans perdre la capacité de diagnostic.
Quatre options de traitement
- Conserver en actif : utilisez cette option lorsqu’un processus actuel doit consulter et modifier fréquemment la donnée.
- Archiver : conservez la donnée avec un accès restreint et hors du flux habituel lorsqu’elle n’est nécessaire que pour des consultations exceptionnelles ou des historiques définis.
- Anonymiser ou agréger : supprimez ou transformez la possibilité de relier l’information à une personne lorsque les tendances, décomptes ou analyses de comportements collectifs suffisent. Vérifiez que la transformation ne permet pas une réidentification raisonnablement prévisible dans votre contexte.
- Supprimer : retirez la donnée lorsqu’elle n’a plus de finalité active ni de dépendance justifiée. Incluez les index, caches, exportations gérées et flux dérivés dans le périmètre de l’examen.
La pseudonymisation mérite une distinction : remplacer un identifiant par un autre réduit l’exposition dans certains flux, mais n’équivaut pas nécessairement à une anonymisation s’il existe encore une voie raisonnable de rattachement.
Dépendances et retrait sécurisé avant suppression
L’erreur la plus coûteuse consiste à exécuter une suppression sans comprendre les dépendances. Avant d’activer une règle automatique, examinez les requêtes de rapports, les tâches planifiées, les API, les files d’événements, les outils d’assistance, les moteurs de recherche et les modèles analytiques. Il ne suffit pas d’interroger les équipes : combinez cette démarche avec des inventaires techniques, l’observabilité et des tests dans un environnement contrôlé lorsque cela est possible.
Un retrait sécurisé suit généralement cette séquence :
- Inventorier les emplacements principaux, les répliques et les destinations dérivées.
- Étiqueter les consommateurs et confirmer la donnée minimale dont chacun a besoin.
- Définir une date ou une condition d’expiration lisible par les systèmes et les personnes.
- Tester la règle sur un échantillon ou dans un environnement hors production.
- Appliquer la suppression, l’archivage ou la transformation de manière automatisée et reproductible.
- Vérifier que les consommateurs attendus fonctionnent toujours et que la donnée n’apparaît plus dans les emplacements prévus.
- Consigner l’exécution, les exceptions approuvées et la prochaine révision.
Les sauvegardes nécessitent une règle distincte : documentez leur période de rotation, les personnes autorisées à les restaurer et la façon d’éviter qu’une restauration ne réintroduise des données retirées dans l’environnement opérationnel sans contrôles. Si une sauvegarde est restaurée, l’équipe doit savoir quelles tâches de synchronisation ou de retrait ultérieur sont nécessaires.
Construire une matrice de conservation exploitable
La matrice de conservation constitue le lien entre la décision métier et sa mise en œuvre. Elle doit être simple à maintenir et suffisamment précise pour que les équipes produit, données, infrastructure et opérations interprètent la même règle. Attribuez un propriétaire de la finalité et un autre de l’implémentation ; ils peuvent être la même personne, mais leurs responsabilités sont différentes.
ensemble de données | finalité | propriétaire | emplacement | consommateurs
niveau d’accès | condition d’expiration | traitement | méthode | révision
Dans un service connecté, une matrice hypothétique pourrait distinguer trois cas. Les données des clients actifs sont conservées tant qu’elles sont nécessaires à l’exploitation du compte et sont réexaminées lorsque son statut change. Les commandes sont maintenues selon la finalité transactionnelle définie, avec un accès limité aux équipes qui traitent les incidents et les rapprochements. Les conversations d’assistance disposent de leur propre règle : le contenu est retiré ou transformé après la période convenue, tandis que les indicateurs agrégés de volume et de délai peuvent rester disponibles pour analyser les opérations.
La qualité d’une politique se mesure à son exécution : règles automatiques, exceptions avec date d’expiration, preuves de révision et alertes lorsqu’un processus échoue. Réexaminez la matrice lors de changements de produit, de nouvelles intégrations, de refontes analytiques, de migrations ou d’incidents. La conservation cesse ainsi d’être une tâche réactive pour devenir une capacité du produit et des opérations : conserver ce qui apporte une valeur démontrable et retirer ce qui n’ajoute que coût, exposition et complexité.