

Concevoir un événement d’intégration semble être une décision technique, mais cela détermine l’autonomie des équipes, la résilience opérationnelle et la qualité des informations reçues par chaque processus. Lorsqu’un CRM, un ERP, un site e-commerce et une plateforme de service client échangent des événements, une question revient fréquemment : le message doit-il inclure toutes les données nécessaires ou seulement une référence permettant de les consulter dans le système source ?
Il n’existe pas de réponse universelle. Un événement trop succinct oblige à réaliser des consultations en chaîne et transforme le système source en dépendance permanente. Un événement trop riche duplique les informations, peut propager des données personnelles inutiles et risque de contenir une version déjà obsolète. L’alternative efficace consiste à décider champ par champ, selon l’usage réel du consommateur et les conditions d’exploitation.
Les trois options pour transporter du contexte
Un événement peut fournir du contexte de trois façons. Chaque modèle résout des problèmes différents et introduit également des coûts qui doivent être assumés explicitement.
Événement avec données complètes
Le message comprend les informations dont le consommateur a besoin pour exécuter son action. Par exemple, un événement de commande confirmée peut transporter les lignes de commande, l’adresse de livraison, le canal de vente et un instantané des montants confirmés.
- Il convient de l’utiliser lorsque le consommateur doit agir immédiatement, lorsque la valeur envoyée doit être conservée comme preuve historique ou lorsque la disponibilité du système source ne sera pas garantie.
- Il réduit les appels ultérieurs, la latence et le couplage à l’exécution.
- Il exige de définir ce que représente l’information : généralement un instantané au moment de l’événement, et non l’état actif actuel de l’enregistrement.
- Il augmente la taille du message, la complexité du contrat et la surface d’exposition des données.
Événement avec identifiant et consultation ultérieure
Le message contient un identifiant, le type d’événement et des métadonnées minimales ; le consommateur consulte ensuite une API ou une réplique autorisée. Cette approche convient s’il a besoin de la donnée à jour plutôt que d’une photographie historique.
- Il convient de l’utiliser pour les attributs volatils, les catalogues volumineux ou les informations dont le consommateur n’a besoin que dans des cas exceptionnels.
- Il évite de distribuer des copies de données qui changent fréquemment.
- Il introduit une dépendance à la disponibilité, aux autorisations, aux limites de consommation et à la latence du système source.
- Il peut produire des consultations en cascade : un service consulte la commande, puis le client, ensuite le produit et enfin le stock. Cette chaîne est souvent fragile et difficile à diagnostiquer.
Modèle hybride
Dans la plupart des intégrations matures, le meilleur résultat est hybride : l’événement transporte un noyau autonome permettant d’exécuter le flux et des références pour l’enrichir si nécessaire. Une commande peut inclure son identifiant, sa date, son statut confirmé, ses montants, ses articles et sa destination logistique, tout en ne fournissant que l’identifiant client afin de consulter les préférences de contact actuelles si une communication l’exige.
La règle n’est ni « envoyer peu » ni « envoyer tout » : envoyez ce qui est nécessaire pour accomplir de manière fiable la décision déclenchée, et fournissez des références pour les données qui doivent être actuelles, sont coûteuses ou ne sont pas autorisées pour tous les destinataires.
Critères de décision pour chaque champ
La bonne unité de décision n’est pas l’événement entier, mais chaque attribut. Un même événement peut contenir des données immuables, volatiles, sensibles et dérivées, qui nécessitent des traitements opposés.
- Immédiateté : si le consommateur doit agir avant de pouvoir consulter une API, la donnée doit être transmise. La logistique ne devrait pas attendre une consultation supplémentaire pour connaître l’adresse validée à utiliser lors de l’expédition.
- Actualité : si la décision requiert la dernière valeur disponible, une référence est préférable. Les préférences de communication ou le statut actuel d’un compte peuvent changer après la commande.
- Valeur historique : s’il est utile de reconstituer ce qui était connu lorsqu’un fait s’est produit, incluez un instantané daté. Le prix accepté et les taxes appliquées ne doivent pas être réinterprétés à partir du catalogue actuel.
- Volume et fréquence : les images, descriptions longues, documents ou structures volumineuses ont rarement leur place dans le message principal. Envoyez une référence stable, une version et, le cas échéant, un résumé.
- Disponibilité : si une panne du système source bloquerait un processus critique, l’événement doit fournir le minimum nécessaire pour fonctionner en mode dégradé de manière sûre.
- Autorisations : tous les consommateurs qui connaissent un identifiant ne doivent pas recevoir des données personnelles, financières ou internes. L’événement ne doit pas contourner le modèle d’autorisation des systèmes.
- Traçabilité : toute valeur déterminante doit indiquer de quelle version ou de quel moment elle provient. Un champ sans contexte temporel peut conduire à des décisions erronées.
Classez également les données. Les données immuables, telles qu’un identifiant de commande ou une date de création, sont de bonnes candidates à la transmission. Les données volatiles, comme la disponibilité du stock, requièrent généralement une consultation ou un événement spécifique de mise à jour. Les données sensibles doivent être minimisées, limitées selon l’audience et protégées conformément aux politiques applicables. Les données dérivées, comme une segmentation ou un score, doivent indiquer leur règle, leur version ou leur durée de validité afin de ne pas sembler être des faits permanents.
Matrice pratique et modèles de conception
Avant d’ajouter un champ au contrat, les équipes métier, produit et technologie peuvent l’évaluer à l’aide de ces questions. Si plusieurs réponses sont affirmatives dans la première partie, il devrait probablement être inclus ; si celles de la seconde partie prédominent, il est préférable de le référencer.
- Le consommateur ne peut-il pas accomplir son action sans cette valeur ?
- La version exacte valable lors de la production de l’événement doit-elle être conservée ?
- Une consultation ultérieure peut-elle échouer ou arriver trop tard ?
- Cette donnée est-elle petite et stable pendant le cycle de vie du processus ?
- Change-t-elle fréquemment ou n’est-elle nécessaire que dans des cas particuliers ?
- Contient-elle des données sensibles dont le consommateur n’a pas explicitement besoin ?
- Existe-t-il une source autorisée et disponible pour la consulter ultérieurement ?
- Le consommateur peut-il tolérer une réponse différée, un cache ou une vérification manuelle ?
Cette évaluation fait émerger trois modèles utiles :
- Instantané traçable : transportez la donnée et ajoutez
occurred_at, un identifiant d’événement, la version du schéma et, lorsque cela s’applique, la version de la ressource. Ce modèle est idéal pour les montants, les conditions acceptées et la destination opérationnelle. - Référence enrichissable : envoyez un identifiant stable, le type de ressource et, s’il existe, une version. Le consommateur consulte uniquement lorsqu’il en a besoin et enregistre la réponse qu’il a utilisée.
- Données minimales avec cache contrôlé : incluez une sélection minimale et autorisez l’enrichissement depuis une copie de lecture dont la durée d’expiration est définie. Ce modèle est utile pour les catalogues ou profils non sensibles lorsqu’un léger retard est acceptable.
Un contrat simple peut exprimer clairement la différence entre un fait et une information à consulter :
{
  "event_id": "evt_123",
  "event_type": "order.confirmed",
  "occurred_at": "2025-03-08T10:30:00Z",
  "order": {
    "id": "ord_456",
    "total_confirmed": 125.00,
    "delivery_address_snapshot": { "country": "ES" }
  },
  "customer_ref": { "id": "cus_789" }
}
L’adresse incluse est un instantané opérationnel ; l’identifiant client permet de consulter des attributs actuels avec autorisation. Il ne faut pas interpréter cela comme signifiant que tous les champs du client étaient valides ou approuvés au moment de la commande.
Disponibilité, défaillances et fonctionnement dégradé
Choisir la consultation ultérieure impose de concevoir ce qui se produira lorsque cette consultation échoue. Il ne suffit pas d’implémenter une nouvelle tentative automatique : une indisponibilité persistante peut générer des doublons, saturer l’API source et bloquer des files d’attente entières.
Définissez le comportement dégradé avant de publier l’événement. Pour chaque consommateur, convenez s’il peut traiter avec des données minimales, réessayer plus tard, passer dans une file d’exceptions ou nécessiter une intervention manuelle. Le service client peut ouvrir un dossier avec des informations partielles ; la logistique devra peut-être retenir l’expédition si une adresse vérifiable manque.
- Utilisez des identifiants d’événement et l’idempotence pour qu’une nouvelle tentative n’exécute pas deux fois la même action.
- Séparez les erreurs temporaires des erreurs permanentes, comme une référence inexistante ou des autorisations insuffisantes.
- Évitez les nouvelles tentatives synchronisées et illimitées qui amplifient un incident du système source.
- Surveillez le retard des files d’attente, les erreurs d’enrichissement, l’âge de la dernière donnée consultée et le pourcentage de traitement dégradé.
- Conservez un circuit de vérification pour les décisions bloquées, avec le motif et l’événement d’origine disponibles pour l’audit.
Versionnement, sécurité et gouvernance du contrat
Les contrats d’événements évoluent. Ajouter un champ facultatif est généralement moins risqué que modifier la signification d’un champ existant, rendre obligatoire un champ facultatif ou supprimer une information qu’un consommateur supposait disponible. La compatibilité ne consiste pas seulement à pouvoir lire le message ; elle exige également d’en préserver la signification métier.
Désignez un responsable pour chaque champ et documentez son origine, sa classification, sa sémantique, son format, sa validité et les consommateurs autorisés. Incluez une version de schéma et traitez les changements sémantiques importants comme de nouvelles versions ou de nouveaux types d’événements. Ne réutilisez pas un nom pour exprimer autre chose : un champ nommé status sans catalogue de valeurs ni définition temporelle est une source fréquente d’interprétations incompatibles.
En matière de sécurité, appliquez la minimisation des données. Un événement diffusé par une infrastructure partagée peut atteindre davantage de consommateurs que prévu initialement. N’incluez pas de données personnelles « au cas où », de secrets, d’identifiants d’accès ou d’attributs sans finalité précise. Si un processus nécessite des informations sensibles, envisagez un canal restreint ou une consultation autorisée plutôt que leur propagation dans un événement général.
Exemple : commande pour la logistique, le service client et les communications
Imaginez qu’une commande confirmée active trois flux. La logistique a besoin des articles, des quantités, de l’adresse d’expédition validée, de la méthode de livraison et de la date de confirmation. Ces données doivent être transmises sous forme d’instantané, car elles permettent de préparer l’envoi même si le site e-commerce devient indisponible.
Le service client a besoin de l’identifiant de commande, de son statut et de la référence client. Il peut consulter l’historique client à jour lorsqu’il traite un incident, à condition d’en avoir l’autorisation. Les communications transactionnelles requièrent le type d’événement et une référence autorisée vers le destinataire, mais elles n’ont pas besoin de recevoir l’intégralité de la commande ni le profil complet du client.
Cette séparation réduit l’exposition et évite qu’un événement unique ne devienne une réplique accidentelle du CRM ou de l’ERP. Elle clarifie aussi les responsabilités : le site e-commerce émet le fait confirmé, la logistique utilise l’instantané nécessaire à l’exécution, et chaque canal consulte uniquement le contexte actuel qui le concerne.
Checklist de décision avant publication
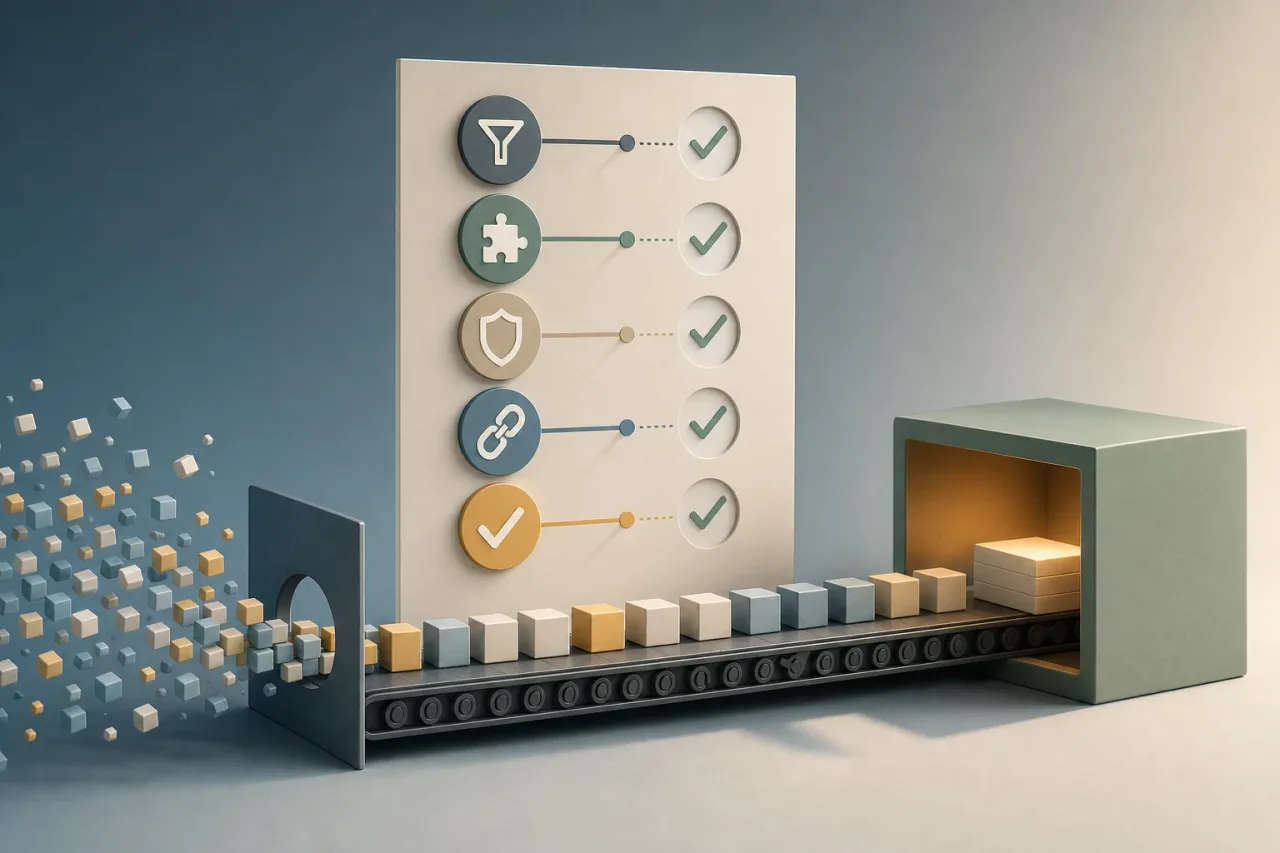
- L’événement décrit-il un fait survenu ou tente-t-il de répliquer l’état complet d’un autre système ?
- Chaque champ a-t-il un consommateur, une finalité et un responsable identifiés ?
- Est-il clair quels champs sont des instantanés et lesquels doivent être consultés comme état actuel ?
- Les données sensibles ont-elles été minimisées et les autorisations d’accès définies ?
- Le processus continue-t-il, est-il différé ou escaladé manuellement si l’enrichissement échoue ?
- Existe-t-il un identifiant d’événement, une date de survenue, l’idempotence et une version de schéma ?
- Les consommateurs peuvent-ils ignorer de nouveaux champs sans dysfonctionner ?
- Des métriques et des alertes permettent-elles de détecter les consultations échouées, les retards et les messages non traités ?
La bonne décision transforme l’événement en contrat métier fiable, et non en conteneur arbitraire de données. Envoyez suffisamment de contexte pour que le fait puisse créer de la valeur de manière autonome ; consultez ce qui doit être à jour, est sensible ou n’est pas indispensable. Vous réduirez ainsi le couplage sans sacrifier la traçabilité ni la continuité opérationnelle.