Un message en échec ne doit pas toujours être réessayé immédiatement ni conservé indéfiniment. Une notification de paiement en attente, une mise à jour de stock et un rappel de rendez-vous n’ont ni la même urgence ni la même valeur lorsqu’ils arrivent en retard. Décider combien de temps réessayer les messages en échec relève donc autant des choix métier et opérationnels que de la configuration technique.
La politique doit répondre à trois questions : quels types d’échec peuvent être résolus, pendant combien de temps l’événement reste utile et que faire lorsque ce délai expire. Se mettre d’accord sur ces réponses limite à la fois les abandons silencieux et les exécutions tardives qui déroutent les clients ou placent les systèmes dans des états incohérents.
Pourquoi un message réessayé trop longtemps peut devenir problématique
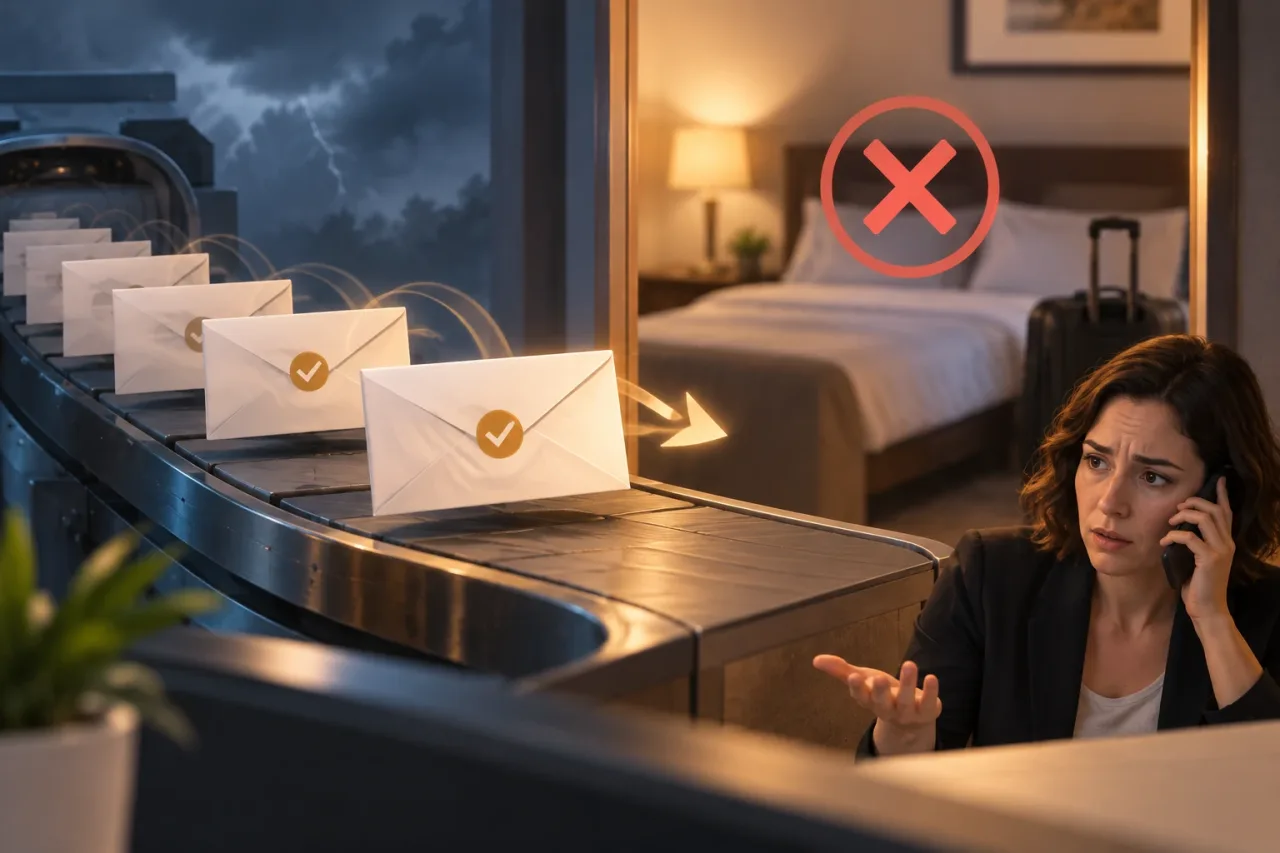
Une nouvelle tentative peut rétablir une opération après une brève interruption. Mais chaque tentative consomme aussi des ressources et peut avoir des effets indésirables si l’action intervient alors qu’elle n’est plus valable. Par exemple, envoyer une confirmation après l’annulation d’une réservation risque de susciter des questions et du travail pour l’assistance, même si le message a fini par être remis.
Le risque ne tient pas seulement au retard. Une file d’événements anciens peut compliquer le traitement des messages récents, tandis qu’une nouvelle tentative après une requête dont le résultat est incertain peut entraîner un doublon. La politique ne doit donc pas chercher à maximiser le nombre de tentatives : elle doit favoriser la réalisation des actions qui ont encore de la valeur, tout en limitant les conséquences de celles qui arrivent trop tard.
Il convient de distinguer la rétention technique — la durée pendant laquelle le système conserve l’événement — de la fenêtre de validité — la période pendant laquelle son exécution reste autorisée. Ces durées peuvent coïncider, mais ce n’est pas une obligation. Un événement peut être conservé après son expiration pour comprendre ce qui s’est passé, sans que cela autorise son retraitement automatique.
Classer les échecs avant de définir la fenêtre
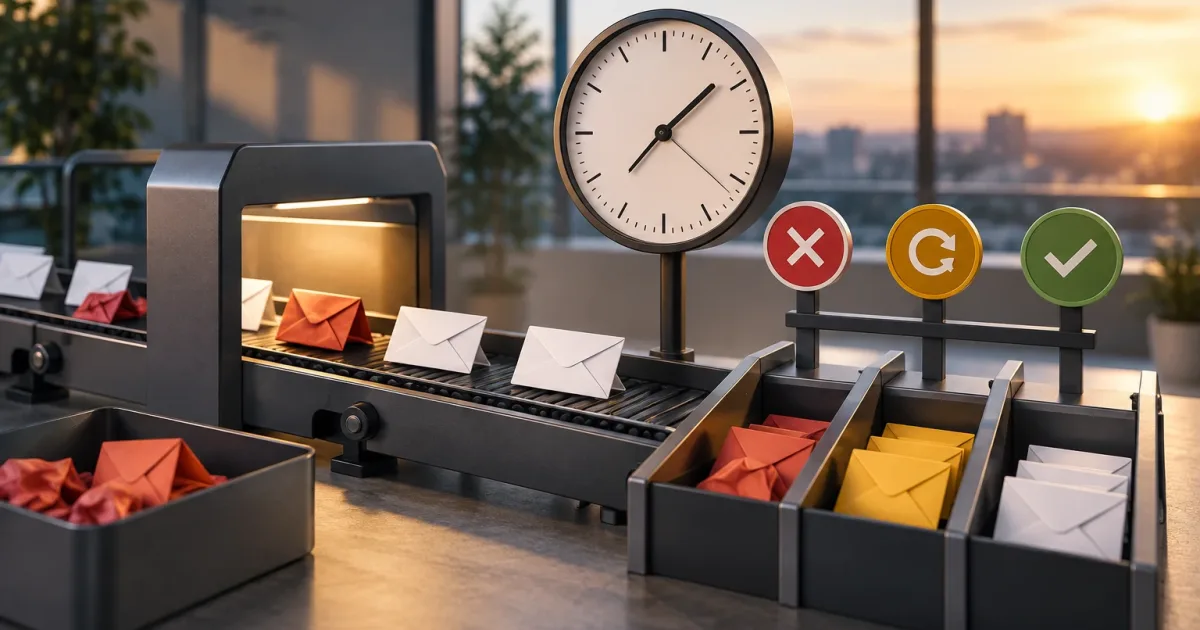
Le code d’erreur, la réponse de l’intégration et l’état du processus permettent de déterminer si un échec justifie une nouvelle tentative. À titre de cadre opérationnel, répartissez les cas en trois catégories et définissez l’action appropriée pour chacune :
- Temporaires : interruptions réseau, limites de service temporaires ou indisponibilité passagère. Elles peuvent justifier une nouvelle tentative, à condition que l’action soit toujours valable.
- Définitifs : données invalides, destinataire inexistant ou requête refusée pour une raison qui ne changera pas après quelques minutes. Réessayer sans corriger la cause aide rarement ; mieux vaut généralement s’arrêter et demander une correction ou une intervention.
- Ambigus : la connexion a été interrompue et le système ignore si le service destinataire a mené l’opération à bien. Avant de réessayer, vérifiez l’état lorsque c’est possible ou prévoyez des protections contre les effets en double.
Les réponses d’un service n’ont pas toutes une interprétation universelle. Une réponse temporaire peut correspondre à un incident qui dure, tandis qu’une erreur apparemment définitive peut disparaître après correction des données. Documentez la classification pour chaque intégration et examinez les cas récurrents. Si la cause ne peut pas être déterminée de façon fiable, ne considérez pas par défaut tous les échecs comme temporaires.
Fixer le délai selon l’urgence, la validité et les conséquences
La fenêtre de nouvelles tentatives commence au moment de l’échec et prend fin lorsque l’événement ne doit plus être exécuté automatiquement. Pour la définir, convenez avec les équipes métier et opérationnelles de trois critères :
- Urgence : quel retard le processus peut-il tolérer avant d’affecter une décision, un engagement ou la prise en charge d’un client ?
- Validité : jusqu’à quel moment le contenu ou l’action reste-t-il exact ? Tenez compte des changements d’état ultérieurs, comme une annulation, un paiement déjà réglé ou un rendez-vous passé.
- Conséquences d’une exécution tardive : quel serait le coût d’une exécution après ce moment ? Il peut s’agir d’un message déroutant, d’une mise à jour incorrecte ou d’une intervention manuelle ; il peut aussi être acceptable de terminer une tâche interne sans effet visible.
Comparez la fenêtre au cycle de vie réel du processus. Une alerte liée à une date proche peut vite perdre son utilité, tandis qu’une synchronisation de catalogue peut tolérer un délai plus long. N’adoptez pas une durée unique pour tous les événements sous prétexte que la configuration s’en trouve simplifiée. Regroupez-les par niveau de service lorsque leurs conséquences sont similaires et ne prévoyez des exceptions que pour une raison précise.
Si la validité dépend d’un état susceptible d’évoluer, il ne suffit pas de compter les heures depuis le premier échec. Avant toute exécution tardive, vérifiez que l’action est toujours autorisée. Si cette vérification est impossible, raccourcissez la fenêtre ou transmettez le cas pour examen au lieu de supposer que l’événement reste valable.
Choisir les intervalles et les limites sans provoquer de surcharge
Un intervalle fixe et court peut entraîner de nouvelles tentatives simultanées pour de nombreux événements pendant une interruption. Envisagez plutôt d’espacer progressivement les tentatives et de fixer une limite totale de durée ou de nombre d’essais. Cet espacement réduit la pression sur le service concerné et lui laisse le temps de récupérer. Ajouter une part d’aléatoire aux intervalles peut éviter que des groupes de processus synchronisés ne le sollicitent tous au même moment.
Les paramètres doivent refléter les comportements observés, et non un chiffre arbitraire. Examinez la durée des interruptions habituelles, la fréquence de récupération des tentatives et le temps nécessaire pour qu’un événement perde son utilité. Fixez des limites pour empêcher les tentatives infinies, tout en laissant à un échec de courte durée une possibilité raisonnable de se résorber. Si le service indique qu’il ne faut pas réessayer tout de suite, respectez cette consigne lorsque l’intégration le permet.
Il est également utile de distinguer la limite des tentatives du niveau de concurrence. Lors d’un incident étendu, augmenter sans discernement le nombre de tentatives peut aggraver la situation. Si l’ancienneté des événements en attente augmente en même temps que le volume d’erreurs, c’est un signal d’alerte : vérifiez l’état du service et réduisez la pression plutôt que d’accélérer les tentatives.
Que faire à l’expiration de la fenêtre
L’expiration doit entraîner une issue explicite. Cesser les tentatives sans consigner le résultat revient à perdre toute visibilité. Définissez, pour chaque type d’événement, laquelle des options suivantes s’applique :
- Abandonner : pour les événements expirés à faible impact, dont l’exécution ne serait plus valable. Conservez suffisamment d’informations pour expliquer l’abandon et repérer les tendances.
- Transmettre à une vérification manuelle : pour les cas à fort impact, dont la cause n’est pas résolue ou dont le résultat reste ambigu. La vérification nécessite un responsable, du contexte et une action possible : corriger, réessayer de manière contrôlée ou clôturer.
- Déclencher une compensation : lorsque le processus doit corriger un effet partiel ou rétablir un état convenu. La compensation doit elle aussi avoir des conditions, un responsable et une trace ; ce n’est pas simplement une nouvelle tentative.
Ne laissez pas la vérification manuelle devenir une file sans responsable. Déterminez qui la traite, comment les cas sont priorisés selon leur ancienneté et leur impact, et ce qui se passe en l’absence d’intervention dans le délai convenu. Si les opérateurs ne peuvent pas distinguer les événements récupérables des événements obsolètes à partir des informations disponibles, le problème vient de la conception du processus de vérification, et non de la rapidité de l’équipe.
Consigner les informations utiles au diagnostic et à l’action
Pour chaque événement, conservez un identifiant permettant de le suivre, son type, son état, son ancienneté, le nombre et l’heure des tentatives, la cause enregistrée, la prochaine action et la décision prise à l’expiration. Indiquez le système destinataire lorsque plusieurs intégrations sont utilisées. Évitez de stocker des données personnelles ou des secrets qui ne sont pas nécessaires au diagnostic ; appliquez les règles pertinentes en matière d’accès et de conservation.
Ces indicateurs permettent de distinguer une fenêtre trop courte d’un incident externe : proportion de messages récupérés, délai de récupération, volume d’événements arrivés à expiration, causes les plus fréquentes, ainsi que taille et ancienneté de la file en attente de vérification. Analysez ces mesures par type d’événement. Un taux élevé de nouvelles tentatives réussies ne justifie pas d’allonger la fenêtre si les événements récupérés ont perdu leur valeur au moment de leur exécution.
Liste de contrôle pour convenir de la politique
- Quel effet métier l’événement produit-il et à partir de quand n’est-il plus valable ?
- Quels échecs sont temporaires, définitifs ou ambigus pour chaque intégration ?
- Quelle est la fenêtre maximale et comment vérifier que l’événement reste valable ?
- Quels intervalles et quelles limites évitent une pression excessive et des tentatives sans fin ?
- À l’expiration, faut-il abandonner l’événement, le vérifier ou déclencher une compensation ? Qui en est responsable ?
- Quelles données et mesures permettent d’expliquer le résultat et d’améliorer la politique ?
En définitive, la durée pendant laquelle il faut réessayer les messages en échec dépend du temps nécessaire à la disparition de la cause et de la valeur que conserve l’action pendant cette période. Définissez les fenêtres en fonction de l’impact, limitez les tentatives, traitez différemment les erreurs définitives et convenez d’une issue opérationnelle. Examinez ensuite les événements qui expirent le plus souvent ou nécessitent le plus d’interventions : ils révèlent généralement les meilleures pistes pour revoir la classification, l’intégration ou le processus lui-même.