

Validar cada cambio con el mismo conjunto de pruebas puede ser ineficiente: algunas modificaciones apenas afectan una pantalla, mientras que otras alteran pagos, permisos, datos o tareas esenciales para la operación. La pregunta útil no es cuántas pruebas ejecutar, sino qué podría fallar, a quién afectaría y qué evidencia se necesita antes de publicar.
Una estrategia basada en riesgo permite ajustar la profundidad de validación al posible daño. No elimina los fallos ni sustituye el criterio profesional, pero ayuda a distribuir el tiempo disponible y a hacer explícitas las decisiones. El resultado debe ser un plan concreto: recorridos que se probarán, responsables, criterios de salida y respuesta ante problemas.
Por qué no todos los cambios requieren la misma cobertura
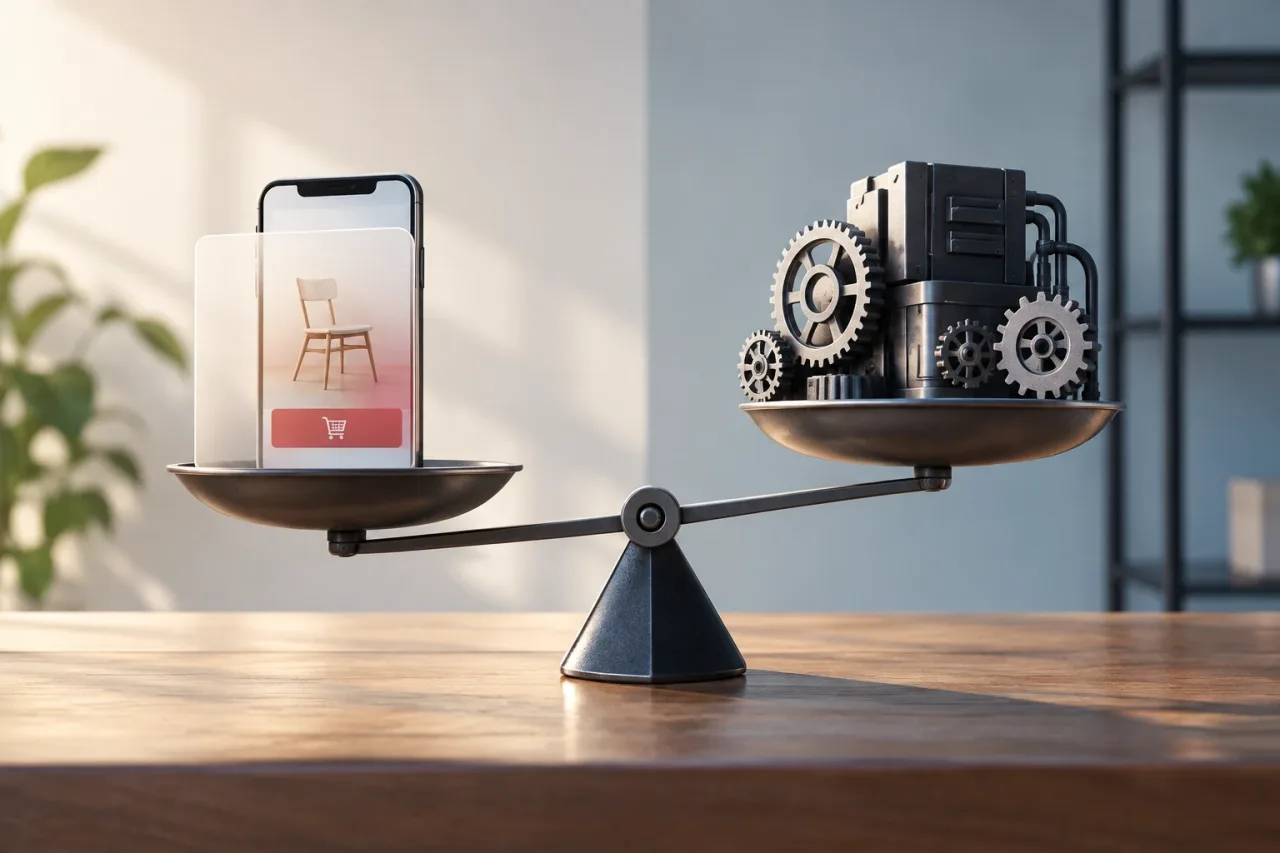
El tamaño técnico de un cambio no siempre refleja su riesgo. Una modificación visual pequeña puede ocultar un botón de compra en móvil; una actualización extensa de una función interna puede tener poco efecto si está aislada y cuenta con una ruta de reversión sencilla. Por eso, clasificar solo por número de archivos, horas de desarrollo o etiqueta de versión conduce a decisiones débiles.
Conviene evaluar el cambio desde el proceso que toca. ¿Afecta una actividad que clientes o empleados necesitan completar? ¿Puede modificar o exponer datos? ¿Depende de sistemas externos? ¿Existe una alternativa manual si deja de funcionar? Estas preguntas conectan el trabajo técnico con las consecuencias reales para negocio y operaciones.
La cobertura tampoco significa probar todo de manera exhaustiva. Implica dedicar más atención a las funciones cuya interrupción sería costosa o difícil de detectar, y mantener una validación proporcionada para cambios de menor impacto. Un plan genérico que repite las mismas comprobaciones puede consumir tiempo en zonas seguras y pasar por alto dependencias relevantes.
Evaluar impacto, probabilidad y detectabilidad
Para cada cambio, el equipo puede valorar tres dimensiones con categorías simples —baja, media o alta— y registrar el razonamiento. No hace falta presentar la puntuación como una medición científica; sirve para comparar decisiones y señalar desacuerdos antes de publicar.
- Impacto: consecuencias de un fallo para clientes, operación, ingresos, obligaciones de privacidad o integridad de datos. Considere también cuántas personas y procesos quedarían afectados.
- Probabilidad: posibilidad de que ocurra el fallo, atendiendo a la complejidad, la novedad del código, los cambios recientes en la zona y la cantidad de dependencias.
- Detectabilidad: facilidad para notar el problema antes de que escale. Una alerta clara o una comprobación inmediata reduce el tiempo de respuesta; un error silencioso en datos puede permanecer oculto.
Una combinación de impacto alto y detección difícil merece atención prioritaria, aunque el equipo considere poco probable el fallo. En cambio, un defecto visible, reversible y limitado a una función secundaria puede justificar controles más ligeros. Si se usa una matriz o una puntuación, debe ayudar a conversar, no reemplazar la explicación de los supuestos.
Como señal de diagnóstico, deténgase si no se puede explicar quién detectaría un fallo y cuánto tardaría. Esa incertidumbre indica que la estrategia puede necesitar observabilidad, una comprobación adicional o una publicación más gradual, además de pruebas funcionales.
Mapear recorridos críticos, dependencias y límites
Antes de elegir casos de prueba, describa el recorrido que el cambio modifica de principio a fin. Para una compra, por ejemplo, podría incluir selección, cálculo del total, pago, confirmación y actualización del pedido. No basta con verificar que cada pantalla carga: hay que comprobar que el proceso conserva su sentido y que los sistemas implicados reciben información coherente.
Identifique dependencias internas y externas, como una API, un proveedor de identidad, un servicio de pagos o una cola de procesamiento, solo cuando formen parte del cambio. Aclare qué ocurre si una dependencia responde tarde, devuelve un error o entrega datos inesperados. Los límites importan: valores vacíos, permisos insuficientes, solicitudes duplicadas, volúmenes inusuales y estados interrumpidos suelen revelar fallos que el recorrido ideal no muestra.
Una lista útil debe priorizar escenarios, no acumular casos sin orden:
- El recorrido principal que produce el resultado esperado para el usuario o la operación.
- Los errores con mayor impacto, como cobros incorrectos, pérdida de información o acceso no autorizado.
- Las variantes que pueden alterar el resultado: roles, dispositivos, estados previos y datos límite.
- Las dependencias que pueden fallar y las opciones de recuperación disponibles.
Asignar validaciones según el riesgo
Las pruebas automatizadas son adecuadas para reglas repetibles y verificaciones frecuentes: cálculos, permisos, transformaciones de datos o componentes con comportamiento definido. Ayudan a detectar regresiones con rapidez, pero solo cubren lo que se haya especificado. Un conjunto automatizado que pasa no demuestra por sí solo que el proceso completo sea comprensible o que una integración real funcione.
Las pruebas de integración comprueban la interacción entre componentes y servicios. Priorícelas cuando el cambio atraviese límites del sistema, transforme datos o dependa de contratos que pueden variar. Compruebe tanto respuestas correctas como errores y tiempos de espera relevantes. Si no es viable probar contra un servicio real, documente qué se simula y qué riesgo queda pendiente.
La aceptación valida que el cambio resuelve la necesidad del usuario o del área operativa. Involucre a personas que conozcan el proceso cuando haya decisiones de negocio, excepciones o tareas difíciles de representar en pruebas técnicas. La revisión manual también es útil para aspectos visuales, textos, accesibilidad y exploración de escenarios no previstos, pero conviene limitarla a preguntas explícitas en vez de pedir una revisión genérica.
En cambios de bajo impacto puede bastar una comprobación focalizada y las pruebas automatizadas habituales. En riesgo medio, agregue escenarios de integración y aceptación del recorrido afectado. En riesgo alto, combine las capas pertinentes, revisión de datos y permisos, observabilidad reforzada y un plan de despliegue o reversión. La selección depende del sistema: no todas las capas aportan valor a todos los cambios.
Definir criterios de salida y evidencias
Antes de iniciar la validación, acuerde qué significa estar listo. Un criterio útil describe el resultado y no solo la actividad: por ejemplo, que el recorrido crítico complete sin errores, que los permisos se comporten como se espera y que no existan defectos abiertos de impacto inaceptable. Indique quién acepta el riesgo residual y quién puede detener la publicación.
Registre el alcance probado, los resultados, los defectos pendientes, las limitaciones del entorno y la decisión final. Esta evidencia no necesita ser burocrática: puede vivir en el sistema de trabajo del equipo. Debe permitir que otra persona entienda qué se comprobó y qué no. Si una prueba crítica no pudo ejecutarse, trátelo como riesgo explícito, no como resultado satisfactorio.
Establezca también condiciones para ampliar, pausar o cancelar el despliegue. Un error en una función secundaria quizá permita continuar con vigilancia; señales de corrupción de datos o fallos repetidos en una operación esencial deberían activar una pausa. Los umbrales concretos deben ajustarse al servicio y a la capacidad de respuesta del equipo, no copiarse de otro contexto.
Preparar recuperación y aprender tras publicar
En cambios de alto impacto, la validación incluye comprobar cómo limitar el daño si algo falla. Determine si es posible desactivar la función, volver a una versión anterior, restaurar datos o ejecutar una alternativa manual. Una reversión no siempre es simple: cambios de esquema o escrituras incompatibles pueden impedirla. En esos casos, planifique una migración segura y pruebe el procedimiento pertinente antes del lanzamiento.
Defina quién observa el despliegue, qué señales revisa y a quién comunica una incidencia. Supervise indicadores ligados al proceso —errores, tareas completadas, tiempos o discrepancias de datos— en lugar de confiar únicamente en que la aplicación esté disponible. Si el cambio afecta a clientes o equipos internos, prepare mensajes claros y canales para recibir reportes.
Después de publicar, compare lo ocurrido con los supuestos de riesgo. ¿Aparecieron fallos que las pruebas no cubrieron? ¿Las alertas permitieron detectarlos a tiempo? ¿La reversión fue viable? Use las respuestas para actualizar recorridos críticos, automatización y criterios de salida. Así, la estrategia mejora con evidencia y evita tanto la sobrecarga de pruebas indiscriminada como la confianza basada únicamente en que el cambio parece pequeño.