

Una prueba puede mostrar más conversiones y, al mismo tiempo, aumentar los errores, las consultas de soporte o el tiempo que una tarea tarda en completarse. La cifra principal parece favorable, pero el coste para usuarios u operación plantea una duda legítima: ¿se lanza, se modifica o se detiene?
La decisión no consiste en elegir la métrica que mejor respalda una preferencia previa. Consiste en contrastar el resultado con una hipótesis, considerar la calidad de la evidencia y determinar qué riesgos son aceptables. Este marco ayuda a decidir cómo decidir el resultado de un experimento de producto sin reducirlo a una sola cifra ni convertir cada discrepancia en motivo para prolongar indefinidamente una prueba.
Por qué una métrica principal favorable no basta
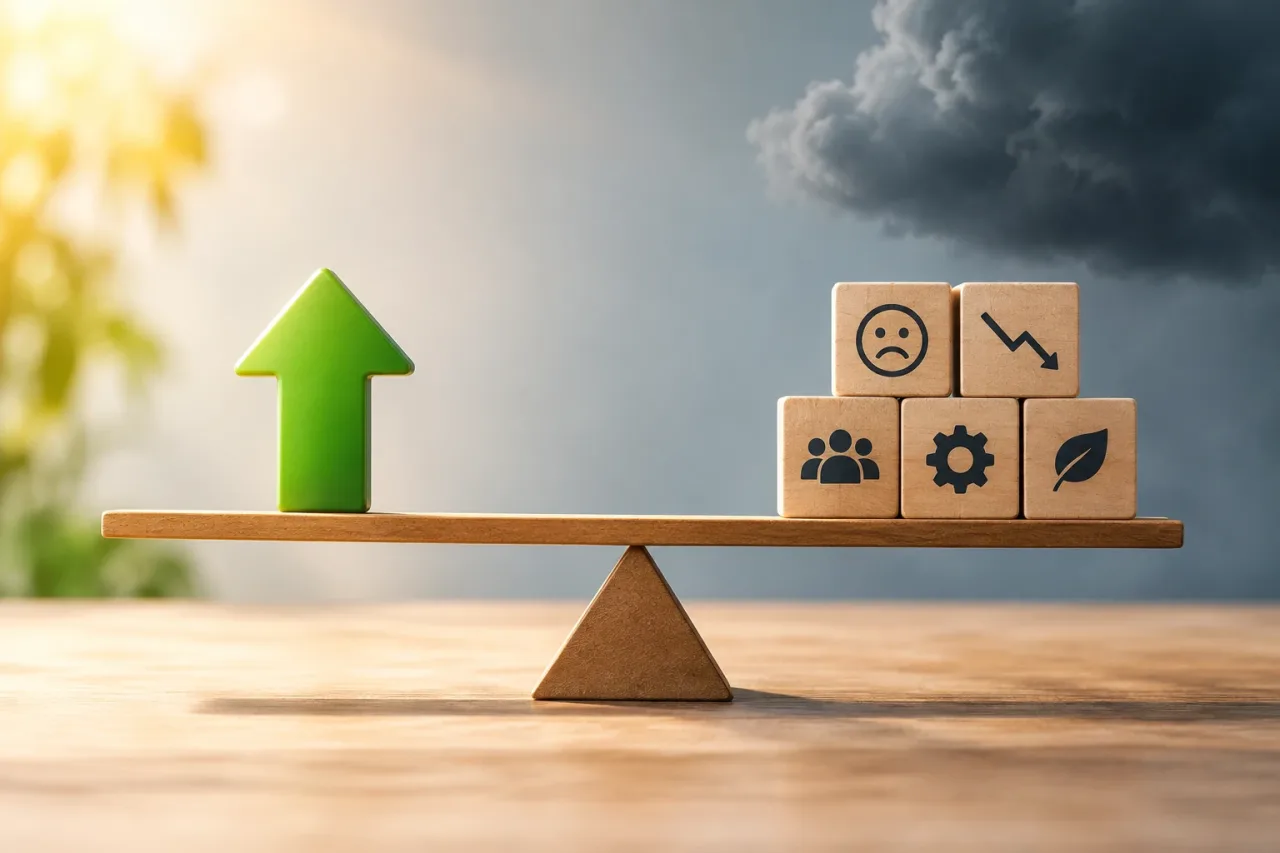
La métrica principal representa el resultado que la intervención busca cambiar: por ejemplo, completar una compra, activar una cuenta o reservar una cita. Es importante porque hace explícito el objetivo. Pero un aumento en ese resultado no demuestra por sí solo que el cambio sea conveniente en conjunto.
Una mejora aparente podría venir acompañada de más cancelaciones, errores de pago, contactos con atención al cliente o abandono de una tarea posterior. También puede desplazar actividad entre pasos sin mejorar el resultado final. Una nueva pantalla, por ejemplo, podría elevar los clics en “continuar”, pero no necesariamente las compras completadas.
Por eso conviene separar tres preguntas:
- ¿Se movió el resultado buscado? La métrica principal responde a la hipótesis inmediata.
- ¿El cambio produjo daños relevantes? Las métricas de protección revelan costes o deterioros importantes.
- ¿La evidencia permite atribuir el movimiento al cambio? La calidad de instrumentación, la asignación y el periodo observado condicionan la interpretación.
Un resultado favorable en la primera pregunta no resuelve automáticamente las otras dos. Un cambio solo merece avanzar si su beneficio es suficientemente creíble y sus costes se mantienen dentro de límites aceptables.
Antes de probar: definir hipótesis y criterios de decisión
Antes de iniciar la prueba, escribe qué se cambia, para quién y por qué se espera que produzca un resultado. La hipótesis debe describir una relación comprobable, no una solución que ya se da por correcta. Por ejemplo: “Simplificar este paso reducirá el abandono de usuarios nuevos porque elimina una solicitud de información que no necesitan en ese momento”.
Define también la población elegible, el resultado principal y el periodo o volumen necesario para evaluar la prueba. La duración no debe elegirse únicamente porque aparecieron cifras llamativas en los primeros días. Considera ciclos de uso relevantes, estacionalidad conocida y el tiempo necesario para que se materialicen efectos posteriores, como devoluciones o solicitudes de soporte.
Antes de observar los resultados, acuerda qué decisiones son posibles y qué señales las activarían. No hace falta fingir que todo se puede resumir en un umbral estadístico único. Sí hace falta distinguir entre:
- Condiciones para avanzar: beneficio suficientemente convincente, sin deterioro inaceptable en métricas de protección.
- Condiciones para detener: daño claro, incumplimiento operativo o riesgo que no se justifica por la mejora.
- Condiciones para investigar o iterar: resultado incierto, problema corregible o dato que no permite una conclusión fiable.
Establece los límites según el contexto. Una caída pequeña en una métrica secundaria puede ser tolerable si el impacto es reversible y el beneficio relevante; un aumento de errores que impida completar una tarea crítica puede exigir parar, aunque la conversión suba. Los límites deben reflejar consecuencias para usuarios y negocio, no solo conveniencia estadística.
Qué métricas de protección observar y cómo fijar alertas
Las métricas de protección, también llamadas métricas de guardia, vigilan efectos que la intervención no debe empeorar de forma material. Su selección depende del cambio. Un ajuste en el registro puede requerir observar errores, activación posterior y contactos de soporte. Un cambio en el proceso de compra puede requerir revisar pagos fallidos, cancelaciones, devoluciones y tiempos de atención.
Elige pocas métricas que representen riesgos concretos y que puedan medirse con fiabilidad. Añadir decenas de indicadores vuelve más difícil distinguir una señal importante de una fluctuación casual. Para cada una, documenta:
- qué daño o coste intenta detectar y a qué población se aplica;
- su nivel habitual y cómo se calcula, incluidos denominador y ventana temporal;
- qué deterioro sería preocupante y qué acción desencadenaría;
- si el dato llega con retraso o puede verse afectado por fallos de instrumentación.
Un umbral de alerta no es necesariamente una prueba estadística definitiva. Puede ser una regla operativa para pausar y revisar, especialmente cuando el posible daño es grave. Si una alerta se activa, comprueba primero que la medición funciona y que la comparación es válida; no ignores el riesgo mientras esperas una conclusión perfecta.
Interpretar señales contradictorias sin escoger la cifra conveniente
Cuando las métricas discrepan, no las promedies ni elijas a posteriori la que favorece tu opción preferida. Examina la cadena causal esperada: ¿el cambio movió el paso previsto? ¿El efecto se mantiene en el resultado posterior? ¿La métrica secundaria es un coste directo, una consecuencia pasajera o un indicador que no refleja daño real?
Revisa también la calidad del dato. Verifica que la asignación a cada variante funcionó, que los eventos se registraron de forma consistente y que ambas poblaciones son comparables. Comprueba si hubo cambios simultáneos, interrupciones o campañas que alterasen el comportamiento. Si la medición está rota, el resultado no es “positivo” ni “negativo”: es inconcluso hasta resolver la limitación.
Distingue magnitud de certeza. Un cambio pequeño pero consistente puede tener valor si afecta a muchas interacciones; un cambio grande con pocos datos puede ser frágil. No confundas ausencia de evidencia de daño con evidencia de que no existe daño, sobre todo para consecuencias tardías o poco frecuentes.
Cuando el efecto principal mejora y una métrica de protección empeora, pregunta si el deterioro supera el límite definido, si es material para las personas afectadas y si existe una explicación comprobable. Si el coste es aceptable y está dentro del límite, puede tener sentido avanzar con seguimiento. Si rebasa un límite importante, la mejora principal no lo compensa automáticamente.
Lanzar, iterar, prolongar o detener
Lanzar es razonable cuando la evidencia respalda el objetivo, no hay señales de daño fuera de los límites acordados y la operación puede sostener el cambio. El lanzamiento puede ser gradual, con observación y capacidad para revertirlo; no tiene por qué ser una expansión instantánea a toda la población.
Iterar cuando la hipótesis sigue siendo plausible, pero los resultados apuntan a un problema concreto que se puede corregir. Por ejemplo, el flujo simplificado puede funcionar, mientras que una instrucción ambigua genera consultas. Formula una hipótesis revisada y prueba el nuevo cambio por separado siempre que sea posible, para saber qué produjo el resultado.
Prolongar solo si falta información relevante y puede obtenerse con una prueba válida. Antes, especifica qué incertidumbre se resolverá, qué dato adicional cambiaría la decisión y cuándo se volverá a evaluar. Si nada de lo que se observe alteraría la elección, prolongar solo añade coste y oportunidades de selección sesgada.
Detener si aparece daño que supera el límite, si el cambio falla en una tarea esencial o si la hipótesis queda debilitada y no hay una vía razonable de corrección. Detener una variante no invalida el aprendizaje: puede identificar una restricción de diseño o una necesidad operativa que conviene abordar de otra manera.
Segmentos distintos y decisiones reversibles
Un resultado promedio puede ocultar diferencias entre grupos. Sin embargo, no conviertas cualquier diferencia observada en una política segmentada: al revisar muchos grupos, es más probable encontrar variaciones casuales. Da más peso a segmentos definidos antes de la prueba, con una razón clara y suficiente información para interpretarlos.
Comprueba si la diferencia es consistente, relevante y explicable antes de actuar. Si usuarios nuevos parecen beneficiarse y usuarios recurrentes empeoran, una opción puede ser diseñar una experiencia distinta por contexto, pero solo si se puede implementar, medir y mantener sin crear confusión o costes desproporcionados. Cuando la evidencia es débil, registra la señal como hipótesis para una prueba posterior, no como conclusión.
Por último, deja constancia de la decisión: hipótesis, población, periodo, métricas, alertas, resultado, incertidumbres y responsable de seguimiento. Especifica qué nueva señal justificaría revisarla y cómo se revertiría el cambio. Una decisión reversible y documentada no elimina el riesgo, pero permite actuar con criterio, aprender de los efectos reales y corregir el rumbo sin confundir una métrica favorable con una aprobación automática.