

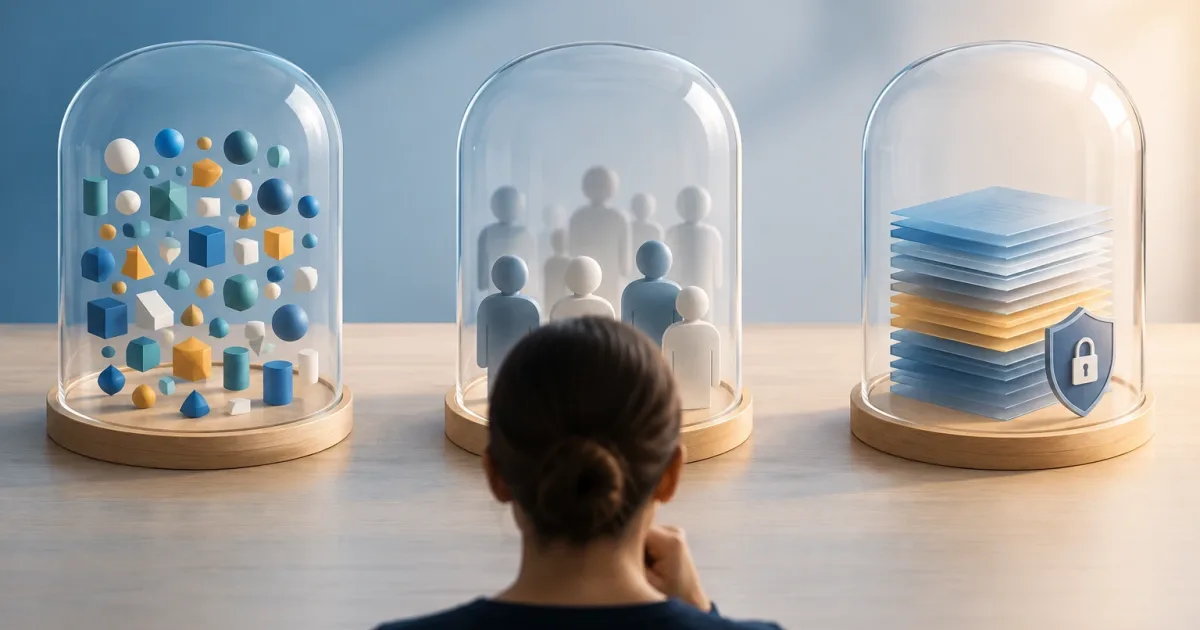
Los datos de prueba influyen tanto en la calidad del software como en la exposición de información sensible. Un conjunto demasiado simple puede ocultar errores; una copia de producción sin controles puede divulgar datos personales o comerciales. La decisión no consiste únicamente en elegir entre datos reales o ficticios: hay que equilibrar realismo, sensibilidad, esfuerzo de mantenimiento y propósito de cada entorno.
Esta guía permite comparar tres enfoques —datos sintéticos, datos anonimizados y copias controladas— y establecer criterios prácticos para desarrollo, pruebas y demostraciones. La opción adecuada puede variar entre equipos e incluso entre pruebas dentro del mismo producto.
Por qué los datos condicionan la calidad y el riesgo
Una aplicación se comporta según los datos que procesa. Volúmenes, combinaciones, valores ausentes, duplicados y relaciones entre registros pueden activar rutas que los ejemplos mínimos no alcanzan. Si las pruebas solo cubren el caso ideal, pueden pasar por alto fallos en validaciones, cálculos, permisos, integraciones o migraciones.
Al mismo tiempo, los entornos no productivos suelen tener más usuarios con acceso, herramientas de depuración y ciclos de vida menos estrictos que producción. Incluir información identificable por comodidad amplía las consecuencias de una cuenta expuesta, una exportación accidental o un entorno que queda olvidado. El objetivo es conservar las características necesarias para probar, no copiar más información de la necesaria.
Antes de seleccionar un método, concreta qué se quiere validar: una regla de negocio, una migración, el rendimiento, una experiencia de usuario o una demostración. Sin ese propósito, “datos realistas” es un requisito impreciso y puede conducir a recopilar detalles que no aportan valor.
Tres enfoques, con distintos niveles de fidelidad
Datos sintéticos
Se generan desde cero mediante reglas, plantillas o herramientas internas. Pueden incluir nombres ficticios, fechas, estados y relaciones coherentes, así como casos límite diseñados deliberadamente. Al no partir de registros reales, evitan trasladar directamente datos de producción. Sin embargo, no son automáticamente seguros si incorporan valores reales, secretos o ejemplos copiados.
Son apropiados para desarrollo, pruebas automatizadas, formación y demostraciones cuando se puede describir la estructura y el comportamiento esperado. Su principal coste es construir y mantener generadores que representen reglas de negocio, distribuciones y combinaciones relevantes. Un conjunto sintético demasiado regular no descubrirá problemas causados por datos históricos irregulares.
Datos anonimizados
Se obtienen transformando datos de origen para que las personas no puedan identificarse. El resultado puede conservar patrones útiles para determinadas pruebas, pero el riesgo depende del contexto, de los campos conservados y de la posibilidad de combinar información con otras fuentes. Sustituir nombres o correos no basta necesariamente: fechas, ubicaciones, identificadores indirectos y relaciones poco frecuentes también pueden revelar identidades.
Este enfoque requiere revisar el resultado, no limitarse a ejecutar una transformación. Si la prueba necesita solo tendencias agregadas, quizá convenga reducir el detalle. Si necesita relaciones entre registros, la transformación debe preservar esa coherencia sin mantener identificadores innecesarios. La anonimización no debe tratarse como garantía automática de que cualquier uso posterior es inocuo.
Copias controladas de producción
Una copia controlada conserva una parte seleccionada de los datos reales o una versión transformada y restringida. Puede resultar útil para investigar incidencias difíciles de reproducir, validar migraciones complejas o evaluar comportamiento con distribuciones auténticas. También concentra riesgos: puede transportar información sensible, incluir secretos operativos y quedar obsoleta con rapidez.
Resérvala para casos en los que las alternativas no alcanzan el realismo necesario. Define qué campos se extraen, quién autoriza la preparación, dónde se almacena, quién accede y cuándo se elimina. Una copia no debería convertirse en la opción predeterminada por ser la más cómoda.
Cómo elegir según la prueba y el riesgo
Usa estos criterios para tomar una decisión explícita:
- Desarrollo y pruebas unitarias: prioriza datos sintéticos pequeños, previsibles y fáciles de restablecer. Deben cubrir valores válidos, inválidos y límites de las reglas.
- Pruebas de integración: combina datos sintéticos coherentes con los contratos de los sistemas conectados. Si una dependencia exige realismo histórico, evalúa un extracto transformado y limitado.
- Pruebas de carga o rendimiento: reproduce volumen, distribución y relaciones necesarias. No presupongas que hacen falta identidades reales; verifica si una generación sintética puede conseguir el mismo perfil operativo.
- Investigación de incidencias: empieza por reproducir el fallo con datos sintéticos. Si no basta, utiliza una copia controlada con alcance, acceso y caducidad definidos.
- Demostraciones: normalmente convienen datos sintéticos curados. Evita que una demo pública o compartida herede registros, comentarios o adjuntos reales.
La sensibilidad también importa. Cuanto más delicada sea la información y más amplio el acceso, mayor debe ser la preferencia por datos sintéticos o por una transformación que elimine detalle no necesario. La decisión debería registrar el motivo por el que el realismo adicional compensa el esfuerzo y el riesgo.
Representatividad, casos límite y reidentificación
Representatividad no significa reproducir cada registro. Significa conservar las propiedades que afectan a la prueba. Identifica dimensiones como frecuencia de estados, distribución de tamaños, relaciones entre entidades, antigüedad y valores ausentes. Después, compara el conjunto de prueba con esas dimensiones sin incluir campos que no se utilicen.
Incluye casos poco frecuentes que puedan romper supuestos: registros duplicados, secuencias incompletas, formatos inesperados, zonas horarias o transiciones de estado inusuales. Los datos sintéticos permiten crear estos casos de manera intencional, mientras que una muestra de producción puede no contenerlos.
Para evaluar el riesgo de reidentificación, pregunta qué puede inferirse al combinar los campos conservados con información disponible en otros lugares. Revisa identificadores directos e indirectos, valores raros y vínculos entre tablas. Si no puedes justificar que un atributo sea necesario, elimínalo o generalízalo y vuelve a comprobar que el caso de prueba sigue siendo útil.
Controles para el ciclo de vida del conjunto
La protección no termina cuando se genera el conjunto. Define controles sencillos y verificables para su preparación y uso:
- Inventariar: identifica conjuntos, propósito, origen, campos y entorno en el que se usarán.
- Limitar: extrae solo los registros y atributos requeridos; separa los datos de prueba de credenciales, tokens y secretos operativos.
- Restringir el acceso: asigna permisos según la necesidad de trabajo y revisa quién puede descargar, copiar o exportar los datos.
- Controlar las actualizaciones: documenta cómo se genera cada versión, quién la mantiene y qué cambios de esquema o reglas requieren regenerarla.
- Fijar una caducidad: define cuándo se elimina el conjunto y sus copias de trabajo, incluidas exportaciones conocidas.
- Comprobar el resultado: verifica que no haya datos reales o campos sensibles inesperados y que las pruebas sigan cubriendo los escenarios previstos.
Un conjunto de prueba reutilizable debería tener propietario y propósito, igual que cualquier otro activo del equipo. Si nadie sabe de dónde salió o cuándo debe retirarse, conviene tratarlo como una deuda operativa y resolver su destino antes de seguir propagándolo.
Errores frecuentes y lista de comprobación
Dos extremos suelen fallar. El primero es usar datos reales por comodidad: ahorra preparación inicial, pero multiplica las copias y dificulta controlar acceso y eliminación. El segundo es usar datos artificiales demasiado limpios: reduce exposición, pero genera una falsa confianza si no refleja formatos, relaciones y casos límite relevantes. La solución no es elegir fidelidad o seguridad de forma absoluta, sino ajustar el conjunto a la pregunta que se intenta responder.
Antes de aprobar datos para un entorno no productivo, comprueba:
- ¿Está definido el objetivo de la prueba y qué características de los datos necesita?
- ¿Puede lograrse con datos sintéticos? Si no, ¿qué atributo de realismo falta?
- ¿Se han reducido los campos, registros y relaciones a lo estrictamente necesario?
- ¿Se han revisado valores raros y combinaciones que podrían facilitar una reidentificación?
- ¿Están definidos acceso, ubicación, actualización, responsable y fecha de eliminación?
- ¿El conjunto cubre casos límite y se puede regenerar cuando cambian el producto o el esquema?
La decisión más sólida es la que conecta cada tipo de dato con una necesidad de prueba y un control concreto. Empieza con datos sintéticos, escala a una transformación o copia controlada solo cuando exista una brecha demostrable de fidelidad, y vuelve a revisar la elección cuando cambien el propósito, los datos o los accesos.