Un mensaje que falla no siempre debe reintentarse de inmediato, ni conservarse indefinidamente. Una notificación de pago pendiente, una actualización de inventario y un recordatorio de una cita tienen distinta urgencia y distinto valor una vez que llegan tarde. Por eso, decidir cuánto tiempo reintentar mensajes fallidos es una decisión de negocio y operación, además de una configuración técnica.
La política debe responder tres preguntas: qué tipos de fallo se pueden recuperar, durante cuánto tiempo sigue siendo útil ejecutar el evento y qué ocurre cuando vence ese plazo. Acordar esas respuestas reduce tanto los abandonos silenciosos como las ejecuciones tardías que confunden a clientes o dejan los sistemas en estados incoherentes.
Por qué un mensaje que sigue reintentándose puede convertirse en un problema
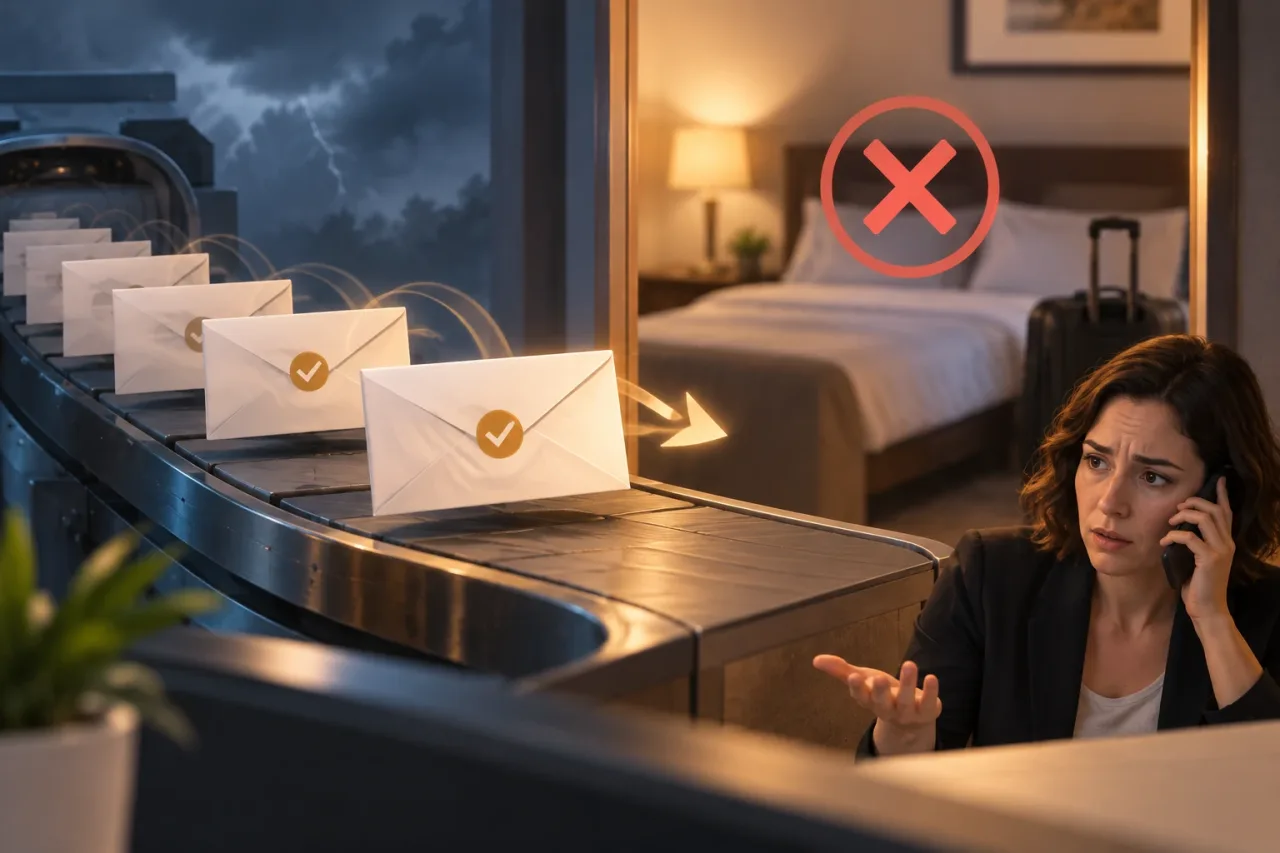
Reintentar puede recuperar una operación después de una interrupción breve. Pero cada nuevo intento también consume recursos y puede producir efectos no deseados si la acción se ejecuta cuando ya perdió vigencia. Por ejemplo, enviar una confirmación después de que una reserva se haya cancelado puede generar consultas y trabajo de soporte, aunque el mensaje finalmente se haya entregado.
El riesgo no es solo el retraso. Una cola de eventos antiguos puede dificultar la atención de mensajes recientes, y un reintento de una solicitud cuyo resultado es incierto puede duplicar una operación. La política, por tanto, no debería maximizar el número de intentos: debería maximizar la posibilidad de completar acciones que todavía aportan valor, limitando el daño de las que llegan tarde.
Conviene distinguir la retención técnica —cuánto tiempo conserva el sistema el evento— de la ventana de validez —hasta cuándo está permitido ejecutarlo—. Pueden coincidir, pero no tienen por qué hacerlo. Un evento podría conservarse después de caducar para investigar qué ocurrió, sin que eso autorice a volver a procesarlo automáticamente.
Clasificar los fallos antes de definir la ventana
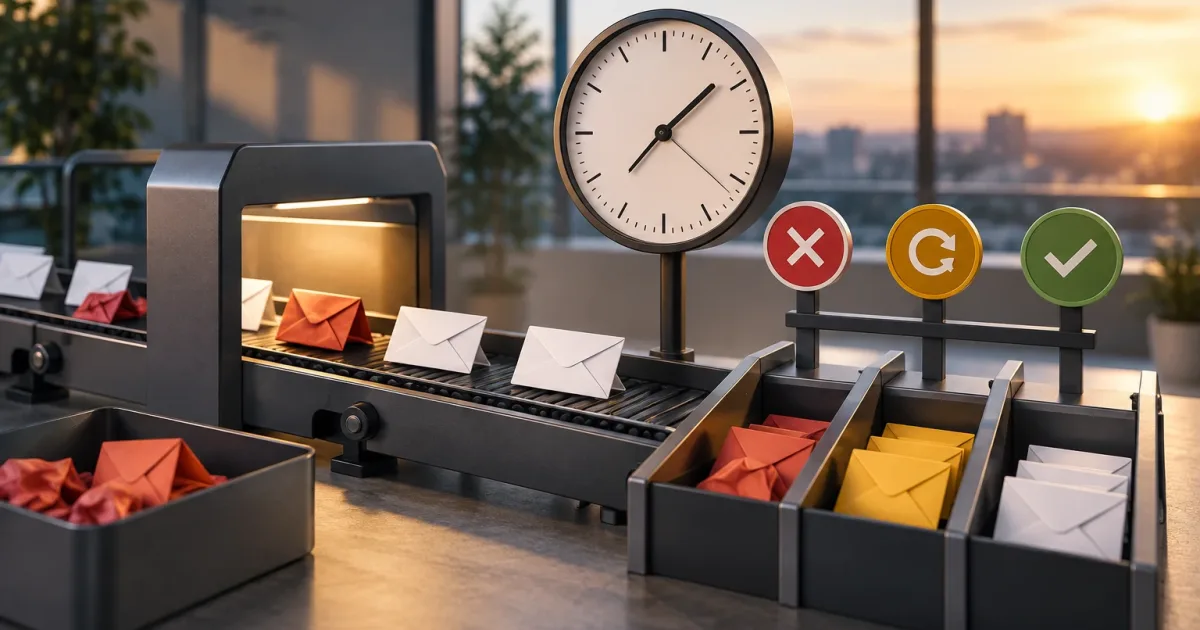
El código de error, la respuesta de la integración y el estado del proceso ayudan a decidir si un fallo merece otro intento. Como marco operativo, separa los casos en tres grupos y establece qué acción corresponde a cada uno:
- Transitorios: interrupciones de red, límites temporales de servicio o indisponibilidad momentánea. Pueden justificar un nuevo intento, siempre que la acción siga vigente.
- Permanentes: datos inválidos, destinatario inexistente o una solicitud rechazada por una condición que no cambiará con el paso de unos minutos. Repetir sin corregir la causa rara vez ayuda; suele convenir detenerse y pedir corrección o intervención.
- Ambiguos: la conexión se interrumpió y el sistema no sabe si el servicio receptor llegó a completar la operación. Antes de repetir, hay que comprobar el estado cuando sea posible o aplicar controles contra efectos duplicados.
No todas las respuestas de un servicio tienen una interpretación universal. Una respuesta temporal puede deberse a una incidencia persistente, mientras que un error aparentemente definitivo puede resolverse al corregir datos. Documenta la clasificación por integración y revisa los casos que se repiten. Si no puedes determinar la causa con fiabilidad, evita tratar todos los fallos como transitorios por defecto.
Definir el plazo según urgencia, vigencia y consecuencias
La ventana de reintentos empieza cuando se produce el fallo y termina cuando el evento ya no debe ejecutarse automáticamente. Para fijarla, acuerda con negocio y operaciones tres criterios:
- Urgencia: ¿cuánto retraso tolera el proceso antes de afectar una decisión, una promesa o una atención al cliente?
- Vigencia: ¿hasta qué momento el contenido o la acción siguen siendo correctos? Considera cambios de estado posteriores, como una cancelación, un pago ya resuelto o una cita pasada.
- Consecuencia tardía: ¿qué coste tiene ejecutar después de ese momento? Puede ser un mensaje confuso, una actualización incorrecta o una intervención manual; también puede ser aceptable completar una tarea interna sin impacto visible.
Compara la ventana con el ciclo de vida real del proceso. Un aviso ligado a una fecha próxima quizá pierda utilidad rápidamente; una sincronización de catálogo puede tolerar una demora mayor. No adoptes un plazo único para todos los eventos solo porque simplifica la configuración. Agrupa por clases de servicio cuando las consecuencias sean parecidas y define excepciones solo cuando haya una razón clara.
Si la validez depende de un estado cambiante, no basta con contar horas desde el primer fallo. Antes de una ejecución tardía, comprueba si la acción sigue permitida. Cuando esa comprobación no está disponible, reduce la ventana o deriva el caso a revisión en lugar de asumir que el evento continúa siendo válido.
Elegir intervalos y límites sin generar tormentas
Un intervalo constante y corto puede hacer que muchos eventos vuelvan a intentarse a la vez durante una interrupción. En su lugar, considera intervalos crecientes entre intentos y un límite total de duración o de intentos. La separación progresiva reduce la presión sobre el servicio afectado y deja margen para que se recupere. Añadir variación aleatoria a los intervalos puede evitar que grupos de procesos sincronizados vuelvan a llamar al mismo tiempo.
Los parámetros deben responder al comportamiento observado, no a una cifra arbitraria. Revisa cuánto duran las interrupciones habituales, con qué frecuencia se recuperan los intentos y cuánto tiempo tarda un evento en perder utilidad. Pon límites que impidan reintentos sin fin, pero comprueba que un fallo breve tenga oportunidad razonable de recuperarse. Si el servicio indica que no se debe reintentar todavía, respeta esa señal cuando la integración lo permita.
También conviene separar el límite de reintentos de la concurrencia. Ante un fallo amplio, aumentar indiscriminadamente los intentos puede agravar la incidencia. Una señal de alarma es que crezca la antigüedad de los eventos pendientes mientras aumenta el volumen de errores: en ese escenario, revisa la salud del servicio y limita la presión, en vez de acelerar los reintentos.
Qué hacer al vencer la ventana
La expiración debe producir una salida explícita. Dejar de reintentar sin registrar el resultado equivale a perder visibilidad. Define por tipo de evento cuál de estas opciones aplica:
- Descartar: para eventos caducados y de bajo impacto, cuando ejecutarlos ya no sea válido. Conserva información suficiente para explicar el descarte y detectar patrones.
- Enviar a revisión manual: para casos con impacto relevante, causa no resuelta o resultado ambiguo. La revisión necesita responsable, contexto y una acción disponible: corregir, reintentar de forma controlada o cerrar.
- Iniciar una compensación: cuando el proceso requiera corregir un efecto parcial o restaurar un estado acordado. La compensación también debe tener condiciones, responsable y registro; no es simplemente otro reintento.
No conviertas la revisión manual en una cola sin dueño. Establece quién la atiende, cómo prioriza por antigüedad e impacto y qué ocurre si no actúa dentro del plazo acordado. Si los operadores no pueden distinguir un evento recuperable de uno obsoleto con los datos disponibles, el problema es de diseño de la revisión, no de velocidad del equipo.
Registrar lo necesario para diagnosticar y actuar
Para cada evento, conserva un identificador que permita seguirlo, su tipo, estado, antigüedad, número y hora de los intentos, causa registrada, próxima acción y decisión al expirar. Incluye el sistema de destino cuando haya varias integraciones. Evita guardar datos personales o secretos que no sean necesarios para el diagnóstico; aplica las reglas de acceso y conservación pertinentes.
Estas señales ayudan a distinguir una política demasiado corta de una incidencia externa: proporción de mensajes que se recuperan, tiempo hasta la recuperación, volumen que vence, causas más frecuentes y tamaño y antigüedad de la revisión pendiente. Interpreta los indicadores por tipo de evento. Una tasa alta de reintentos exitosos no justifica ampliar la ventana si los casos recuperados llegan después de perder valor.
Lista de comprobación para acordar la política
- ¿Qué efecto de negocio produce el evento y cuándo deja de ser válido?
- ¿Qué fallos son transitorios, permanentes o ambiguos en cada integración?
- ¿Cuál es la ventana máxima y cómo se comprueba que el evento sigue vigente?
- ¿Qué intervalos y límites evitan presión excesiva y reintentos indefinidos?
- ¿Al expirar, se descarta, se revisa o se compensa? ¿Quién es responsable?
- ¿Qué datos y métricas permiten explicar el resultado y mejorar la política?
La respuesta a cuánto tiempo reintentar mensajes fallidos depende, en definitiva, de cuánto tarda en desaparecer la causa y de cuánto valor conserva la acción durante ese tiempo. Define ventanas por impacto, limita los intentos, trata los errores permanentes de forma distinta y acuerda una salida operativa. Después, revisa los eventos que más vencen o generan intervención: ahí suelen estar las mejores oportunidades para ajustar la clasificación, la integración o el propio proceso.