

Desplegar una aplicación en varias regiones puede parecer una forma directa de reducir interrupciones o acercar el servicio a sus usuarios. Pero distribuir infraestructura también introduce decisiones nuevas: cómo se replican los datos, qué ocurre si una región queda aislada y quién puede operar el conjunto. La pregunta no es cuántas regiones son posibles, sino qué problema concreto resolvería la segunda región y si el equipo puede sostener la solución.
La decisión depende de los objetivos del servicio, sus dependencias y las consecuencias de una interrupción. Una arquitectura sencilla, bien monitorizada y con recuperación probada puede ser más adecuada que una configuración multirregión que nadie ha ensayado. Esta guía propone criterios para comparar alternativas y avanzar de forma gradual.
Qué significa desplegar en una región o en varias
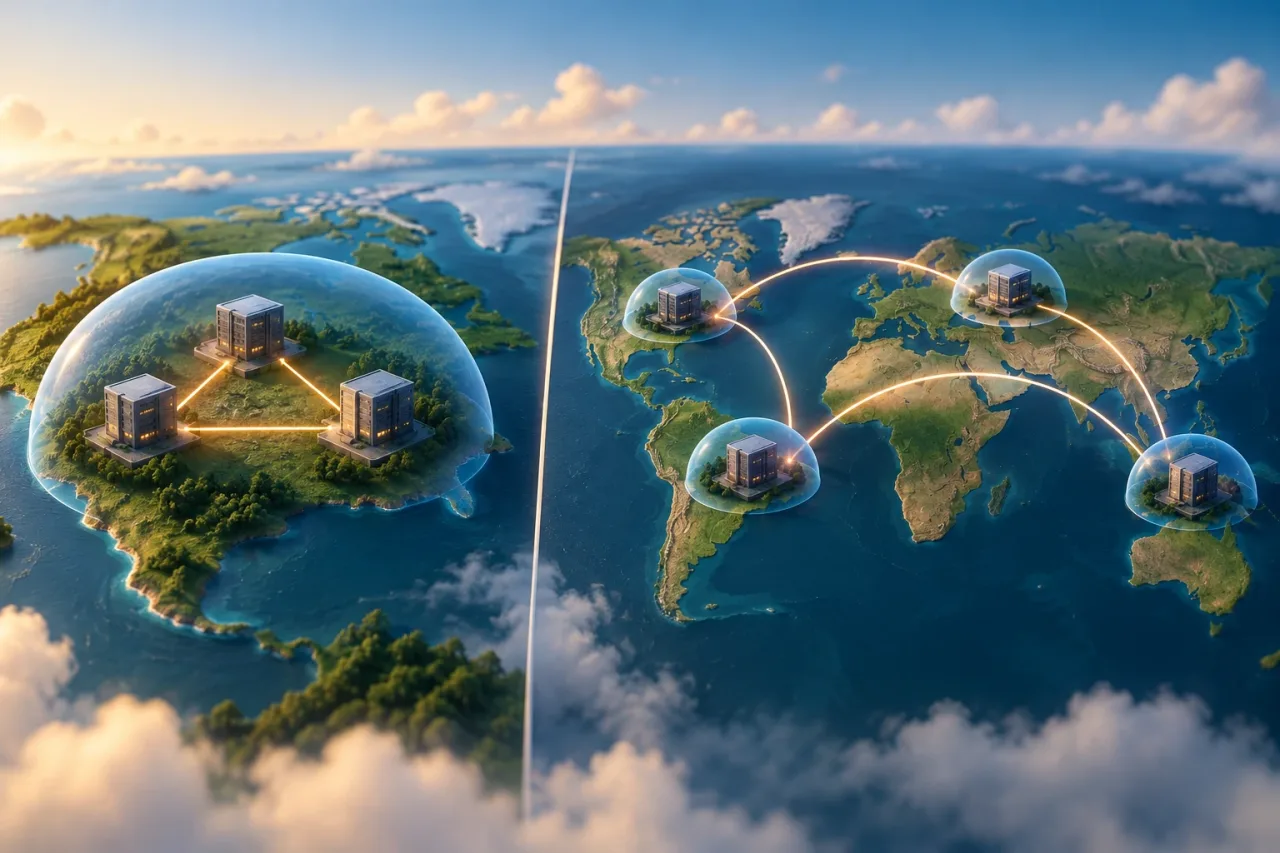
Una región es una ubicación geográfica dentro de la infraestructura en la nube. Una aplicación desplegada en una sola región concentra allí sus componentes principales, aunque estos puedan distribuirse entre distintas zonas de disponibilidad. Varias zonas dentro de una región ayudan frente a ciertos fallos locales, pero no equivalen a tener una segunda región preparada.
En un despliegue multirregión, componentes de la aplicación operan o pueden operar desde ubicaciones geográficas diferentes. La configuración varía: una región puede atender el tráfico habitual y otra permanecer preparada para recuperación; también pueden estar ambas activas y recibir solicitudes. Esas opciones no tienen los mismos requisitos de datos, enrutamiento ni operación.
Conviene definir primero el alcance. Una aplicación puede tener servidores en varias regiones y, aun así, depender de una base de datos, un sistema de identidad o una integración que solo funciona en una. En ese caso, la distribución de la capa de aplicación no implica que el servicio completo pueda continuar ante la pérdida de una región.
Identifica el problema antes de elegir la arquitectura
Las razones más habituales para evaluar varias regiones se agrupan en tres objetivos. Cada uno exige pruebas y decisiones distintas:
- Continuidad: mantener o recuperar el servicio si una región deja de estar disponible. Hay que precisar cuánto tiempo puede durar la interrupción y qué cantidad de datos se podría perder o reconstruir.
- Latencia: reducir el tiempo de respuesta para usuarios geográficamente dispersos. El beneficio depende de dónde estén los usuarios y de si las operaciones críticas pueden atenderse localmente, incluidos los datos y las dependencias.
- Ubicación de datos: cumplir requisitos de residencia, tratamiento o acceso a la información. Alojar copias en distintos lugares puede complicar, no resolver, las obligaciones aplicables; estas deben verificarse para cada tipo de dato.
Formular el objetivo de forma medible evita adoptar una solución por intuición. En continuidad, acuerda objetivos de recuperación para el servicio y sus datos. En latencia, mide las rutas reales de usuario. Para residencia, identifica qué datos deben permanecer en qué ubicación y qué componentes los procesan.
Cuándo puede bastar una región bien operada
Una sola región puede ser suficiente cuando el impacto de una interrupción es asumible, los usuarios están concentrados en una zona o la latencia actual cumple las necesidades del producto. También puede ser la opción más sensata si el equipo todavía no cuenta con procesos para probar y operar una segunda ubicación.
Antes de añadir regiones, revisa las medidas de resiliencia disponibles dentro de la arquitectura actual. Entre ellas pueden estar la redundancia entre zonas, las copias de seguridad, la restauración documentada, la supervisión de dependencias y una estrategia de despliegue reversible. Una copia de seguridad solo aporta protección si se puede restaurar y se ha comprobado que el resultado sirve para recuperar el servicio.
Diagnostica las incidencias y las interrupciones anteriores: ¿se debieron a un fallo regional, a un cambio de software, a una dependencia externa o a un problema de configuración? Si el riesgo principal no es regional, añadir otra ubicación podría aumentar el trabajo sin corregir la causa. Registra también cuánto tardaría una recuperación manual y qué tareas siguen dependiendo de una persona concreta.
Costes y riesgos de distribuir el servicio
La complejidad multirregión no se limita a mantener más recursos. La aplicación puede necesitar decisiones sobre replicación, resolución de conflictos, orden de operaciones y comportamiento durante una pérdida de conectividad. Si dos ubicaciones aceptan cambios sobre la misma información, el diseño debe especificar cuál es la fuente de verdad y cómo se gestionan escrituras simultáneas.
La consistencia es una decisión de producto y de arquitectura. Una demora en replicar información puede hacer que un usuario lea un estado anterior o que dos operaciones entren en conflicto. Puede tolerarse en algunos casos, pero no conviene suponer que todas las funciones admiten ese comportamiento. Define qué acciones exigen una respuesta coherente inmediata y cuáles podrían funcionar temporalmente con datos retrasados.
También hay que revisar dependencias externas, gestión de identidades, colas, almacenamiento, DNS o enrutamiento, observabilidad y procesos de despliegue. Cada elemento puede convertirse en un punto único de fallo o necesitar configuración por región. El gasto operativo incluye pruebas, guardias, análisis de incidentes y mantenimiento de procedimientos, además de la infraestructura.
Evalúa si las rutas críticas pueden funcionar por región
Haz un mapa de las acciones esenciales del usuario, desde la solicitud inicial hasta la confirmación final. Para cada ruta, anota los servicios y datos que intervienen, dónde residen y qué pasa si la región principal deja de responder. La unidad de análisis es el recorrido completo, no un servidor aislado.
- Clasifica las funciones: distingue las imprescindibles para operar de las que pueden degradarse o quedar temporalmente fuera de servicio.
- Traza las dependencias: incluye servicios internos, sistemas externos y procesos operativos que no aparecen en el diagrama de infraestructura.
- Describe el fallo: analiza pérdida total, conectividad parcial y recuperación. Aclara quién detecta el problema y cómo se decide el cambio de tráfico.
- Valida los datos: determina qué escrituras deben estar disponibles, qué retraso es aceptable y cómo se resolverían duplicados o conflictos.
- Comprueba el resultado: verifica que las operaciones visibles para el usuario se completan, no solo que los componentes responden.
Esta revisión revela si existe independencia real entre regiones o si la segunda ubicación depende de recursos que siguen en la primera. También permite priorizar una mejora puntual, como hacer recuperable una dependencia crítica, frente a replicar toda la plataforma.
Región secundaria o servicio activo en varias regiones
Una región secundaria orientada a recuperación suele concentrarse en restablecer el servicio si la principal falla. El equipo debe decidir qué se mantiene preparado, cómo se activa y qué datos estarán disponibles al recuperar. La conmutación puede requerir intervención, por lo que los tiempos reales deben probarse en vez de deducirse del diseño.
Un servicio activo en varias regiones puede atender tráfico desde más de una ubicación de forma habitual. Esto puede favorecer la latencia o la continuidad, pero exige resolver el enrutamiento, la distribución de carga y el comportamiento de los datos entre regiones. No significa necesariamente que todas las operaciones sean independientes ni que el cambio ante un fallo sea automático y correcto.
La elección depende de los objetivos acordados y de la capacidad operativa. Si el servicio tolera una recuperación planificada, una región secundaria puede ser suficiente. Si necesita operar en paralelo para cumplir necesidades de disponibilidad o respuesta, la opción activa puede tener sentido, siempre que sus reglas de datos y sus pruebas sean viables.
Decide con evidencia y avanza de forma incremental
Reúne a producto, tecnología y operación para responder cuatro preguntas: ¿qué impacto tendría una interrupción?, ¿dónde están los usuarios y los datos?, ¿qué recuperación es aceptable? y ¿quién puede operar y probar la arquitectura? Registra supuestos e incertidumbres. Si no hay respuesta para una cuestión crítica, esa falta de información es un riesgo que conviene resolver antes de ampliar el despliegue.
Después, valida la alternativa más pequeña que permita aprender. Puede consistir en medir latencia por ubicación, restaurar una copia en un entorno separado o ensayar la recuperación de una dependencia. Si se prueba una conmutación, define alcance, responsables, condiciones de inicio y criterios de éxito; revisa además cómo volver al estado habitual y cómo reconciliar datos.
Revisa la decisión cuando cambien el perfil de usuarios, los requisitos de datos, el impacto de una interrupción o la composición del servicio. La arquitectura adecuada es la que satisface objetivos explícitos y el equipo puede demostrar que recupera. Varias regiones pueden ser la respuesta, pero no son un objetivo por sí mismas: el valor está en una mejora verificable frente a una alternativa más simple.