

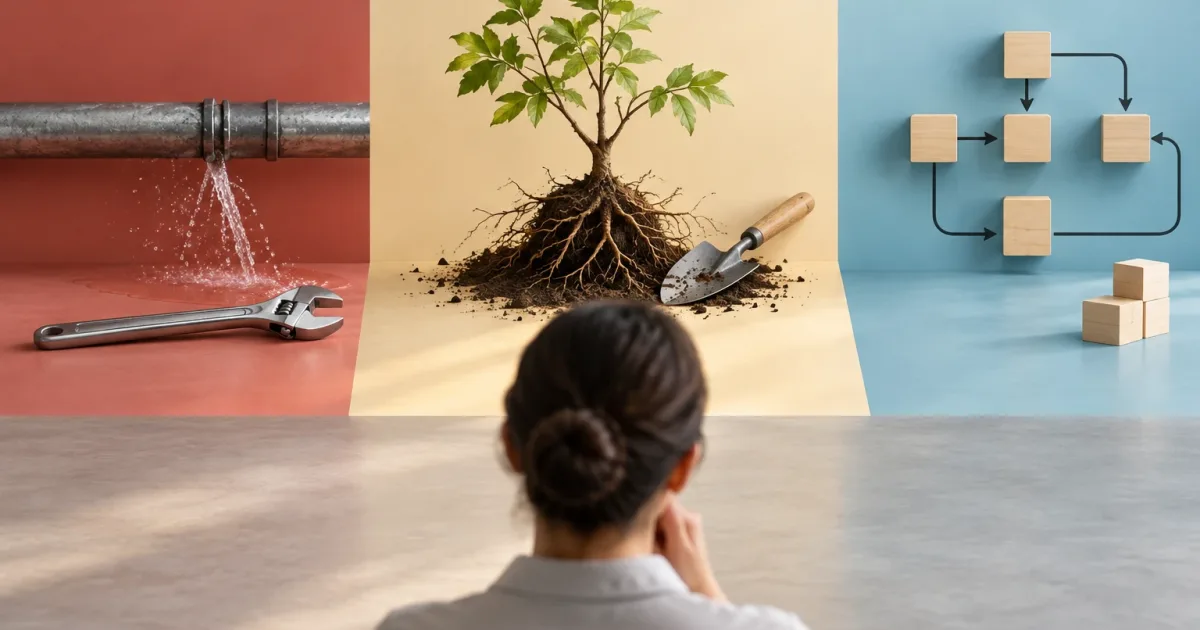
Cuando una incidencia vuelve a aparecer, la respuesta más rápida no siempre es la más adecuada. Corregir el caso puede restablecer el servicio, pero dejar intacta la causa que lo provocó. En el extremo contrario, rediseñar un proceso entero para evitar un problema aislado consume recursos y puede generar nuevos riesgos. La decisión útil depende de distinguir el síntoma, medir el alcance y escoger una intervención proporcional.
Este marco ayuda a responsables de producto, tecnología y operaciones a elegir entre tres respuestas: resolver el caso, eliminar una causa técnica o modificar la forma de trabajar. No hace falta esperar a tener todos los datos: sí conviene registrar lo que se sabe, explicitar las incertidumbres y establecer cómo se comprobará el resultado.
Separar el síntoma de la causa
Una incidencia es el evento visible: una operación queda incompleta, un dato no coincide o una tarea requiere intervención manual. La causa es el mecanismo que hace posible ese resultado. Puede estar en un defecto de software, una integración, una regla ambigua, una excepción mal gestionada o una combinación de factores.
Antes de elegir una solución, describe el problema en términos observables:
- Qué ocurrió: cuál fue el resultado incorrecto o el bloqueo.
- Dónde y cuándo: qué paso, sistema o condición estaba presente.
- A quién o a qué afecta: personas, operaciones, datos o servicios implicados.
- Qué evidencia existe: registros, mensajes, entradas o secuencias reproducibles.
- Qué sigue sin saberse: hipótesis que necesitan comprobación.
Evita convertir la primera explicación plausible en un diagnóstico. Por ejemplo, que una persona haya introducido un dato incorrecto no demuestra que la causa sea un error individual: puede haber una etiqueta confusa, una validación ausente o instrucciones contradictorias. Una buena investigación pregunta qué condiciones permitieron el resultado y no solo quién realizó el último paso.
Clasificar antes de invertir esfuerzo
Evalúa cada incidencia con cuatro criterios. No es necesario crear una puntuación sofisticada al principio; basta con dejar constancia de los criterios y comparar casos de forma coherente.
- Frecuencia: ¿es un caso aislado, se repite en una condición concreta o aparece en distintas partes de la operación?
- Impacto: ¿qué consecuencias tiene sobre clientes, ingresos, cumplimiento, calidad de datos, carga de trabajo o continuidad del servicio?
- Alcance: ¿afecta a una persona o transacción, a un segmento, a varios equipos o a todo el flujo?
- Reversibilidad: ¿se puede deshacer la corrección con seguridad si resulta equivocada? ¿Hay efectos duraderos sobre datos o decisiones posteriores?
Considera también la confianza en el diagnóstico. Una incidencia de gran impacto, pero con causa incierta, puede requerir primero contención y recopilación de evidencia. En cambio, un fallo reproducible y acotado permite evaluar antes una corrección permanente. Separa urgencia de solución definitiva: contener un riesgo de inmediato no obliga a declarar resuelto el problema de fondo.
Cuándo basta una corrección puntual
Una corrección puntual suele ser razonable si el caso es excepcional, el impacto está limitado, la causa parece circunstancial y el resultado se puede reparar de manera segura. Puede consistir en completar una operación, restaurar un valor o aplicar una excepción autorizada. La condición es que la intervención no oculte un patrón ni cree deuda operativa invisible.
Registra cada caso con una categoría común, fecha, contexto, impacto, acción tomada y una referencia a la evidencia disponible. Anota también si la causa está confirmada o sigue siendo una hipótesis. Si cada equipo describe el mismo problema con palabras distintas, será más difícil reconocer recurrencias; una taxonomía breve y compartida ayuda a agruparlas.
Al corregir, comprueba las dependencias: si otros procesos consumen el dato o resultado afectado, una reparación local puede dejar estados incoherentes. Conserva una vía de revisión y especifica quién puede autorizar excepciones. Si el caso se repite, la corrección puntual deja de ser una estrategia suficiente, aunque siga siendo necesaria para atender cada ocurrencia.
Señales de que hace falta eliminar una causa raíz
Busca una solución permanente cuando las incidencias comparten mecanismo, se reproducen bajo condiciones conocidas, generan trabajo manual recurrente o exponen un riesgo que no puede aceptarse. En software, la respuesta puede ser corregir una validación, gestionar correctamente una respuesta inesperada o reforzar una integración. En operaciones, puede consistir en aclarar una regla o evitar una transición que permita datos incompletos.
Una intervención permanente debe corresponder a una causa comprobada, no solo al síntoma más frecuente. Antes de implementarla, define:
- La hipótesis causal y la evidencia que la respalda.
- El cambio mínimo capaz de impedir o detectar el fallo.
- Los flujos, datos y usuarios que podrían verse afectados.
- Una prueba del caso original y de escenarios cercanos que no deberían romperse.
- Un mecanismo de reversión o contención si aparecen efectos secundarios.
Si todavía no puedes explicar por qué ocurre, invierte primero en observabilidad o reproducción. Añadir una alerta puede ayudar a detectar el problema, pero no equivale a eliminarlo. Del mismo modo, un cambio de código que impide un caso concreto podría ocultar una regla de negocio mal definida. La solución debe cubrir el comportamiento esperado, incluidos los límites y excepciones relevantes.
Cuándo cambiar el proceso, no solo el sistema
El origen puede estar en las reglas, las responsabilidades o la secuencia de trabajo. Sospecha de un problema de proceso si distintas herramientas muestran el mismo fallo, si cada equipo aplica una interpretación diferente, si las excepciones dependen de conocimiento informal o si el error aparece en un traspaso entre áreas.
En ese caso, revisa quién decide, quién ejecuta y quién verifica cada paso. Aclara las condiciones de entrada y salida, elimina duplicidades y especifica qué hacer cuando una condición no se cumple. No conviertas toda variación en un formulario o una aprobación adicional: cada control también cuesta tiempo y puede desplazar el problema. Consulta a las personas que realizan el trabajo, porque suelen conocer las excepciones que un diagrama formal no refleja.
Los cambios de proceso requieren comunicación y seguimiento, no solo documentación. Prueba la nueva forma de trabajar con un flujo acotado cuando sea viable, recoge dudas y ajusta instrucciones antes de extenderla. Si el proceso necesita pasos manuales para compensar una limitación técnica, registra esa dependencia: puede ser una decisión temporal, pero debe tener responsable y criterio de revisión.
Matriz de decisión y revisión del resultado
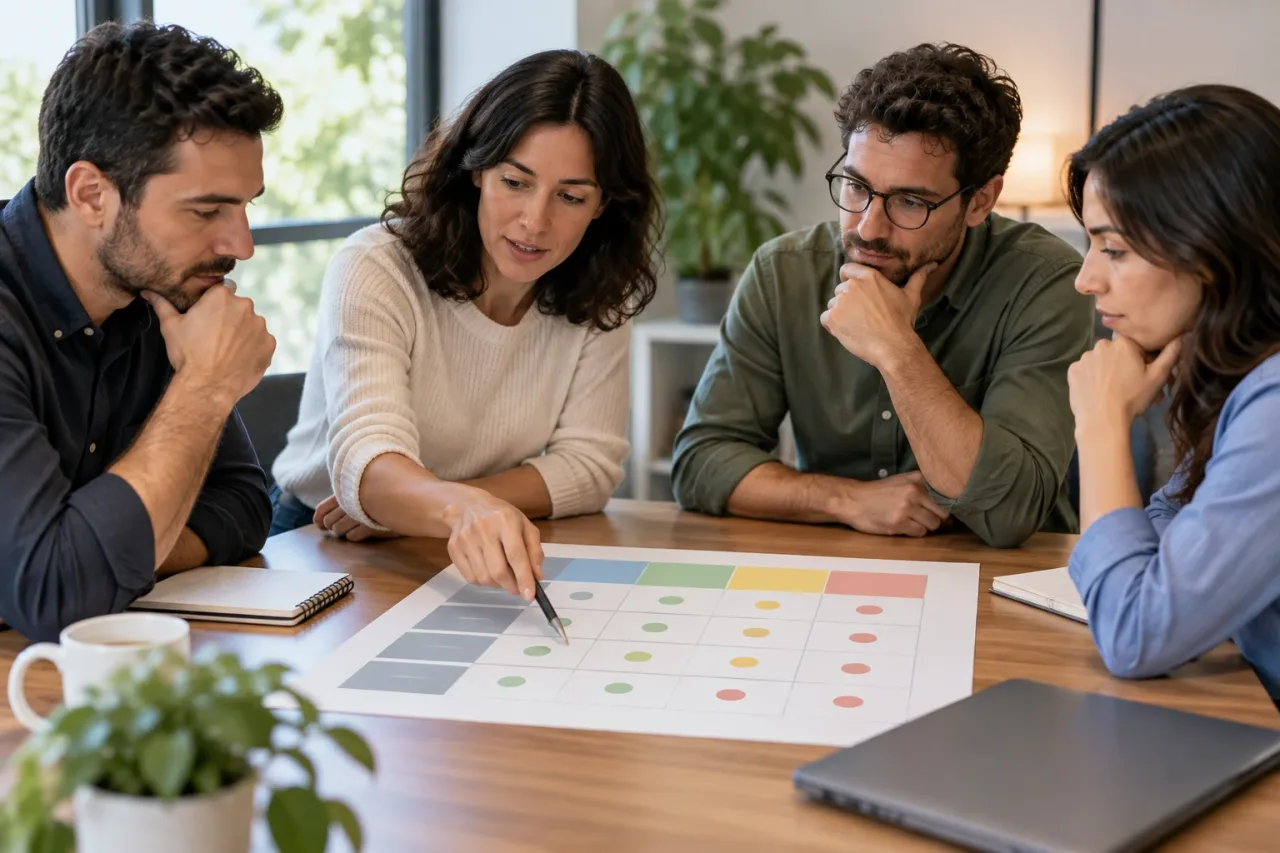
La siguiente matriz sirve como punto de partida, no como sustituto del juicio del equipo. Los ejemplos son hipotéticos y deben validarse con el contexto real.
- Un caso aislado, impacto bajo y reparación reversible: corrige el caso y registra el contexto para detectar repeticiones.
- Patrón reproducible en un sistema o integración, con alcance conocido: contiene el efecto y prioriza eliminar la causa técnica, incluyendo pruebas de regresión.
- Resultados distintos según el equipo o un paso ambiguo: revisa la regla, las responsabilidades y la secuencia antes de automatizar la respuesta.
- Impacto alto o datos difíciles de restaurar, con causa incierta: limita la exposición, escala la investigación y evita cambios irreversibles hasta entender las dependencias.
Define antes del cambio qué señal confirmará una mejora: menos casos de la misma categoría, menos correcciones manuales, menor tiempo de resolución o menos operaciones afectadas. Usa una ventana de observación adecuada al ritmo del proceso y compara condiciones equivalentes; una caída temporal puede deberse a menor actividad, no a la solución.
Revisa también señales de daño colateral: rechazos legítimos, errores nuevos, demoras, traspasos adicionales o más excepciones. Si la recurrencia baja pero el trabajo manual aumenta, la medida quizá trasladó el coste en lugar de resolverlo. Decide entonces mantenerla, ajustarla o retirarla, y deja constancia de la decisión. Una revisión periódica de incidencias agrupadas permite detectar cuándo una corrección puntual se ha convertido en un patrón y merece una respuesta de mayor alcance.
En síntesis, resuelve el caso cuando sea excepcional y controlable, elimina la causa cuando el mecanismo esté identificado y cambia el proceso cuando las reglas o los traspasos sean el origen. Si el diagnóstico aún es débil, contiene el riesgo y reúne evidencia antes de comprometer una solución difícil de revertir.