

Conectar un CRM, un ERP, un ecommerce y aplicaciones propias plantea una pregunta aparentemente sencilla: ¿cómo sabemos que dos registros representan a la misma entidad? La respuesta no puede basarse por defecto en un nombre, un correo electrónico o una referencia visible. Esos valores cambian, pueden repetirse y suelen tener reglas distintas en cada sistema.
Una decisión deficiente sobre identificadores provoca duplicados, actualizaciones aplicadas al registro equivocado, pedidos sin cliente asociado y conciliaciones manuales que se cronifican. Una decisión sólida no consiste en encontrar un identificador universal mágico, sino en definir qué sistema reconoce a qué entidad, con qué clave, durante cuánto tiempo y bajo qué reglas de cambio.
Este marco ayuda a escoger entre IDs internos, referencias de negocio, IDs externos y tablas de correspondencia sin exponer información innecesaria ni acoplar sistemas de forma frágil.
Por qué los campos visibles no resuelven la identidad
El nombre de una empresa puede escribirse de varias maneras, cambiar tras una fusión o ser compartido por organizaciones diferentes. El nombre de una persona tiene aún más colisiones. El correo electrónico puede modificarse, reutilizarse, pertenecer a una cuenta compartida o faltar en determinados flujos. Incluso una referencia comercial puede ser única solo dentro de una filial, un canal o un periodo.
Estos campos siguen siendo útiles para buscar, mostrar y proponer coincidencias, pero rara vez deben ser la clave técnica de una integración. La distinción importante es la siguiente:
- Identidad: el registro concreto que un sistema considera una entidad.
- Atributos: datos que describen esa entidad, como nombre, correo, teléfono o dirección.
- Referencia de negocio: un código que tiene significado operativo, como un número de pedido o un código de cliente.
Confundir estas capas es un origen frecuente de errores. Por ejemplo, una dirección no identifica necesariamente a un cliente: una misma persona puede tener varias direcciones y varias personas pueden compartir una. Del mismo modo, un pedido identifica una transacción, no al comprador de manera permanente.
Tipos de identificador y para qué sirve cada uno
Antes de diseñar mensajes o endpoints, conviene clasificar las claves disponibles. Cada tipo tiene ventajas y límites.
- ID interno: clave generada y controlada por un sistema, normalmente estable y sin significado de negocio. Es la mejor opción para operar dentro de su propio dominio.
- Referencia de negocio: código legible u operativo, como una referencia de pedido. Facilita soporte y conciliación, pero puede cambiar de formato, reiniciarse por serie o reutilizarse.
- ID externo: identificador que un sistema receptor guarda para recordar el registro de un sistema emisor. Es útil cuando existe una relación clara de procedencia.
- Identificador compuesto: combinación de valores, por ejemplo
origen + tipo de entidad + id. Es imprescindible cuando un ID solo es único dentro de un sistema. - Identificador temporal: clave de correlación para un proceso todavía no consolidado. Debe expirar y no convertirse accidentalmente en identidad permanente.
Una regla práctica es conservar el ID interno de cada aplicación como autoridad local. Cuando se intercambian datos, el identificador mínimo seguro suele ser un valor con espacio de nombres explícito. Por ejemplo:
{
  "entity_type": "customer",
  "source_system": "ecommerce",
  "source_id": "C-48291"
}
El valor C-48291 por sí solo no es necesariamente globalmente único. El contexto de origen evita que otro sistema interprete una coincidencia textual como una identidad compartida.
Preguntas que deben responderse antes de compartir un ID
No elija una clave por comodidad de implementación. Decida primero el modelo de propiedad y ciclo de vida. Estas preguntas revelan si un identificador es apto para viajar entre sistemas:
- ¿Qué sistema crea la entidad y cuál es la fuente de verdad de cada atributo?
- ¿El valor es único en toda la organización o solo dentro de una aplicación, país, canal o tipo de entidad?
- ¿Puede cambiar? Si cambia, ¿se conserva el valor anterior y se publica el evento?
- ¿Puede reutilizarse después de una baja, una cancelación o un periodo de retención?
- ¿Contiene datos personales, información comercial sensible o patrones fáciles de adivinar?
- ¿Un registro puede fusionarse con otro o dividirse en varios?
- ¿Qué comportamiento debe tener el receptor cuando no encuentra una correspondencia?
Un ID compartido debe ser estable, único en su contexto, no reutilizable y suficientemente opaco para el uso previsto. Si una referencia de negocio no cumple esas condiciones, úsela como atributo verificable, no como clave de actualización.
También hay que separar la identidad técnica de la autorización. Conocer un identificador no debe permitir leer o modificar una entidad. Las APIs deben validar que quien llama tiene permiso para operar sobre ese recurso y evitar IDs predecibles como único mecanismo de protección.
Cuándo propagar el ID de origen y cuándo usar una tabla de correspondencias
Propagar el ID de origen es razonable cuando una entidad nace en un sistema claramente autoritativo y los demás sistemas solo necesitan reconocerla. Por ejemplo, el ecommerce puede crear un pedido y el ERP puede almacenar el identificador del pedido de ecommerce como referencia externa. Este patrón reduce ambigüedad y permite rastrear la procedencia.
Sin embargo, no todos los dominios tienen una autoridad única. Un cliente puede entrar por ventas, ecommerce, soporte o importaciones históricas. En esos casos, imponer el ID de uno de los sistemas como clave universal crea dependencia y puede convertir una migración futura en un proyecto de alto riesgo.
Una tabla de correspondencias es preferible cuando hay varios sistemas maestros, consolidación gradual, fusiones de registros o reglas de identidad complejas. Debe guardar al menos el tipo de entidad, sistema, ID local, ID canónico si existe, estado del vínculo, fecha de creación y evidencia o regla que justificó la relación.
Evite una tabla que solo relacione dos columnas sin contexto. El mismo valor puede existir para tipos distintos, y un vínculo puede ser confirmado, provisional, rechazado o sustituido tras una fusión. Trate ese mapeo como un dato operativo con auditoría, no como una configuración invisible en código.
Altas, duplicados y fusiones: diseñar para los casos incómodos
Cuando llega una alta sin identificador común, el receptor no debería asumir que es una entidad nueva ni que una coincidencia por correo es definitiva. Debe aplicar una política explícita:
- Crear un registro nuevo y dejarlo sin vincular cuando no hay evidencia suficiente.
- Proponer una coincidencia cuando varios atributos consistentes superan un umbral definido por negocio.
- Exigir revisión humana para unir registros con consecuencias financieras, contractuales o de atención al cliente.
- Registrar la decisión, la regla aplicada y los IDs implicados.
La deduplicación automática es especialmente riesgosa cuando el coste de una unión incorrecta supera el de mantener dos registros pendientes. Combinar por error dos clientes puede mezclar facturas, consentimientos o comunicaciones. En cambio, un duplicado detectado puede resolverse con una cola de revisión.
Las fusiones requieren una semántica propia. Defina un registro superviviente, conserve los IDs históricos como alias o redirecciones y publique el cambio para que los sistemas consumidores actualicen sus vínculos. No elimine de inmediato el ID absorbido: los procesos asíncronos, reintentos y registros históricos pueden seguir refiriéndose a él.
Cambios, bajas y reactivaciones sin romper la trazabilidad
Un identificador técnico idealmente no cambia. Si una referencia de negocio debe cambiar, el evento debe comunicar tanto el valor previo como el nuevo y explicar la causa. Nunca interprete el silencio como una baja: pueden existir retrasos, fallos de entrega o filtros de sincronización.
Para bajas, utilice estados explícitos como activo, inactivo, cancelado, eliminado o fusionado, según el dominio. La eliminación física puede ser necesaria por requisitos de privacidad, pero debe diseñarse junto con la trazabilidad: quizá sea posible conservar un marcador técnico no identificable o una evidencia de que un vínculo ya no debe recrearse.
No reutilice referencias que ya se hayan emitido, aunque el registro esté inactivo. La reutilización transforma datos históricos correctos en ambigüedad futura. Si una reactivación representa a la misma entidad, mantenga el ID; si representa una entidad nueva, asigne uno nuevo y documente la relación solo si aporta valor operativo.
Diseño de APIs, mensajes y controles operativos
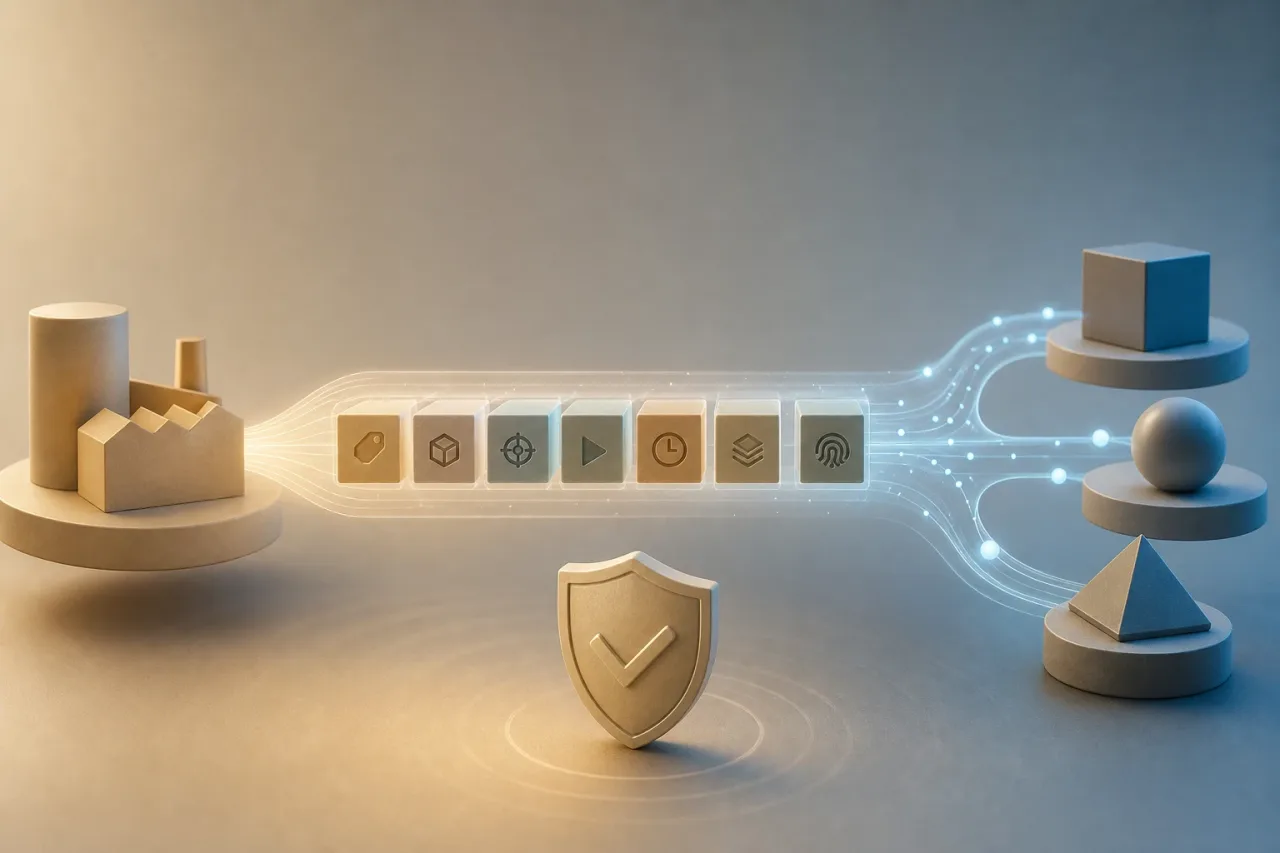
Un contrato de integración debe transportar contexto suficiente, pero no más datos de los necesarios. Incluya tipo de entidad, sistema de origen, ID de origen, operación, marca temporal, versión o secuencia cuando aplique, y un identificador de evento para manejar reintentos. La idempotencia evita crear varias veces la misma entidad cuando una entrega se repite.
Para actualizaciones, priorice una operación que indique claramente la clave utilizada. Si se permite buscar por referencia de negocio, trate el resultado múltiple como error controlado, no como una invitación a elegir el primer registro.
Los controles operativos deben convertir los problemas de identidad en señales visibles:
- alertas de coincidencias ambiguas y mensajes sin correspondencia;
- colas para vínculos pendientes y revisiones de fusión;
- métricas de duplicados creados, enlaces rotos y errores recurrentes por sistema;
- reconciliaciones periódicas entre conteos, estados y vínculos esperados;
- logs que incluyan IDs técnicos y de correlación, sin exponer atributos personales innecesarios.
Antes de construir, documente para cada entidad su sistema autoritativo, ID local, claves externas aceptadas, reglas de unicidad, política de cambios, estados de baja y estrategia de deduplicación. Esa decisión reduce acoplamiento hoy y hace que una futura migración, auditoría o incorporación de un canal nuevo sea manejable.